
使用webmagic爬虫对百度百科进行简单的爬取
分析要爬取的网页源码:
1、打开要分析的网页,查看源代码,找到要爬取的内容:
(选择网页里的一部分右击审查元素也行)
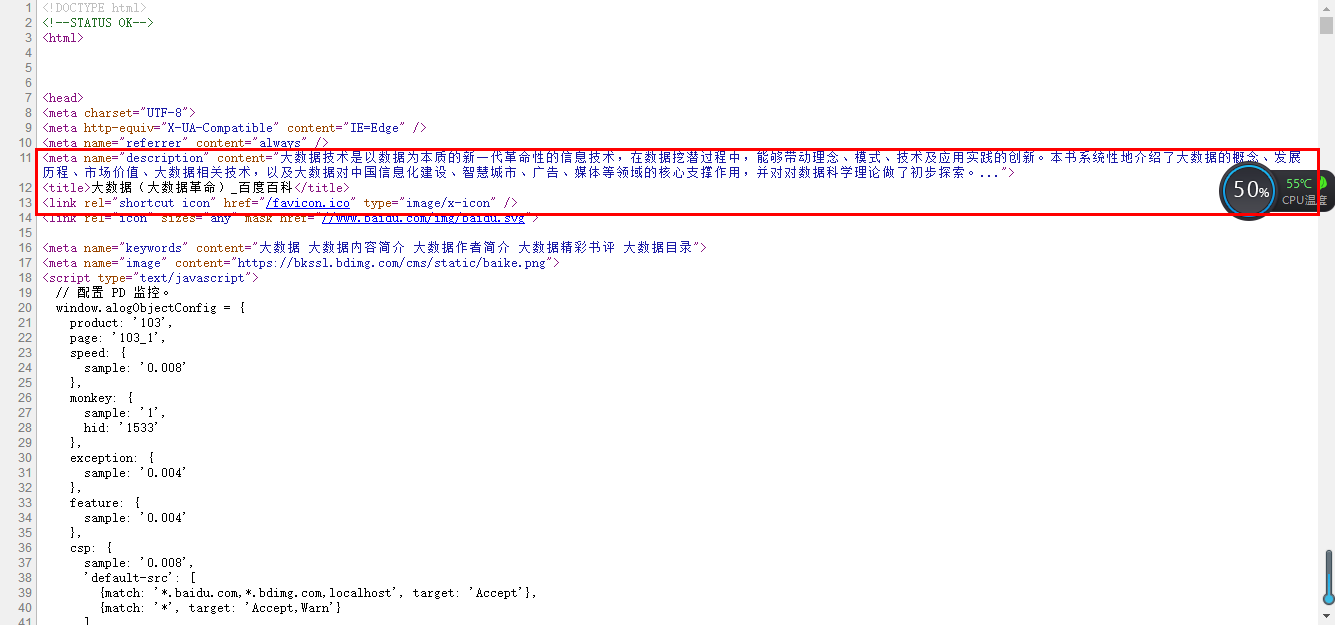
2、导入jar包,这个就直接去网上下吧;
3、写爬虫:
 package com.gb.pachong;

 import java.sql.SQLException;

 import com.gb.util.AddNum;

 import us.codecraft.webmagic.Page;

 import us.codecraft.webmagic.Site;

 import us.codecraft.webmagic.Spider;

 import us.codecraft.webmagic.processor.PageProcessor;

 public class BaikePaChong implements PageProcessor

 {

     private static String key;

     public static String res=null;

     // 抓取网站的相关配置,包括编码、重试次数、抓取间隔

     private Site site = Site.me().setRetryTimes(3).setSleepTime(1000);

     public void run(String key)

     {

         this.key = key;

         //addUrl就是种子url,Page对象就是当前获取的页面,getUrl()可以获得当前url,addTargetRequests()就是把链接放入等待爬取,getHtml()获得页面的html元素

         //启动爬虫

         Spider.create(new BaikePaChong()).addUrl("https://baike.baidu.com/item/" + key).thread(5).run();

     }

     @Override

     public Site getSite()

     {

         return site;

     }

     @Override

     public void process(Page page)

     {

         //获取页面内容

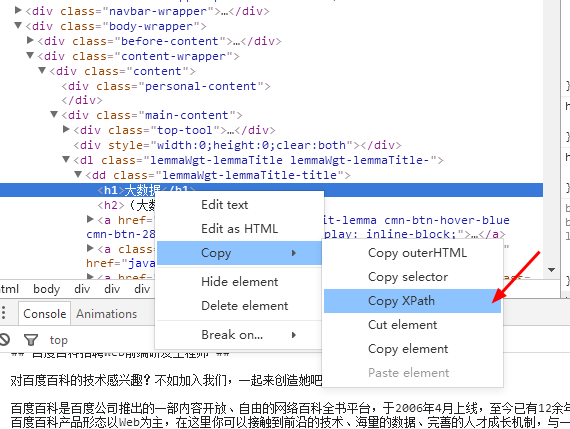
         res = page.getHtml().xpath("//meta[@name='description']/@content").toString();

         //把包含数据添加到数据库的方法的类实例化成对象

         AddNum addNum=new AddNum();

         try

         {

             //数据添加进数据库

             addNum.store(key, res);

         }

         catch (SQLException e)

         {

             e.printStackTrace();

         }

     }

     public void search(String string)

     {

         BaikePaChong baikePaChong = new BaikePaChong();

         baikePaChong.run(string);

     }

     public String getRes()

     {

         return res;

     }

 }
4、上面只是简单的爬取,可以仿照这样的方法进行一些别样的扩展使用。
5、Xpath可以在这里直接复制:
使用webmagic爬虫对百度百科进行简单的爬取的更多相关文章
- Python爬虫学习(5): 简单的爬取
学习了urllib,urlib2以及正则表达式之后就可以做一些简单的抓取以及处理工作.为了抓取方便,这里选择糗事百科的网页作为抓取对象. 1. 获取数据: In [293]: url = " ...
- 爬虫系列(六) 用urllib和re爬取百度贴吧
这篇文章我们将使用 urllib 和 re 模块爬取百度贴吧,并使用三种文件格式存储数据,下面先贴上最终的效果图 1.网页分析 (1)准备工作 首先我们使用 Chrome 浏览器打开 百度贴吧,在输入 ...
- 爬虫系列(十一) 用requests和xpath爬取豆瓣电影评论
这篇文章,我们继续利用 requests 和 xpath 爬取豆瓣电影的短评,下面还是先贴上效果图: 1.网页分析 (1)翻页 我们还是使用 Chrome 浏览器打开豆瓣电影中某一部电影的评论进行分析 ...
- web scraper——简单的爬取数据【二】
web scraper——安装[一] 在上文中我们已经安装好了web scraper现在我们来进行简单的爬取,就来爬取百度的实时热点吧. http://top.baidu.com/buzz?b=1&a ...
- 爬虫系列(十) 用requests和xpath爬取豆瓣电影
这篇文章我们将使用 requests 和 xpath 爬取豆瓣电影 Top250,下面先贴上最终的效果图: 1.网页分析 (1)分析 URL 规律 我们首先使用 Chrome 浏览器打开 豆瓣电影 T ...
- 爬虫概念与编程学习之如何爬取视频网站页面(用HttpClient)(二)
先看,前一期博客,理清好思路. 爬虫概念与编程学习之如何爬取网页源代码(一) 不多说,直接上代码. 编写代码 运行 <!DOCTYPE html><html><head& ...
- Python爬虫入门教程:豆瓣Top电影爬取
基本开发环境 Python 3.6 Pycharm 相关模块的使用 requests parsel csv 安装Python并添加到环境变量,pip安装需要的相关模块即可. 爬虫基本思路 一. ...
- 爬虫入门(三)——动态网页爬取:爬取pexel上的图片
Pexel上有大量精美的图片,没事总想看看有什么好看的自己保存到电脑里可能会很有用 但是一个一个保存当然太麻烦了 所以不如我们写个爬虫吧(๑•̀ㅂ•́)و✧ 一开始学习爬虫的时候希望爬取pexel上的 ...
- Python爬虫之简单的爬取百度贴吧数据
首先要使用的第类库有 urllib下的request 以及urllib下的parse 以及 time包 random包 之后我们定义一个名叫BaiduSpider类用来爬取信息 属性有 url: ...
随机推荐
- 用Python语言开发VTK程序的步骤
在Windows环境下用Python语言开发VTK程序 1.安装Python集成开发环境IDLE:下载地址:https://www.python.org/downloads/ 2.然后到VTK官网下载 ...
- #实验三 敏捷开发与XP实践---实验报告
一.实验三 敏捷开发与XP实践-1 1.实验要求 -实验三 敏捷开发与XP实践 http://www.cnblogs.com/rocedu/p/4795776.html, Eclipse的内容替换成I ...
- 《Linux就该这么学》第十天课程
使用RAID与LVM磁盘阵列技术 有RAID 0,RAID 1,,RAID 5,RAID 1 0等,下面列举RAID的各个概况 1. RAID 0 RAID 0技术把多块物理硬盘设备(至少两块)通过硬 ...
- JavaScript中的Undefined / Null 类型相关说明
1,综述: ※Undefined 和 Null是JavaScript中的两种数据类型(其他的类型还有:Boolean, String, Number, Object). ※Undefined类型只有一 ...
- 数据库的Connection、Cursor两大对象
Python 数据库图解流程 Connection.Cursor比喻 Connection()的参数列表 host,连接的数据库服务器主机名,默认为本地主机(localhost). user,连接数据 ...
- index.php入口文件至根目录
登录|注册 咖啡如同生活的专栏 从不羡慕别人的优秀,因为相信自己也可以优秀. 闲下来时看看书,书本里的故事,总有你学到的人生. 目录视图 摘要视图 订阅 异步赠书:9月重磅 ...
- linux之Ubuntu学习
开始学习Linux系统是在通过虚拟机VMware上安装Ubuntu操作系统来学习的. 一.Ubuntu安装及使用 第一步:安装虚拟机VMware 第二步:虚拟机安装好之后,创建一个新的虚拟机,安装Ub ...
- EF学习笔记(八):更新关联数据
学习笔记主目录链接:ASP.NET MVC5 及 EF6 学习笔记 - (目录整理) 上一篇链接:EF学习笔记(七):读取关联数据 本篇原文链接:Updating Related Data 本篇主要考 ...
- Python爬虫的学习经历
在准备学习人工智能之前呢,我看了一下大体的学习纲领.发现排在前面的是PYTHON的基础知识和爬虫相关的知识,再者就是相关的数学算法与金融分析.不过想来也是,如果想进行大量的数据运算与分析,宏大的基础数 ...
- 29.vector
对于List接口这里还介绍一个它的实现类Vector,Vector 类可以实现可增长的对象数组. Vector可以实现可增长的对象数组.与数组一样,它包含可以使用整数索引进行访问的组件.不过,Vect ...