
Python爬虫入门教程 58-100 python爬虫高级技术之验证码篇4-极验证识别技术之一
@
验证码类型
今天要搞定的验证码属于现在使用非常多的验证码的一种类型---极验证滑动验证码,关于这个验证码的详细说明查阅他的官网,https://www.geetest.com/ 把验证码做到这个地步,必须点赞了。
官网最新效果
官方DEMO最新的效果如下,按照验证码的更新频率,基本博客看完,验证码也更新了,不过套路依旧是相同的,反爬只能增加爬虫编写的成本,并不能完全杜绝爬虫。
这类验证码,常规解决办法,模拟人为操作,图像比对,查找缺口,移动覆盖缺口。
找个用极验证的网站
今天看新闻,随意找了一下,虎嗅使用的是直接拖拽,没有用最新的点击+拖拽方式,可以直接看一下如何操作。
这种验证码除了打码平台以外,直接selenium搞起
拼接验证码图片
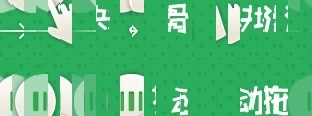
当你在谷歌浏览器使用F12进行查找元素的时候,随意的去缺口图片上面点击一下,在控制台DOM结构中出现如下代码,有前端经验的童鞋知道,这个使用的是背景局部显示技术,是可以通过这个拼接成一个。
注意两个地方:
- https://static.geetest.com/pictures/gt/8bc4cb7fa/8bc4cb7fa.webp 图片地址
- background-position:后面的坐标
查阅图片之后,发现是一张碎掉的图片,你要做的第一步是将这个图片进行还原,我们通过selenium进行实现。这个地方需要先备注一下图片的尺寸,后面用size =312x116
编写自动化代码
使用selenium执行的操作,模拟人的点击行为即可
最初,我们导入一些selenium的基本模块与方法
import time

import re

from selenium import webdriver

from selenium.common.exceptions import TimeoutException

from selenium.webdriver.common.by import By

from selenium.webdriver.support.wait import WebDriverWait

from selenium.webdriver.support import expected_conditions as EC

from selenium.webdriver.common.action_chains import ActionChains
基本模块的作用如下
webdriver 核心驱动
selenium.common.exceptions 异常类 TimeoutException 超时异常
selenium.webdriver.common.by 按照什么方式进行元素的查找 例如 By.ID,By.ClassName,By.XPATH
selenium.webdriver.support.wait 等待页面加载某些元素
from selenium.webdriver.support import expected_conditions 场景判断用的,一般和上面的等待加载元素一起使用
selenium.webdriver.common.action_chains 鼠标执行的动作链
主方法测试入口
if __name__ == '__main__':

    h = Geek_Huxiu()

    h.run()
构造方法,实现对部分参数的初始化操作
    def __init__(self):

        self.driver = webdriver.Chrome()

        self.driver.set_window_size(1366,768)
webdriver.Chrome() 启动谷歌浏览器,这个地方需要你提前配置好chromedriver.exe
set_window_size(1366,768) 初始化浏览器大小
核心run方法
    def run(self):

        self.driver.get("https://www.huxiu.com/")  # 打开浏览器

        WebDriverWait(self.driver,10).until(EC.element_to_be_clickable((By.XPATH,'//*[@class="js-register"]')))

        reg_element = self.driver.find_element_by_xpath('//*[@class="js-register"]')

        reg_element.click()

        WebDriverWait(self.driver,10).until(EC.element_to_be_clickable((By.XPATH,'//div[@class="gt_slider_knob gt_show"]')))

        # 模拟拖动

        self.analog_drag()
WebDriverWait 方法
说明
driver: 传入WebDriver实例,即我们上例中的driver

timeout: 超时时间,等待的最长时间(同时要考虑隐性等待时间)

poll_frequency: 调用until或until_not中的方法的间隔时间,默认是0.5秒

ignored_exceptions: 忽略的异常,如果在调用until或until_not的过程中抛出这个元组中的异常, 则不中断代码,继续等待;

如果抛出的是这个元组外的异常,则中断代码,抛出异常。默认只有NoSuchElementException。
基本使用方法
WebDriverWait(driver, 超时时长, 调用频率, 忽略异常).until(可执行方法, 超时时返回的信息)
模拟拖动方法
    def analog_drag(self):

        # 鼠标移动到拖动按钮,显示出拖动图片

        element = self.driver.find_element_by_xpath('//div[@class="gt_slider_knob gt_show"]')

        ActionChains(self.driver).move_to_element(element).perform()

        time.sleep(3)

        # 刷新一下极验证图片

        element = self.driver.find_element_by_xpath('//a[@class="gt_refresh_button"]')

        element.click()

        time.sleep(1)

        # 获取图片地址和位置坐标列表

        cut_image_url,cut_location = self.get_image_url('//div[@class="gt_cut_bg_slice"]')

        print(cut_image_url)

        print(cut_location)
行为链
ActionChains(self.driver).move_to_element(element).perform()
模拟人移动鼠标到指定DOM元素
图片处理方法
    def get_image_url(self,xpath):

        link = re.compile('background-image: url\("(.*?)"\); background-position: (.*?)px (.*?)px;')

        elements = self.driver.find_elements_by_xpath(xpath)

        image_url = None

        location = list()

        for element in elements:

            style = element.get_attribute('style')

            groups = link.search(style)

            url = groups[1]

            x_pos = groups[2]

            y_pos = groups[3]

            location.append((int(x_pos), int(y_pos)))

            if not image_url:

                image_url = url

        return image_url, location
使用正则表达式进行匹配的时候,需要将所有的DIV匹配出来 ,采用find_elements_by_xpath 方法,尤其注意elements
WebElement 具备一些常用的方法和属性
- size:返回元素尺寸
- text :返回元素文本
- get_attribute(name):获得属性值
- is_dispalyed() :该元素是否用户可见
初步运行结果
拼接图
看下图,注意一些基本元素,拼接的图片由N个小矩形构成,分为上下两个部分,小矩形的宽度和高度为10x58
核心由上下两部分构成,每部分都是26个小矩形
因为,整体宽度为2610 = 260px ,整体高度为582=116px
但是,还记得博客开始的时候,你记录的那个宽度和高度么? 312x116 高度一致,但是宽度出现偏差
312-260 = 52px
52个像素去除以26个矩形,发现每个矩形差2px,这两个像素也就是下面我们拼接图片的重点了
    def splicing_image(self,image_url,location):

        res = requests.get(image_url)

        file = BytesIO(res.content)

        img = Image.open(file)

        image_upper = []

        image_down = []

        for pos in location:

            if pos[1] == 0:

                # y值为0的坐标  属于图片上半部分,高度58

                image_upper.append(img.crop((abs(pos[0]), 0, abs(pos[0]) + 10, 58)))

            else:

                # y值为58的坐标 属于图片上半部分,高度58

                image_down.append(img.crop((abs(pos[0]), 58, abs(pos[0]) + 10, img.height)))

		# 画布的x轴偏移量

        x_offset = 0

        # 创建一张画布

        new_img = Image.new("RGB", (260, img.height))

        for img in image_upper:

            new_img.paste(img, (x_offset, 58))

            x_offset += img.width

        x_offset = 0

        for img in image_down:

            new_img.paste(img, (x_offset, 0))

            x_offset += img.width

        return new_img
说明
- requests.get(image_url) 下载图片到本地
- BytesIO(res.content) 将字节转换成二进制文件流
- Image.open(file) 获取图片
- img.crop 裁切图片 left, upper, right, lower
- Image.new("RGB", (260, img.height)) 创建一个空白的图片,将图片序列中的元素,依次的拼接到里面
最终实现效果
图片存储到本地
        # 将图片存储到本地

        cut_image.save("cut.jpg")

        full_image.save("full.jpg")
好了,今天博客就先把图片处理到位,明天着手拼接部分。
欢迎关注「非本科程序员」 回复 【0412】获取本篇博客源码
Python爬虫入门教程 58-100 python爬虫高级技术之验证码篇4-极验证识别技术之一的更多相关文章
- Python爬虫入门教程 56-100 python爬虫高级技术之验证码篇2-开放平台OCR技术
今日的验证码之旅 今天你要学习的验证码采用通过第三方AI平台开放的OCR接口实现,OCR文字识别技术目前已经比较成熟了,而且第三方比较多,今天采用的是百度的. 注册百度AI平台 官方网址:http:/ ...
- Python爬虫入门教程 61-100 写个爬虫碰到反爬了,动手破坏它!
python3爬虫遇到了反爬 当你兴冲冲的打开一个网页,发现里面的资源好棒,能批量下载就好了,然后感谢写个爬虫down一下,结果,一顿操作之后,发现网站竟然有反爬措施,尴尬了. 接下来的几篇文章,我们 ...
- Python爬虫入门教程 48-100 使用mitmdump抓取手机惠农APP-手机APP爬虫部分
1. 爬取前的分析 mitmdump是mitmproxy的命令行接口,比Fiddler.Charles等工具方便的地方是它可以对接Python脚本. 有了它我们可以不用手动截获和分析HTTP请求和响应 ...
- Python爬虫入门教程 43-100 百思不得姐APP数据-手机APP爬虫部分
1. Python爬虫入门教程 爬取背景 2019年1月10日深夜,打开了百思不得姐APP,想了一下是否可以爬呢?不自觉的安装到了夜神模拟器里面.这个APP还是比较有名和有意思的. 下面是百思不得姐的 ...
- Python爬虫入门教程 37-100 云沃客项目外包网数据爬虫 scrapy
爬前叨叨 2019年开始了,今年计划写一整年的博客呢~,第一篇博客写一下 一个外包网站的爬虫,万一你从这个外包网站弄点外快呢,呵呵哒 数据分析 官方网址为 https://www.clouderwor ...
- Python爬虫入门教程 36-100 酷安网全站应用爬虫 scrapy
爬前叨叨 2018年就要结束了,还有4天,就要开始写2019年的教程了,没啥感动的,一年就这么过去了,今天要爬取一个网站叫做酷安,是一个应用商店,大家可以尝试从手机APP爬取,不过爬取APP的博客,我 ...
- Python爬虫入门四之Urllib库的高级用法
1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性. 首先,打开我们的浏览 ...
- 转 Python爬虫入门四之Urllib库的高级用法
静觅 » Python爬虫入门四之Urllib库的高级用法 1.设置Headers 有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我 ...
- 2019-03-22 Python Scrapy 入门教程 笔记
Python Scrapy 入门教程 入门教程笔记: # 创建mySpider scrapy startproject mySpider # 创建itcast.py cd C:\Users\theDa ...
- Python基础入门教程
Python基础入门教程 Python基础教程 Python 简介 Python环境搭建 Python 基础语法 Python 变量类型 Python 运算符 Python 条件语句 Python 循 ...
随机推荐
- 前后台分离部署时,Niginx上的部署
upstream bowenpay_backend { server 127.0.0.1:9002; } server { listen 80; server_name wx.bowenpay.com ...
- 学习JavaScript最佳实践方法
首先要说明的是,咱现在不是高手,最多还是一个半桶水,算是入了JS的门. 谈不上经验,都是一些教训. 这个时候有人要说,“靠,你丫半桶水,凭啥教我们”.您先别急着骂,先听我说. 你叫一个大学生去教小学数 ...
- 在win10下给vs2013配置opencv3.0
opencv这玩意是真难搞呀. 先吐槽下..... 下面进入正文. 1准备工具: opencv3.0+vs2013 这里面不提供链接下载,自行谷歌百度. 2配置环境: a.打开下载好的opencv(解 ...
- JAVA之单源最短路径(Single Source Shortest Path,SSSP问题)dijkstra算法求解
题目简介:给定一个带权有向图,再给定图中一个顶点(源点),求该点到其他所有点的最短距离,称为单源最短路径问题. 如下图,求点1到其他各点的最短距离 准备工作:以下为该题所需要用到的数据 int N; ...
- 使用WSL连接Docker for Windows
在Windows下安装Docker for Windows Cotana搜索功能,打开Windows的Hype-v功能(注:会影响Virtualbox和Vmware的使用)并重启电脑. 从Docker ...
- 理解Python中的类对象、实例对象、属性、方法
class Animal(object): # 类对象 age = 0 # 公有类属性 __like = None # 私有类属性 def __init__(self): # 魔法方法 self.na ...
- 洛谷 P2725 解题报告
P2725 邮票 Stamps 题目背景 给一组 N 枚邮票的面值集合(如,{1 分,3 分})和一个上限 K -- 表示信封上能够贴 K 张邮票.计算从 1 到 M 的最大连续可贴出的邮资. 题目描 ...
- springMVC(spring)+WebSocket案例(获取请求参数)
开发环境(最低版本):spring 4.0+java7+tomcat7.0.47+sockjs 前端页面要引入: <script src="http://cdn.jsdelivr.ne ...
- linux下activemq安装与配置
一.下载:apache-activemq-5.14.0-bin.tar.gz http://activemq.apache.org/activemq-5140-release.html 二.安装a ...
- 一文看懂 Github
GitHub 介绍 GitHub 是为开发者构建的一个开发平台.GitHub 是一个受开发者工作方式启发的开发平台,从开源到商业,能够在上面进行托管和查看代码.管理项目和数百万其他开发人员一起开发软件 ...