
Python爬虫爬取网页图片
没想到python是如此强大,令人着迷,以前看见图片总是一张一张复制粘贴,现在好了,学会python就可以用程序将一张张图片,保存下来。
今天逛贴吧看见好多美图,可是图片有点多,不想一张一张地复制粘贴,怎么办呢?办法总是有的,即便没有我们也可以创造一个办法。

下面就看看我今天写的程序:
#coding=utf-8

#urllib模块提供了读取Web页面数据的接口

import urllib.request

#re模块主要包含了正则表达式

import re

#定义一个getHtml()函数

def getHtml(url):

    page = urllib.request.urlopen(url)  #urllib.request.urlopen()方法用于打开一个URL地址

    html = page.read() #read()方法用于读取URL上的数据

    return html

def getImg(html):

    reg = r'src="(.+?\.jpg)" pic_ext'    #正则表达式,得到图片地址

    imgre = re.compile(reg)     #re.compile() 可以把正则表达式编译成一个正则表达式对象.

    html = html.decode('utf-8') #python3

    imglist = re.findall(imgre,html)      #re.findall() 方法读取html 中包含 imgre(正则表达式)的数据

    #把筛选的图片地址通过for循环遍历并保存到本地

    #核心是urllib.request.urlretrieve()方法,直接将远程数据下载到本地,图片通过x依次递增命名

    x = 0

    for imgurl in imglist:

     urllib.request.urlretrieve(imgurl,'D:\E\%s.jpg' % x)

     x += 1

html = getHtml("https://tieba.baidu.com/p/xxxxxxxx")

print(getImg(html))
运行程序后,下面就是见证奇迹的时刻,打开对应文件夹:
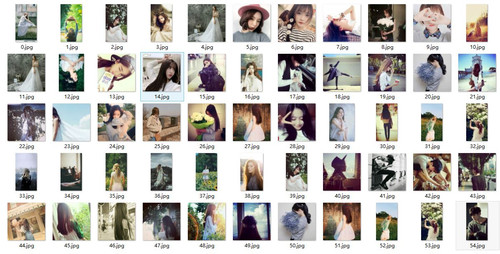
哇!图片全部保存了下来,so nice! :-)
2019年1月更新备注:
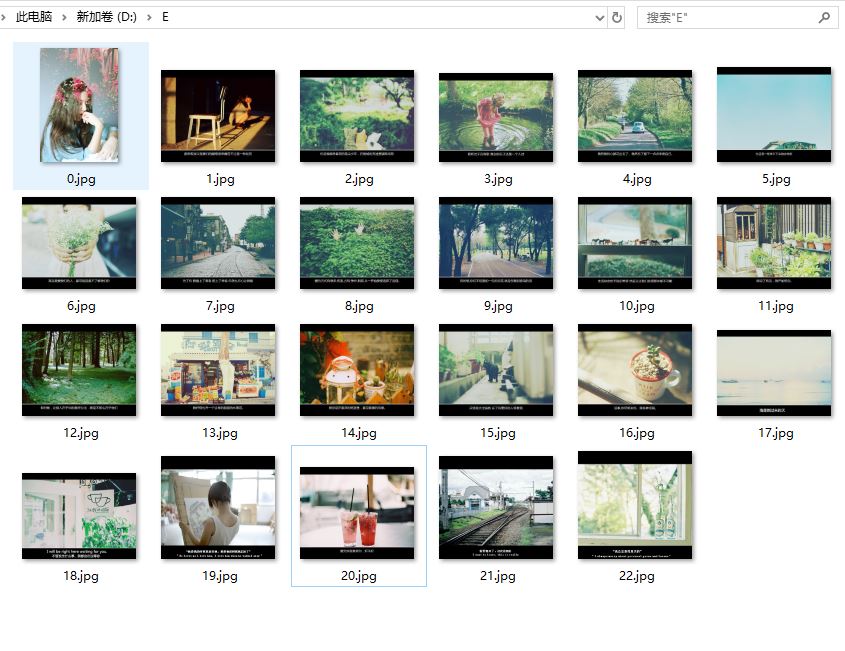
此前代码为2015年Python2.x环境测试,现在已将代码更新,测试环境为Python3.7 ,注意请在D盘新建一个文件夹重命名为E
测试网址:https://tieba.baidu.com/p/2555125530
测试结果如图:
Python爬虫爬取网页图片的更多相关文章
- node:爬虫爬取网页图片
代码地址如下:http://www.demodashi.com/demo/13845.html 前言 周末自己在家闲着没事,刷着微信,玩着手机,发现自己的微信头像该换了,就去网上找了一下头像,看着图片 ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- erlang 爬虫——爬取网页图片
说起爬虫,大家第一印象就是想到了python来做爬虫.其实,服务端语言好些都可以来实现这个东东. 在我们日常上网浏览网页的时候,经常会看到一些好看的图片,我们就希望把这些图片保存下载,或者用户用来做桌 ...
- Python多线程爬虫爬取网页图片
临近期末考试,但是根本不想复习!啊啊啊啊啊啊啊!!!! 于是做了一个爬虫,网址为 https://yande.re,网页图片为动漫美图(图片带点颜色........宅男福利 github项目地址为:h ...
- python爬虫——爬取网页数据和解析数据
1.网络爬虫的基本概念 网络爬虫(又称网络蜘蛛,机器人),就是模拟客户端发送网络请求,接收请求响应,一种按照一定的规则,自动地抓取互联网信息的程序.只要浏览器能够做的事情,原则上,爬虫都能够做到. 2 ...
- 1.记我的第一次python爬虫爬取网页视频
It is my first time to public some notes on this platform, and I just want to improve myself by reco ...
- Python:爬取网站图片并保存至本地
Python:爬取网页图片并保存至本地 python3爬取网页中的图片到本地的过程如下: 1.爬取网页 2.获取图片地址 3.爬取图片内容并保存到本地 实例:爬取百度贴吧首页图片. 代码如下: imp ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- java爬虫-简单爬取网页图片
刚刚接触到“爬虫”这个词的时候是在大一,那时候什么都不明白,但知道了百度.谷歌他们的搜索引擎就是个爬虫. 现在大二.再次燃起对爬虫的热爱,查阅资料,知道常用java.python语言编程,这次我选择了 ...
随机推荐
- window下编译jcef
自行编译jcef过程中遇到了一些问题,现在记录如下. 参考的主要文章是jcef的官方介绍: https://bitbucket.org/chromiumembedded/java-cef/wiki/B ...
- 用Python教你微信防撤回(文本、图片、语音、视频、名片等...)
大家在使用微信过程中,有时候消息还没看到,就被撤回了.毕竟好奇心大家都有,明知到消息被撤回了,就更想去看一下是什么内容心里想着万一是女神给我表白了呢.. 今天就用Python来做个微信防撤回的小功能. ...
- 【Python3爬虫】教你怎么利用免费代理搭建代理池
一.写在前面 有时候你的爬虫刚开始的时候可以正常运行,能够正常的爬取数据,但是过了一会,却出现了一个“403 Forbidden",或者是”您的IP访问频率太高“这样的提示,这就意味着你的I ...
- 接口自动化:HttpClient + TestNG + Java(一) - 接口测试概述+自动化环境搭建
1.1 接口测试简介 1.1.1 什么是接口测试 开始学习接口自动化测试之前,我们先要来了解什么是接口,以及什么是接口测试. 我们都知道,测试从级别上划分可以分为 组件测试 集成测试 系统测试 验收测 ...
- 【转载】假设有以下代码 String s = “hello”; 阿里巴巴笔试题
原文链接点这里 equals 源码如下: 分析: //true equal用于比较两个对象的值是否相同,和内存地址无关
- webpack-插件机制杂记
系列文章 Webpack系列-第一篇基础杂记 webpack系列-插件机制杂记 前言 webpack本身并不难,他所完成的各种复杂炫酷的功能都依赖于他的插件机制.或许我们在日常的开发需求中并不需要自己 ...
- 初步认识Swiper_前端交互控制神器_滚动3D切换等特效简单制作
前言: 本人在项目的工作中负责研发,页面及交互基本都是交给前端去做的.以前前端写的东西大概都知道,都是一些JS,CSS和HTML等的一些基本控制,都懂!但是今天前端突然做了一个具有特殊效果的DOM:页 ...
- Java 中的几种线程池,你之前用对了吗
好久不发文章了,难道是因为忙,其实是因为懒.这是一篇关于线程池使用和基本原理的科普水文,如果你经常用到线程池,不知道你的用法标准不标准,是否有隐藏的 OOM 风险.不经常用线程池的同学,还有对几种线程 ...
- C++系列总结——封装
前言 众所周知,封装.继承和多态是面向对象编程的三大特性.C++作为一门面向对象的编程语言,自然支持了这些特性,但C++是如何实现这些特性的呢?今天先说下我理解的封装. 封装 通常我们会把下面的行为也 ...
- 海康&大华&DSS视频拉流-RTSP转RTMP多媒体播放技术
海康&大华&DSS获取RTSP 实时流 海康:rtsp://[username]:[password]@[ip]:[port]/[codec]/[channel]/[subtype]/ ...