
ML-L1、L2 正则化
出现过拟合时,使用正则化可以将模型的拟合程度降低一点点,使曲线变得缓和。
L1正则化(LASSO)
正则项是所有参数的绝对值的和。正则化不包含theta0,因为他只是偏置,而不影响曲线的摆动幅度。
\]
# 使用pipeline进行封装

from sklearn.linear_model import Lasso

# 使用管道封装lasso

def LassoRegssion(degree, alpha):

    return Pipeline([

        ("poly", PolynomialFeatures(degree = degree)),

        ("std_scaler", StandardScaler()),

        ("lasso", Lasso(alpha=alpha))

    ])
使用\(\alpha=0.01\) 的正则化拟合20阶多项式
lasso_reg = LassoRegssion(20, 0.01)

lasso_reg.fit(X_train, y_train)

y_predict = lasso_reg.predict(X_test)

plot_model(lasso_reg)
MSE 1.149608084325997
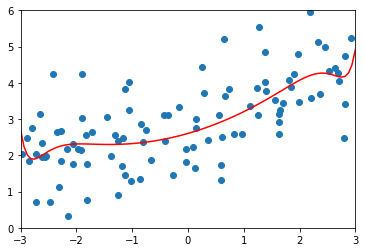
\(\alpha=0.1\)
MSE 1.1213911351818648

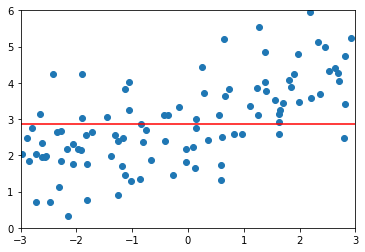
\(\alpha=1\) 时,均方误差又变大了,正则化过度了。模型变成了直线,所有参数都接近0了。因为没有对\(\theta_0\)进行正则化,所以偏置的值没有变化
1.8408939659515595
L2正则化(岭回归)
1/2可加可不加,因为方便求导。对J()求最小值时,也将\(\theta\)的值变小。当\(\alpha\)越大,右边受到的影响就越大,\(\theta\)的值就越小
\]
使用pipeline封装Ridge
from sklearn.linear_model import Ridge

# 使用管道封装岭回归

def RidgeRegression(degree, alpha):

    return Pipeline([

        ("poly", PolynomialFeatures(degree = degree)),

        ("std_scaler", StandardScaler()),

        ("ridge_reg", Ridge(alpha = alpha))

    ])
使用20阶多项式拟合,\(\alpha=0\)即没有正则化。
ridge_reg100 = RidgeRegression(20, 0)

ridge_reg100.fit(X_train, y_train)

y_predict = ridge_reg100.predict(X_test)

plot_model(ridge_reg100)

# MSE 167.94010860994555

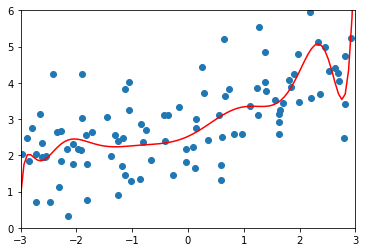
\(\alpha=0.0001\)
ridge_reg100 = RidgeRegression(20, 0.0001)

# MSE 1.3233492754136291
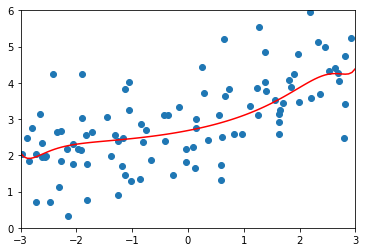
\(\alpha=10\)
ridge_reg100 = RidgeRegression(20, 10)

# MSE 1.1451272194878865
\(\alpha=1000\)
ridge_reg100 = RidgeRegression(20, 10000)

# MSE 1.7967435583384

对比
- LASSO更趋向于将一部分参数变为0,更容易得到直线。Ridge更容易得到曲线。
- \(\alpha\)越大,正则化的效果越明显
两个正则化的不同仅仅在于正则化项的不同:
\]
\]
常见的对比还有:
MSE 和 MAE :
\]
\]
欧拉距离和曼哈顿距离:
\]
还有明可夫斯基距离:
\]
弹性网(待定)
就是将两个范式进行结合。
\]
ML-L1、L2 正则化的更多相关文章
- ML-线性模型 泛化优化 之 L1 L2 正则化
认识 L1, L2 从效果上来看, 正则化通过, 对ML的算法的任意修改, 达到减少泛化错误, 但不减少训练误差的方式的统称 训练误差 这个就损失函数什么的, 很好理解. 泛化错误 假设 我们知道 预 ...
- 防止过拟合:L1/L2正则化
正则化方法:防止过拟合,提高泛化能力 在训练数据不够多时,或者overtraining时,常常会导致overfitting(过拟合).其直观的表现如下图所示,随着训练过程的进行,模型复杂度增加,在tr ...
- 机器学习中L1,L2正则化项
搞过机器学习的同学都知道,L1正则就是绝对值的方式,而L2正则是平方和的形式.L1能产生稀疏的特征,这对大规模的机器学习灰常灰常重要.但是L1的求解过程,实在是太过蛋疼.所以即使L1能产生稀疏特征,不 ...
- L0,L1,L2正则化浅析
在机器学习的概念中,我们经常听到L0,L1,L2正则化,本文对这几种正则化做简单总结. 1.概念 L0正则化的值是模型参数中非零参数的个数. L1正则化表示各个参数绝对值之和. L2正则化标识各个参数 ...
- L1,L2正则化代码
# L1正则 import numpy as np from sklearn.linear_model import Lasso from sklearn.linear_model import SG ...
- L1和L2正则化(转载)
[深度学习]L1正则化和L2正则化 在机器学习中,我们非常关心模型的预测能力,即模型在新数据上的表现,而不希望过拟合现象的的发生,我们通常使用正则化(regularization)技术来防止过拟合情况 ...
- Spark2.0机器学习系列之12: 线性回归及L1、L2正则化区别与稀疏解
概述 线性回归拟合一个因变量与一个自变量之间的线性关系y=f(x). Spark中实现了: (1)普通最小二乘法 (2)岭回归(L2正规化) (3)La ...
- 【深度学习】L1正则化和L2正则化
在机器学习中,我们非常关心模型的预测能力,即模型在新数据上的表现,而不希望过拟合现象的的发生,我们通常使用正则化(regularization)技术来防止过拟合情况.正则化是机器学习中通过显式的控制模 ...
- L1正则化比L2正则化更易获得稀疏解的原因
我们知道L1正则化和L2正则化都可以用于降低过拟合的风险,但是L1正则化还会带来一个额外的好处:它比L2正则化更容易获得稀疏解,也就是说它求得的w权重向量具有更少的非零分量. 为了理解这一点我们看一个 ...
- 4.机器学习——统计学习三要素与最大似然估计、最大后验概率估计及L1、L2正则化
1.前言 之前我一直对于“最大似然估计”犯迷糊,今天在看了陶轻松.忆臻.nebulaf91等人的博客以及李航老师的<统计学习方法>后,豁然开朗,于是在此记下一些心得体会. “最大似然估计” ...
随机推荐
- 从零搭建云原生技术kubernetes(K8S)环境-通过kubesPhere的AllInOne方式
前言 k8s云原生搭建,步骤有点多,但通过kubesphere,可以快速搭建k8s环境,同时有一个以 Kubernetes 为内核的云原生分布式操作系统-kubesphere,本文将从零开始进行kub ...
- rcu stall 导致的hung 记录
synchronize_sched 也会在wait_rcu_gp 的长时间等待导致进入hung ,假设rcu没有及时执行的话, 另外,如果rcu积累到一定程度,内存自然就不足了,可能会oom. rcu ...
- NOI2022游记,Au
前言 8.19: 说实话,我在这里说几句话还不如水群, 新番把我心态搞炸了,我现在急需快乐 所以像游记这种吹水+回忆的文章让我现在非常痛苦. Day -1 (8.19) 上午是信心赛,太好辣,坐等D3 ...
- yield功能分析
下面是示例 输出结果: starting... 4 ******************** res: None 4
- spark 执行spark-example
1. 找到CDH 安装spark的目录 执行 which spark-shell /usr/bin/spark-shell 执行 ll /usr/bin/spark-shell lrwxrwxrwx ...
- CMake | 将路径添加到 CMAKE_PREFIX_PATH
1. CMAKE_PREFIX_PATH CMAKE_PREFIX_PATH是一个分号分隔的路径列表,用来指明软件/库安装路径前缀,以供find_package(),find_program(),fi ...
- Go常见
GO基础语法 方法或函数调用时,传入参数一般都是值复制,除非是map.slice.channel.指针类型是引用传递 短的变量声明(Short Variable Declarations),即自动推导 ...
- ProxySQL(13):ProxySQL集群
文章转载自:https://www.cnblogs.com/f-ck-need-u/p/9362822.html ProxySQL有原生的集群功能,但是这个原生的集群功能还正在试验阶段.本文会详细介绍 ...
- 通俗易懂理解 MySQL B+树、数据存储、索引等知识
文章转载自:https://mp.weixin.qq.com/s?__biz=MzI1MDgwNzQ1MQ==&mid=2247485630&idx=1&sn=681c9c0d ...
- 使用filebeat解析nginx的json格式日志,并且保存原始message字段的值,输出到es中并通过grafana图形化显示
1.nginx日志调成json样式 log_format json '{"@timestamp":"$time_iso8601",' '"server ...