
Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片。
用到的包:
urllib.request
os
分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地。过程简单清晰明了
直接上源代码:
import urllib.request

import os

def url_open(url):

    req = urllib.request.Request(url)

    req.add_header('user-agent','Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36')

    response = urllib.request.urlopen(url)

    html = response.read()

    return html

def get_page(url):

    html = url_open(url).decode('utf-8')

    a = html.find('current-comment-page')+23

    b = html.find(']',a)

    return html[a:b]

def find_imgs(url):

    html = url_open(url).decode('utf-8')

    img_addrs = []

    a = html.find('img src=')

    while a != -1:

        b = html.find('.jpg',a ,a+255)

        if b != -1:

            img_addrs.append('https:'+html[a+9:b+4]) # 'img src='为9个偏移  '.jpg'为4个偏移

        else:

            b = a+9

        a = html.find('img src=', b)

    return img_addrs

def save_imgs(folder, img_addrs):

    for each in img_addrs:

        filename = each.split('/')[-1]

        with open(filename, 'wb') as f:

            img = url_open(each)

            f.write(img)

        print(img_addrs)

def download_mm(folder = 'xxoo', pages = 5):

    os.mkdir(folder)

    os.chdir(folder)

    url = 'http://jandan.net/ooxx/'

    page_num = int(get_page(url))

    for i in range(pages):

        page_num -= i

        page_url = url + 'page-'+ str(page_num) + '#comments'

        img_addrs = find_imgs(page_url)

        save_imgs(folder, img_addrs)

if __name__ == '__main__':

    download_mm()
其中在主函数download_mm()中,将pages设置在了5面。
本来设置的是10,但是在程序执行的过程中。出现了404ERROR错误
即imgae_url出现了错误。尝试着在save_img()函数中加入了测试代码:print(img_addrs),
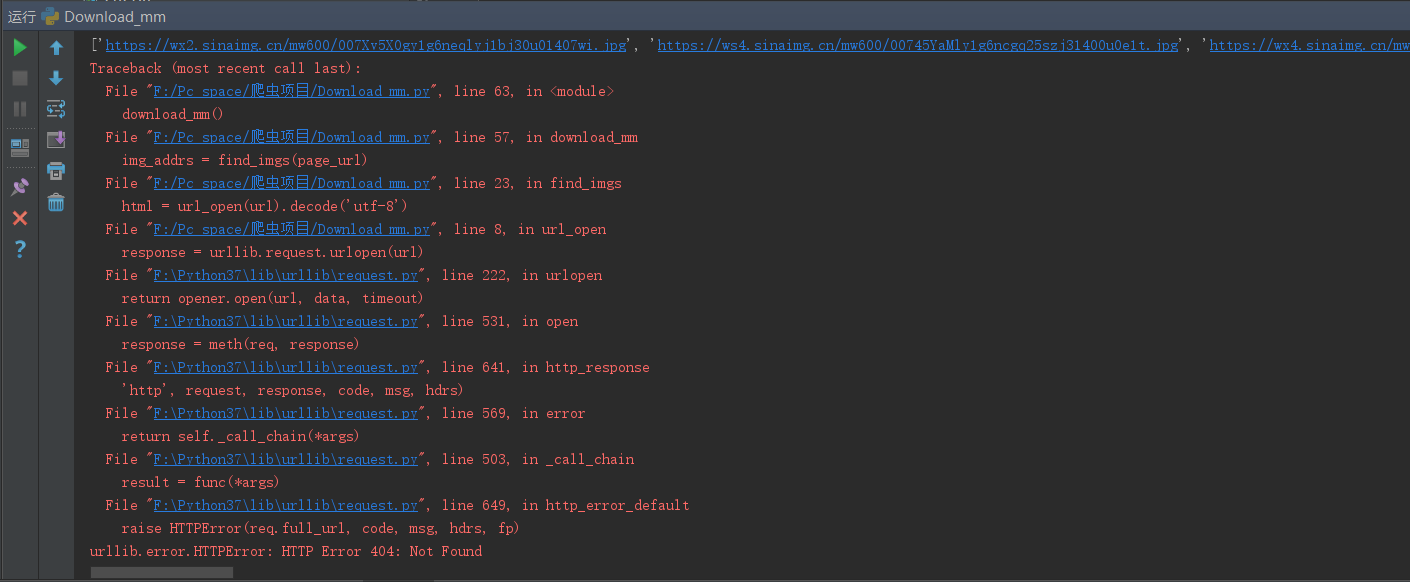
想到会不会是因为后面页数的图片,img_url的格式出现了改变,导致404,所以将pages改成5,
再次运行,结果没有问题,图片能正常下载:
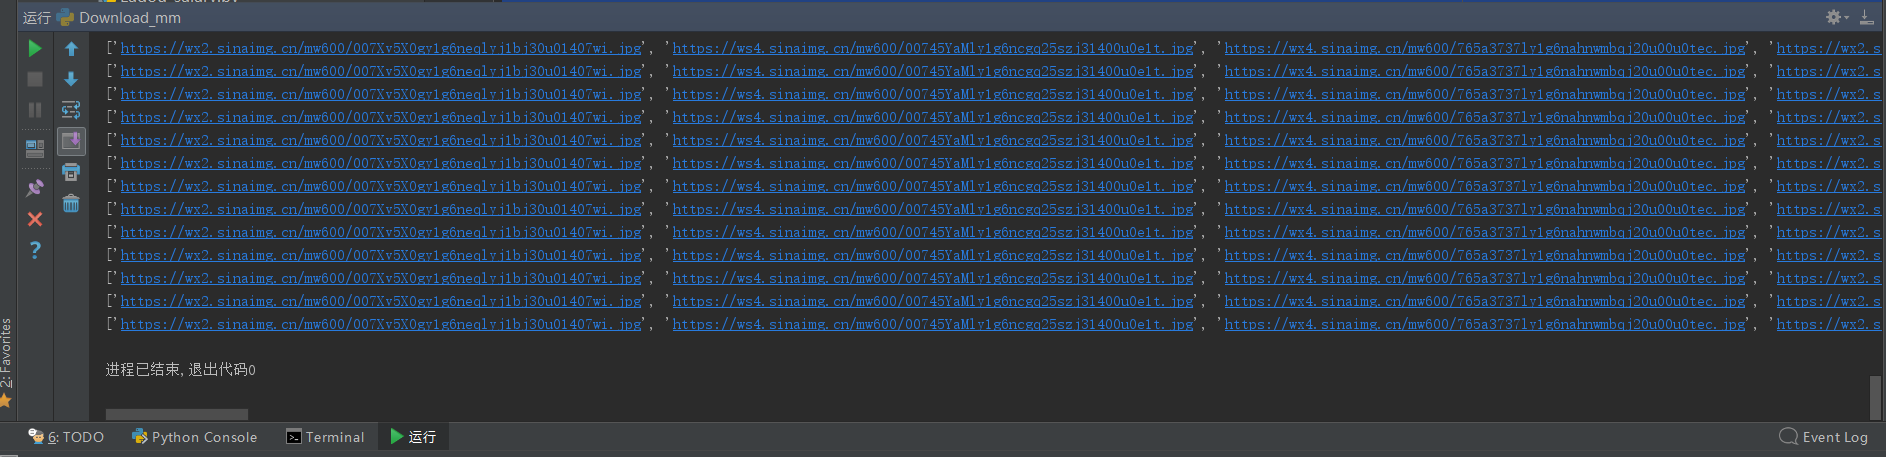
仔细观察发现,刚好是在第五面的图片往后,出现了不可下载的问题(404)。 所以在煎蛋网上,我们直接跳到第6面查看图片的url。

上图是后5面的图片url,下图是前5面的图片url
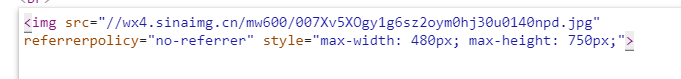
而源代码中,寻找的图片url为使用find()函数,进行定为<img src=‘’> <.jpg>中的图片url,所以后5面出现的a href 无法匹配,即出现了404 ERROR。如果想要下载后续的图片,需要重新添加一个url定位
即在find中将 img src 改成 a href,偏移量也需要更改。
总结:
使用find()来定位网页标签确实太过low,所以以后在爬虫中要尽量使用正则表达式和Beautifulsoup包来提高效率,而这两项我还不是特别熟,所以需要更多的训练。
Python 爬虫 爬取 煎蛋网 图片的更多相关文章
- python爬虫–爬取煎蛋网妹子图片
前几天刚学了python网络编程,书里没什么实践项目,只好到网上找点东西做. 一直对爬虫很好奇,所以不妨从爬虫先入手吧. Python版本:3.6 这是我看的教程:Python - Jack -Cui ...
- python爬虫爬取煎蛋网妹子图片
import urllib.request import os def url_open(url): req = urllib.request.Request(url) req.add_header( ...
- python3爬虫爬取煎蛋网妹纸图片(上篇)
其实之前实现过这个功能,是使用selenium模拟浏览器页面点击来完成的,但是效率实际上相对来说较低.本次以解密参数来完成爬取的过程. 首先打开煎蛋网http://jandan.net/ooxx,查看 ...
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- scrapy从安装到爬取煎蛋网图片
下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/pip install wheelpip install lxmlpip install pyopens ...
- python3爬虫爬取煎蛋网妹纸图片(下篇)2018.6.25有效
分析完了真实图片链接地址,下面要做的就是写代码去实现了.想直接看源代码的可以点击这里 大致思路是:获取一个页面的的html---->使用正则表达式提取出图片hash值并进行base64解码--- ...
- Python Scrapy 爬取煎蛋网妹子图实例(二)
上篇已经介绍了 图片的爬取,后来觉得不太好,每次爬取的图片 都在一个文件下,不方便区分,且数据库中没有爬取的时间标识,不方便后续查看 数据时何时爬取的,所以这里进行了局部修改 修改一:修改爬虫执行方式 ...
- python爬取煎蛋网图片
``` py2版本: #-*- coding:utf-8 -*-#from __future__ import unicode_literimport urllib,urllib2,timeimpor ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
随机推荐
- MySql创建索引、删除索引、新增字段、删除字段、修改字段语句
--------------------------------------------------------- -- ALTER TABLE 创建索引 ---------------------- ...
- 错误:java.lang.Exception: No tests found matching Method testPrePage1(egou_manager_web.TestEBrand) from org.junit.internal.requests.ClassRequest@4f3cc73c
今天测试分页时出现以下错误: java.lang.Exception: No tests found matching Method testPrePage1(egou_manager_web.Tes ...
- 使用vitamio长时间播放崩溃的另类处理
最近公司一个项目在公交站旁边弄一个 广告牌,上面是广告视频,下面是广告图片,都是无限轮播的.要求从早上6点到晚上11点不间断播放.剩余时间为关机状态. 图片部分还好说,就是viewpager弄一个无限 ...
- Docker下kafka学习三部曲之二:本地环境搭建
在上一章< Docker下kafka学习,三部曲之一:极速体验kafka>中我们快速体验了kafka的消息分发和订阅功能,但是对环境搭建的印象仅仅是执行了几个命令和脚本,本章我们通过实战来 ...
- Spring Boot 多环境如何配置
Spring Boot 开发环境.测试环境.预生产环境.生产环境多环境配置 通常一个公司的应程序可能在开发环境(dev).测试环境(test).生产环境(prod)中运行.那么是不是需要拷贝不同的安装 ...
- C++11部分特性
初识C++的时候,觉得会个STL就差不多了,后来发现了C++11这个东西,以及C++14,C++17QAQ,看了一下,好高深不学,emmmm真香= = 这里就只讲一下对ACM写代码有很高帮助的部分特性 ...
- TestNG(十二) 参数化测试
<?xml version="1.0" encoding="utf-8" ?> <suite name = "parameter&q ...
- JAVA用递归来判断回文串
用递归来判断回文串 思路: ①首先如果是空串,一个字符,则判断是回文串 ②若不满足①,则我们需要对字符串进行递归判断,我们会想到要用第一个字符和最后一个字符进行比较,若相同则,第二个和倒数第二个进行比 ...
- 豆瓣电影TOP250和书籍TOP250爬虫
豆瓣电影 TOP250 和书籍 TOP250 爬虫 最近开始玩 Python , 学习爬虫相关知识的时候,心血来潮,爬取了豆瓣电影TOP250 和书籍TOP250, 这里记录一下自己玩的过程. 电影 ...
- Promise.all结合数组Map用法
Promise.all(iterable) 方法返回一个 Promise 实例,此实例在 iterable 参数内所有的 promise 都“完成(resolved)”或参数中不包含 promise ...