
Spark中的Wordcount
通过scala语言基于local编写spark的Wordcount
import org.apache.spark.rdd.RDD

import org.apache.spark.{SparkConf, SparkContext}

object WordCount {

  def main(args: Array[String]): Unit = {

    // Spark配置文件对象

    val conf: SparkConf = new SparkConf()

    // 设置Spark程序的名字

    conf.setAppName("WordCount")

    // 设置运行模式为local模式 即在idea本地运行

    // local : 一个并行度

    // local[2] : 两个并行度

    // local[*] : 有多少用多少

    conf.setMaster("local")

    // Spark的上下文环境,相当于Spark的入口

    val sc: SparkContext = new SparkContext(conf)

    // 词频统计

    // 1、读取文件

    /**

      * RDD : 弹性分布式数据集(可以先当成scala中的集合去使用)

      */

    val linesRDD: RDD[String] = sc.textFile("scala/data/words.txt")

    // 2、将每一行的单词切分出来

    // flatMap: 在Spark中称为 算子

    // 算子一般情况下都会返回另外一个新的RDD

    val wordsRDD: RDD[String] = linesRDD.flatMap(kv=>kv.split(","))

    // 3、按照单词分组

    val groupRDD: RDD[(String, Iterable[String])] = wordsRDD.groupBy(kv=>kv)

    // 4、统计每个单词的数量

    val countRDD: RDD[String] = groupRDD.map(kv => {

      val key: String = kv._1

      val values: Iterable[String] = kv._2

      // words.size直接获取迭代器的大小

      // 因为相同分组的所有的单词都会到迭代器中

      // 所以迭代器的大小就是单词的数量

      val size: Int = values.size

      key + "," + size

    })

    countRDD.saveAsTextFile("spark/data/wordcount.txt")

  }

}

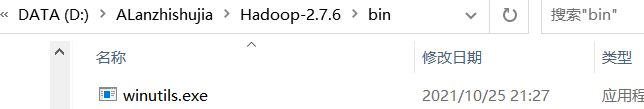
会报这个错
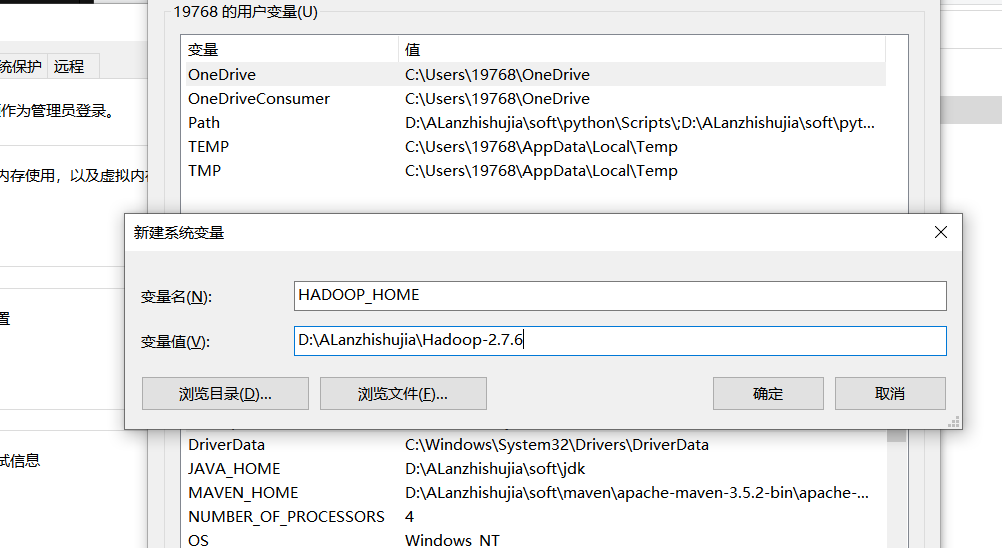
解决方案:
新建一个文件夹,放入这个文件
配置环境变量
需要导入的依赖
<dependencies>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-core_2.11</artifactId>

            <version>2.4.5</version>

        </dependency>

        <dependency>

            <groupId>org.scala-lang</groupId>

            <artifactId>scala-library</artifactId>

            <version>2.11.12</version>

        </dependency>

        <dependency>

            <groupId>org.scala-lang</groupId>

            <artifactId>scala-compiler</artifactId>

            <version>2.11.12</version>

        </dependency>

        <dependency>

            <groupId>org.scala-lang</groupId>

            <artifactId>scala-reflect</artifactId>

            <version>2.11.12</version>

        </dependency>

        <dependency>

            <groupId>mysql</groupId>

            <artifactId>mysql-connector-java</artifactId>

            <version>5.1.49</version>

        </dependency>

        <dependency>

            <groupId>junit</groupId>

            <artifactId>junit</artifactId>

            <version>4.13.1</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <!-- Java Compiler -->

            <plugin>

                <groupId>org.apache.maven.plugins</groupId>

                <artifactId>maven-compiler-plugin</artifactId>

                <version>3.1</version>

                <configuration>

                    <source>1.8</source>

                    <target>1.8</target>

                </configuration>

            </plugin>

            <!-- Scala Compiler -->

            <plugin>

                <groupId>org.scala-tools</groupId>

                <artifactId>maven-scala-plugin</artifactId>

                <version>2.15.2</version>

                <executions>

                    <execution>

                        <goals>

                            <goal>compile</goal>

                            <goal>testCompile</goal>

                        </goals>

                    </execution>

                </executions>

            </plugin>

        </plugins>

    </build>
基于yarn去调度WordCount
import org.apache.hadoop.conf.Configuration

import org.apache.hadoop.fs.{FileSystem, Path}

import org.apache.spark.rdd.RDD

import org.apache.spark.{SparkConf, SparkContext}

/**

  * 1、去除setMaster("local")

  * 2、修改文件的输入输出路径(因为提交到集群默认是从HDFS获取数据,需要改成HDFS中的路径)

  * 3、在HDFS中创建目录

  * hdfs dfs -mkdir -p /spark/data/words/

  * 4、将数据上传至HDFS

  * hdfs dfs -put words.txt /spark/data/words/

  * 5、将程序打成jar包

  * 6、将jar包上传至虚拟机,然后通过spark-submit提交任务

  * spark-submit --class WordCount2 --master yarn-client spark-1.0.jar

  * spark-submit --class WordCount2 --master yarn-cluster spark-1.0.jar

  */

object WordCount2 {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setAppName("WordCount2")

    val sc: SparkContext = new SparkContext(conf)

    val linesRDD: RDD[String] = sc.textFile("/spark/data/words")

    val wordsRDD: RDD[String] = linesRDD.flatMap(s=>s.split(","))

    val groupRDD: RDD[(String, Iterable[String])] = wordsRDD.groupBy(s=>s)

    val resRDD: RDD[String] = groupRDD.map(kv => {

      kv._1 + "," + kv._2.size

    })

    // 使用HDFS的JAVA API判断输出路径是否已经存在,存在即删除

    val conff: Configuration = new Configuration()

    // core-site.xml

    conff.set("fs.defaultFS", "hdfs://master:9000")

    val sys = FileSystem.get(conff)

    if (sys.exists(new Path("/spark/data/wordcount"))){

      sys.delete(new Path("/spark/data/wordcount"),true)

    }

    resRDD.saveAsTextFile("/spark/data/wordcount")

  }

}
打成jar包去运行
默认会有两个分区Task
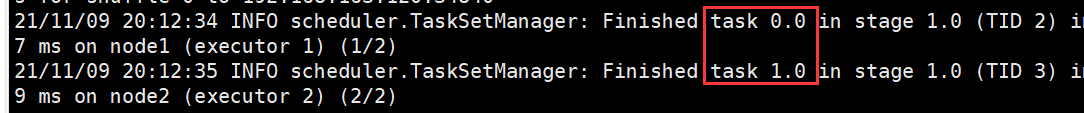
可以通过sc.textFile(Path,分区个数)
on yarn的两种模式
yarn client模式:driverzai当前提交任务的节点上,可以打印任务运行的日志信息,而
yarn cluster模式:driver在AppMaster所有节点上,分布式分配,不能再提交任务的本机打印日志信息
Spark中的Wordcount的更多相关文章
- 006 Spark中的wordcount以及TopK的程序编写
1.启动 启动HDFS 启动spark的local模式./spark-shell 2.知识点 textFile: def textFile( path: String, minPartitions: ...
- Spark中的wordCount程序实现
import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaPairRDD; import org.apache.s ...
- spark 中的RDD编程 -以下基于Java api
1.RDD介绍: RDD,弹性分布式数据集,即分布式的元素集合.在spark中,对所有数据的操作不外乎是创建RDD.转化已有的RDD以及调用RDD操作进行求值.在这一切的背后,Spark会自动 ...
- 大话Spark(3)-一图深入理解WordCount程序在Spark中的执行过程
本文以WordCount为例, 画图说明spark程序的执行过程 WordCount就是统计一段数据中每个单词出现的次数, 例如hello spark hello you 这段文本中hello出现2次 ...
- Spark初步 从wordcount开始
Spark初步-从wordcount开始 spark中自带的example,有一个wordcount例子,我们逐步分析wordcount代码,开始我们的spark之旅. 准备工作 把README.md ...
- 【Spark篇】---Spark中Shuffle机制,SparkShuffle和SortShuffle
一.前述 Spark中Shuffle的机制可以分为HashShuffle,SortShuffle. SparkShuffle概念 reduceByKey会将上一个RDD中的每一个key对应的所有val ...
- intellij-idea打包Scala代码在spark中运行
.创建好Maven项目之后(记得添加Scala框架到该项目),修改pom.xml文件,添加如下内容: <properties> <spark.version></spar ...
- spark中的RDD以及DAG
今天,我们就先聊一下spark中的DAG以及RDD的相关的内容 1.DAG:有向无环图:有方向,无闭环,代表着数据的流向,这个DAG的边界则是Action方法的执行 2.如何将DAG切分stage,s ...
- Tachyon在Spark中的作用(Tachyon: Reliable, Memory Speed Storage for Cluster Computing Frameworks 论文阅读翻译)
摘要: Tachyon是一种分布式文件系统,能够借助集群计算框架使得数据以内存的速度进行共享.当今的缓存技术优化了read过程,可是,write过程由于须要容错机制,就须要通过网络或者 ...
随机推荐
- from 表单上传多个文件?
和单个上传文件基本相同,就是需要在后台控制器中,用数组来接收 jsp页面提交过来的file数据. 也分为三个部分演示. 一.jsp <%-- Created by IntelliJ IDEA. ...
- Lesson2——NumPy Ndarray 对象
NumPy 教程目录 NumPy Ndarray 对象 NumPy 最重要的一个特点是其 $N$ 维数组对象 ndarray,它是一系列同类型数据的集合,以 $0$ 下标为开始进行集合中元素的索引. ...
- CF1399F Yet Another Segments Subset
首先注意一下题面要求,使得选出的线段两两要么包含要么不相交,也就是说一条线段可能会出现不相交的几条线段,而这些线段上面也可能继续这样包含线段.然后我们可以发现我们要做的实际上是在这条线段上选取几条线段 ...
- WebService、Http请求、Socket请求
WebService 定义 一种web程序访问方式,常见协议:SOAP(简单对象访问协议),其实就是Http+XML.利用对象进行数据交互. 请求方法 import lombok.extern.slf ...
- 解决死锁之路3 - 常见 SQL 语句的加锁分析 (转)
出处:https://www.aneasystone.com/archives/2017/12/solving-dead-locks-three.html 这篇博客将对一些常见的 SQL 语句进行加锁 ...
- 关于Java的=赋值操作和方法传递对象时的引用
原创:转载需注明原创地址 https://www.cnblogs.com/fanerwei222/p/11405920.html 下面通过一段代码和debug结果来展示Java中=操作的赋值改变过程. ...
- 啥叫IP地址及子网掩码?
啥叫IP地址及子网掩码 ??? 1.IP地址的定义及分类 1.1IP地址的定义 1.2IP地址的分类 2.子网掩码 1.1 互联网上连接的网络设备和计算机都有唯一的地址,此作为该主机在Interne ...
- 【BZOJ3545】Peaks(Kruskal重构树 主席树)
题目链接 大意 给出有\(N\)个点\(M\)条边的一张图,其中每个点都有一个High值,每条边都有一个Hard值. 再给出\(Q\)个询问:\(v\) \(x\) \(k\) 每次询问查询从点\(v ...
- gitlab登录时出现402的错误
当登录gitlab时出现402的错误提示,可进行以下操作 重新设置一下系统时间 在new project 时若还出现同样的402问题,则清除一下浏览器的cookie即可
- 5、架构--Nginx、搭建超级玛丽游戏
笔记 1.晨考 1.NFS共享文件步骤 - 服务端 [root@backup ~]# yum install nfs-utils rpcbind -y [root@backup ~]# mkdir / ...