
IDEA创建本地Spark程序,并本地运行
1 IDEA创建maven项目进行测试
v创建一个新项目,步骤如下:
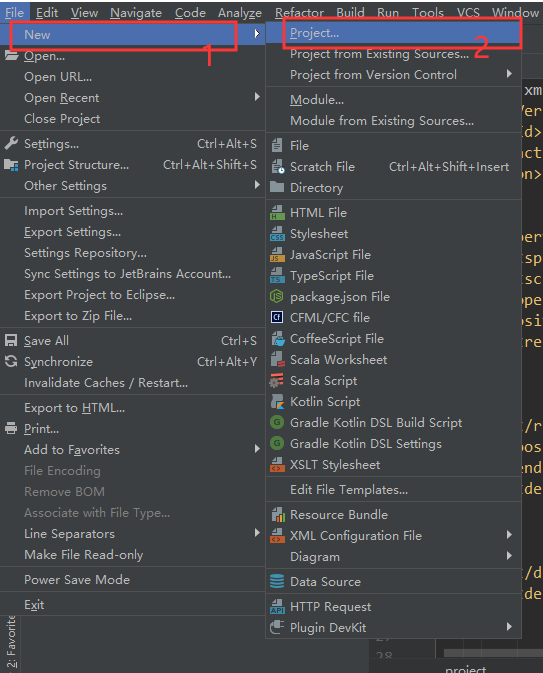

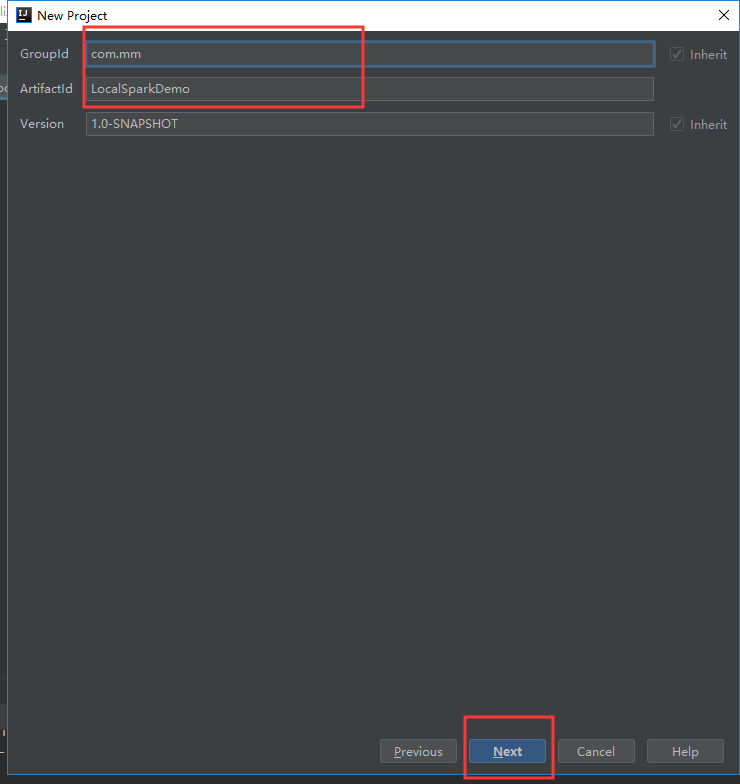
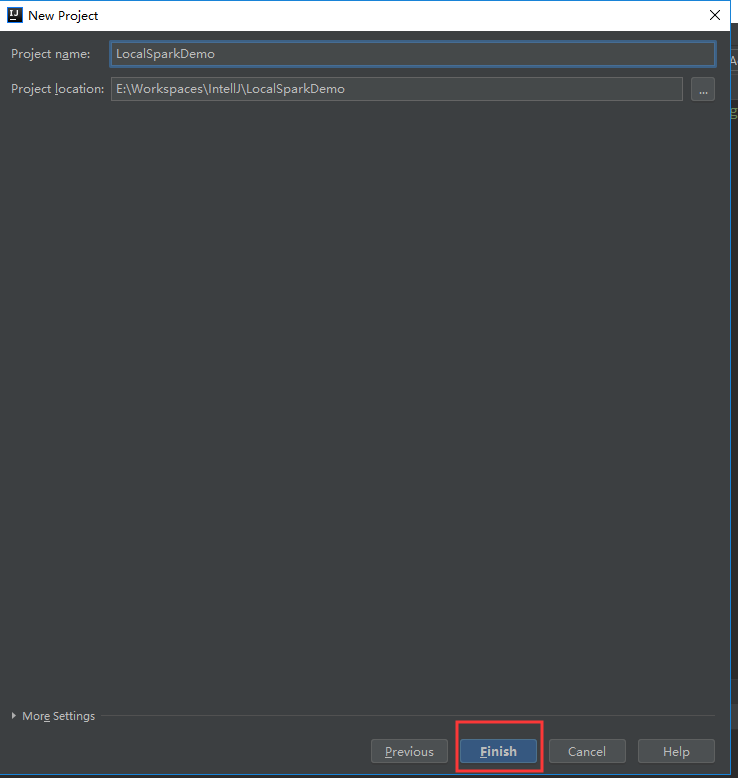
选择“Enable Auto-Import”,加载完后:选择“Enable Auto-Import”,加载完后: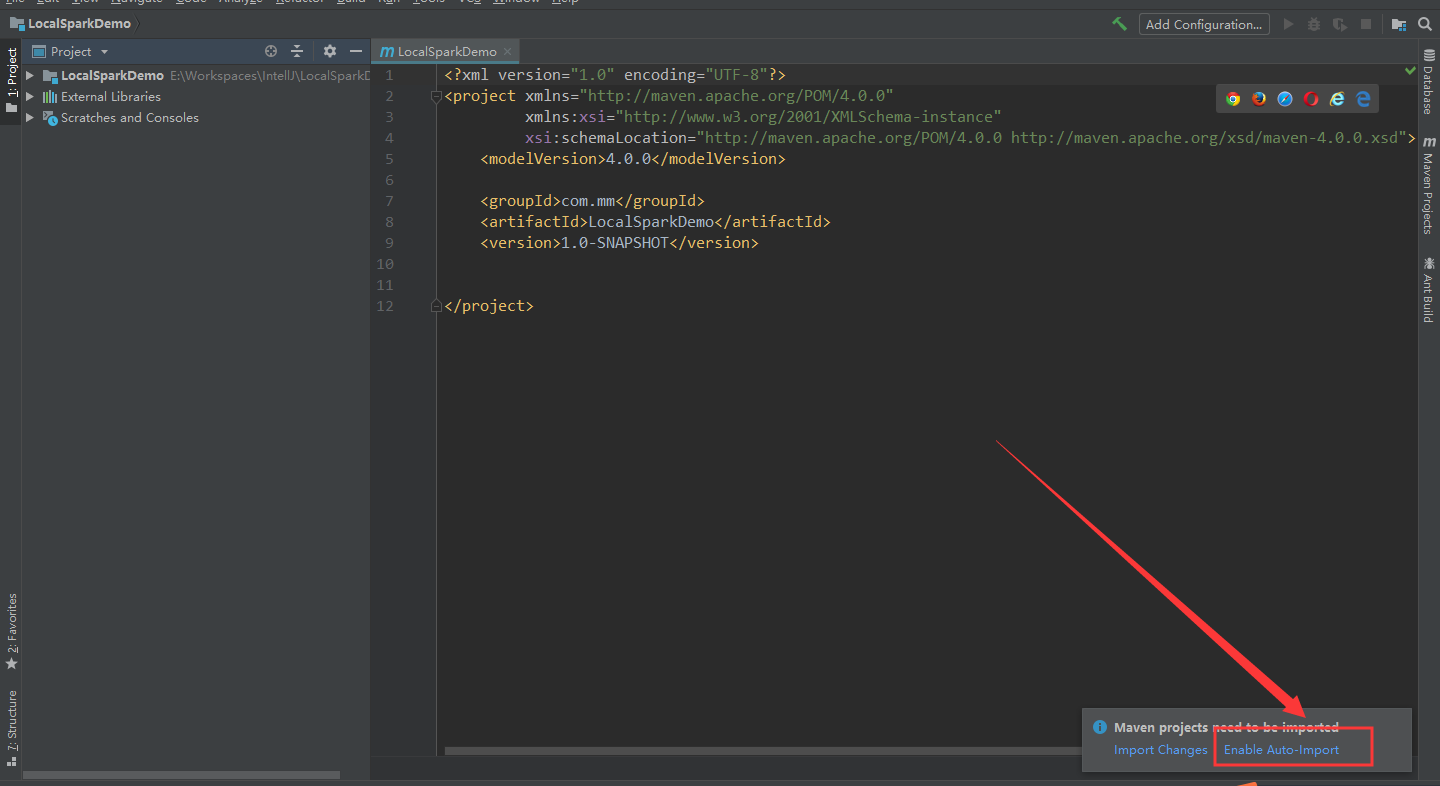
添加SDK依赖:


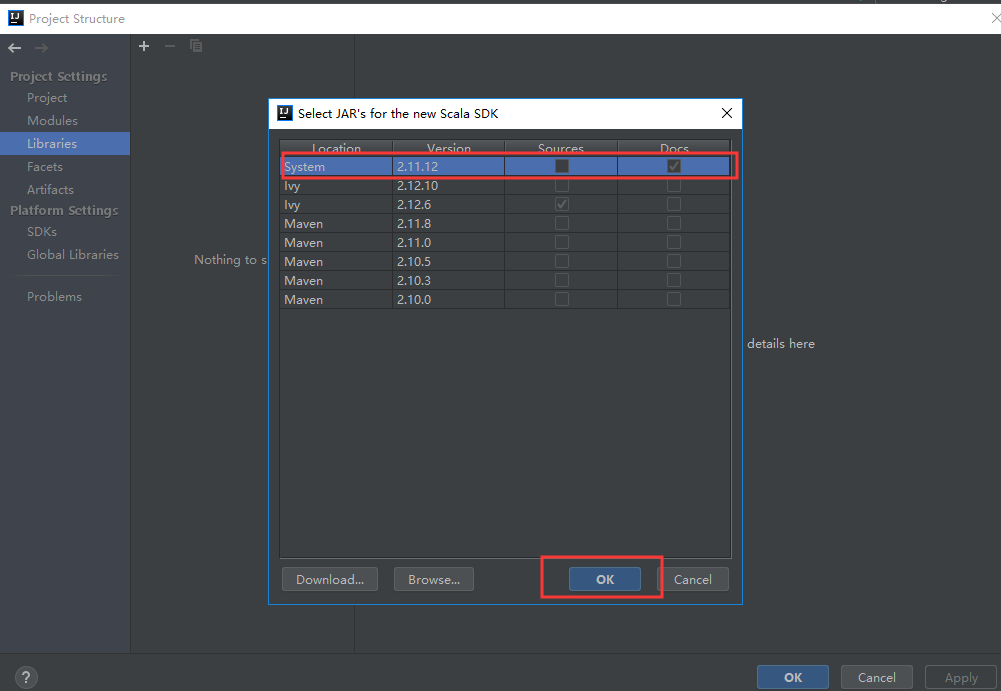
点击OK ok

可以看到scala包加载成功

再修改pox.xml文件
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/maven-v4_0_0.xsd">

  <modelVersion>4.0.</modelVersion>

  <groupId>com.wangle</groupId>

  <artifactId>LocalSpark</artifactId>

  <version>1.0-SNAPSHOT</version>

    <properties>

        <spark.version>2.1.</spark.version>

        <scala.version>2.11</scala.version>

    </properties>

    <dependencies>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-core_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-streaming_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-sql_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-hive_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

        <dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-mllib_${scala.version}</artifactId>

            <version>${spark.version}</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <groupId>org.scala-tools</groupId>

                <artifactId>maven-scala-plugin</artifactId>

                <version>2.15.</version>

                <executions>

                    <execution>

                        <goals>

                            <goal>compile</goal>

                            <goal>testCompile</goal>

                        </goals>

                    </execution>

                </executions>

            </plugin>

            <plugin>

                <artifactId>maven-compiler-plugin</artifactId>

                <version>3.6.</version>

                <configuration>

                    <source>1.8</source>

                    <target>1.8</target>

                </configuration>

            </plugin>

            <plugin>

                <groupId>org.apache.maven.plugins</groupId>

                <artifactId>maven-surefire-plugin</artifactId>

                <version>2.19</version>

                <configuration>

                    <skip>true</skip>

                </configuration>

            </plugin>

        </plugins>

    </build>

</project>
新建“Demo1.scala”,测试
IDEA创建本地Spark程序,并本地运行的更多相关文章
- spark之scala程序开发(本地运行模式):单词出现次数统计
准备工作: 将运行Scala-Eclipse的机器节点(CloudDeskTop)内存调整至4G,因为需要在该节点上跑本地(local)Spark程序,本地Spark程序会启动Worker进程耗用大量 ...
- 在local模式下的spark程序打包到集群上运行
一.前期准备 前期的环境准备,在Linux系统下要有Hadoop系统,spark伪分布式或者分布式,具体的教程可以查阅我的这两篇博客: Hadoop2.0伪分布式平台环境搭建 Spark2.4.0伪分 ...
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- scala IDE for Eclipse开发Spark程序
1.开发环境准备 scala IDE for Eclipse:版本(4.6.1) 官网下载:http://scala-ide.org/download/sdk.html 百度云盘下载:链接:http: ...
- 如何在本地使用scala或python运行Spark程序
如何在本地使用scala或python运行Spark程序 包含两个部分: 本地scala语言编写程序,并编译打包成jar,在本地运行. 本地使用python语言编写程序,直接调用spark的接口, ...
- Spark程序本地运行
Spark程序本地运行 本次安装是在JDK安装完成的基础上进行的! SPARK版本和hadoop版本必须对应!!! spark是基于hadoop运算的,两者有依赖关系,见下图: 前言: 1.环境 ...
- 在IntelliJ IDEA中创建和运行java/scala/spark程序
本文将分两部分来介绍如何在IntelliJ IDEA中运行Java/Scala/Spark程序: 基本概念介绍 在IntelliJ IDEA中创建和运行java/scala/spark程序 基本概念介 ...
- 本地Pycharm将spark程序发送到远端spark集群进行处理
前言 最近在搞hadoop+spark+python,所以就搭建了一个本地的hadoop环境,基础环境搭建地址hadoop2.7.7 分布式集群安装与配置,spark集群安装并集成到hadoop集群, ...
- 2 weekend110的mapreduce介绍及wordcount + wordcount的编写和提交集群运行 + mr程序的本地运行模式
把我们的简单运算逻辑,很方便地扩展到海量数据的场景下,分布式运算. Map作一些,数据的局部处理和打散工作. Reduce作一些,数据的汇总工作. 这是之前的,weekend110的hdfs输入流之源 ...
随机推荐
- 结合<span id="outer"><span id="inter">text</span></span>这段结构,谈谈innerHTML、outerHTML、innerText之间的区别
innerHTML 输出当前标签的文本内容,如果标签内有子标签,会连子标签本身和子标签内的文本内容一起输出. #outer输出子标签本身和子标签的内容:<span id="inter& ...
- vue之父子组件通信
一. 父-子组件间通信 let children={ template:`<div><h1>{{send}}</h1></div>`, # 将传 ...
- 优先队列优化的 Huffman树 建立
如果用vector实现,在运行时遍历寻找最小的两个节点,时间复杂度为O(N^2) 但是我们可以用priority_queue优化,达到O(N logN)的时间复杂度 需要注意的是priority_qu ...
- OD(lfdnb)
由于一场意外,D死了,在此开一个新坑 2019.11.13 考前焦虑 智商为负 有点担心考试状态 2019.11.12 上午考试简直心态爆炸 T1看了一个小时不会 然后看T2,这时候wxy聚聚已经切了 ...
- python3 修改excel 单元格的值(xlsx)
excel code #coding=utf- import os.path import os from openpyxl.reader.excel import load_workbook # e ...
- Chrome崩溃的解决办法
前两天Win10 更新的安全组件,第二天上班来就打开不了Chrome了,打开就是:噢哟,崩溃了! 那是连 setting 页都打不开的啊...好晕,好晕. 我是真的有点崩溃啊,在网上找了好久,什么与百 ...
- selenium爬虫入门(selenium+Java+chrome)
selenium是一个开源的测试化框架,可以直接在浏览器中运行,就像用户直接操作浏览器一样,十分方便.它支持主流的浏览器:chrome,Firefox,IE等,同时它可以使用Java,python,J ...
- 微信公众号 --- 获取access_token
获取access_token 在左侧菜单栏中也可以找到 可以一步步的进行设置 , 身份验证的时候要 注意:密码是你创建微信公众号的密码 往一步步的执行就可以了 接下来就是获取ip 白名单,进行设置 ...
- 第三节:EF Core上下文DbContext相关配置和生命周期
一. 配置相关 1. 数据库连接字符串的写法 (1).账号密码:Server=localhost;Database=EFDB01;User ID=sa;Password=123456; (2).win ...
- Lua table的remove函数
[1]remove函数简介 table.remove(table, pos): 返回table数组中位于pos位置的元素,其后的元素会被前移. pos参数可选, 默认为table长度, 即从最后一个元 ...