
selenium实战:窗口化爬取*宝数据(附源码链接)
完整代码&火狐浏览器驱动下载链接:https://pan.baidu.com/s/1pc8HnHNY8BvZLvNOdHwHBw 提取码:4c08
双十一刚过,想着某宝的信息看起来有些少很难做出购买决定。于是就有了下面的设计:
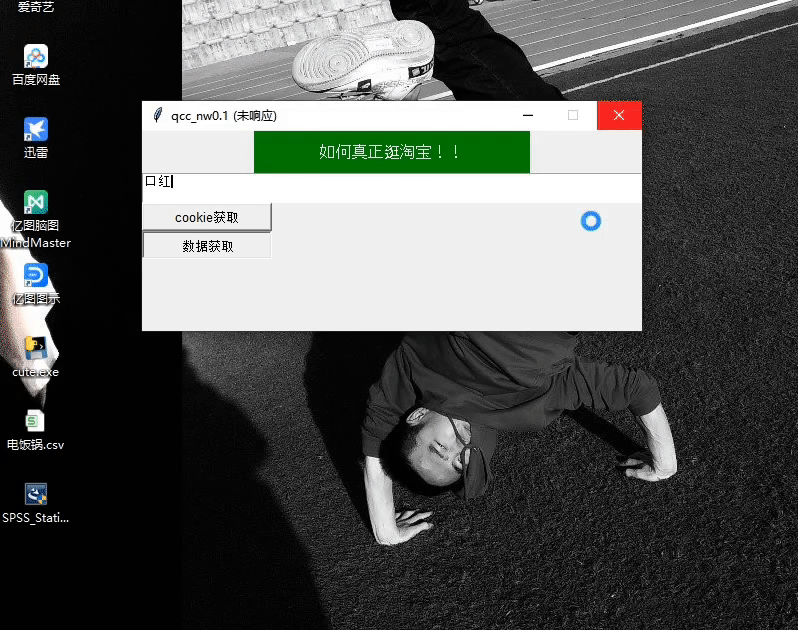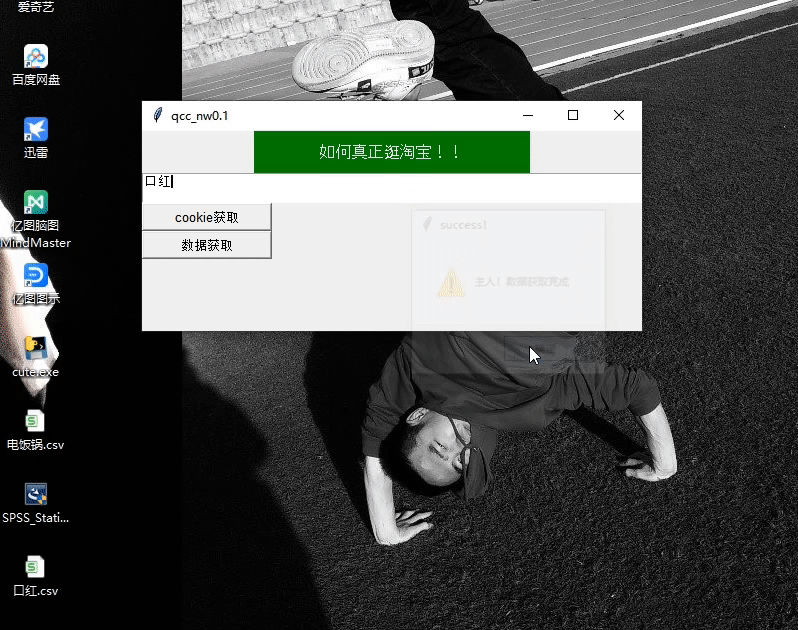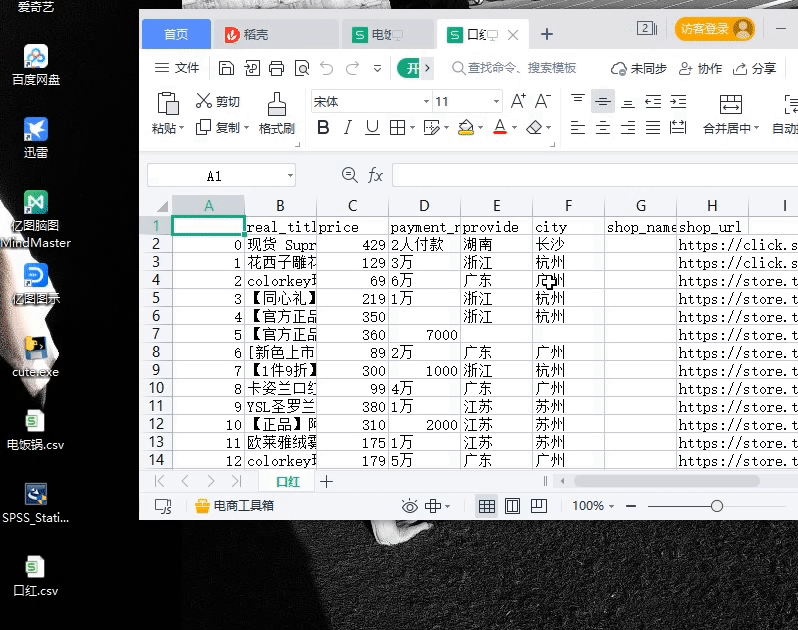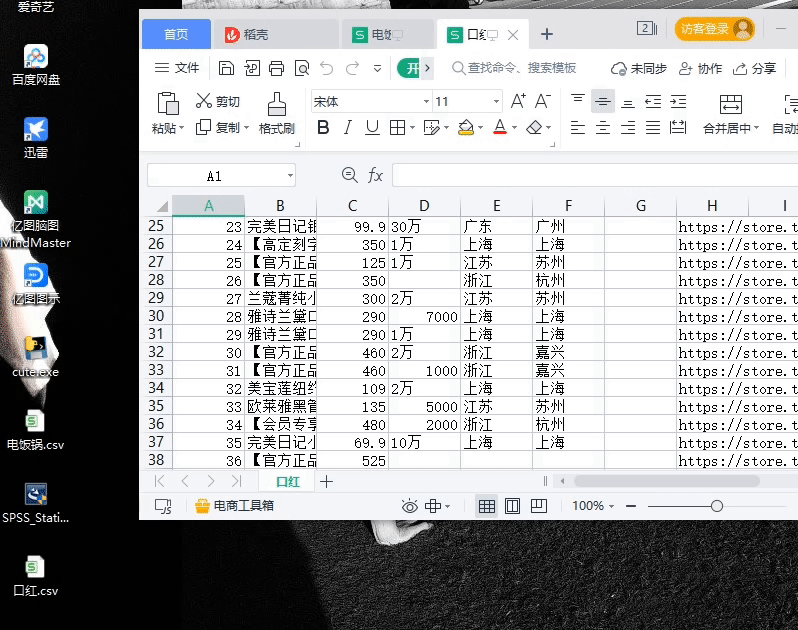
既然有了想法那就赶紧说干就干趁着双十二还没到
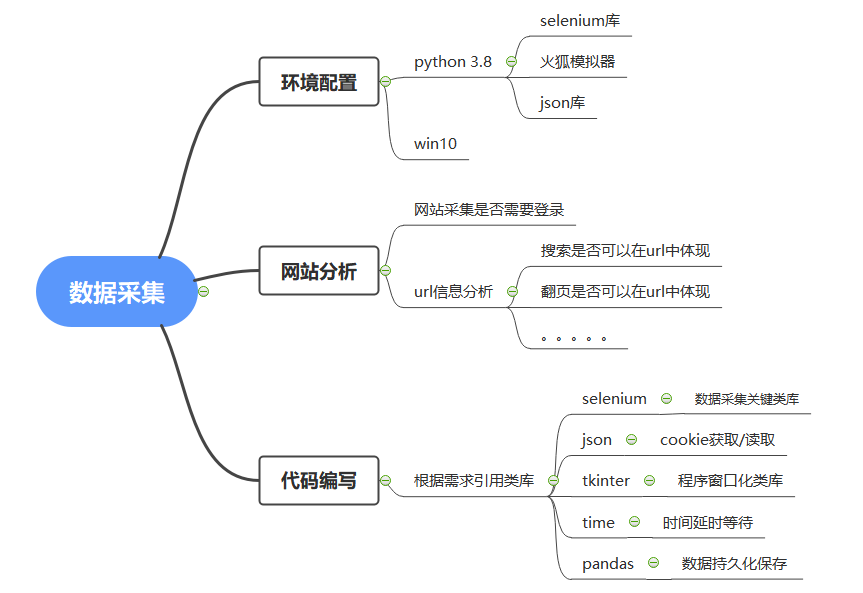
一、准备工作:
安装 :selenium 和 tkinter
pip install selenium
pip install tkinter
下载火狐浏览器驱动
二、网站分析
发现web端如果不登录就不能进行查找商品
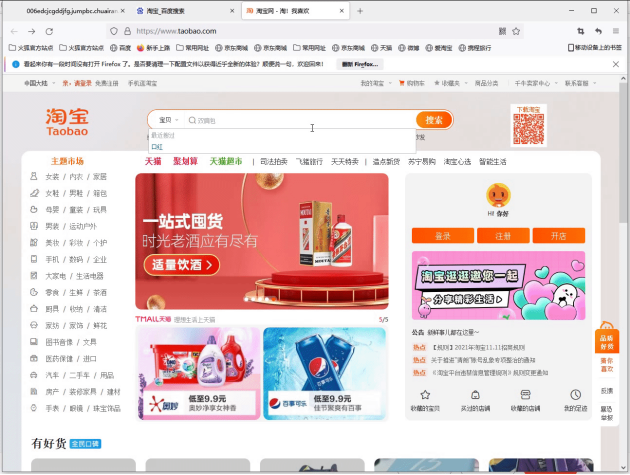
登录后查找口红
发现url竟然张这样
https://s.taobao.com/search?q=口红&imgfile=&js=1&stats_click=search_radio_all%3A1&initiative_id=staobaoz_20211117&ie=utf8&bcoffset=1&ntoffset=1&p4ppushleft=2%2C48&s=44
通过观察发现url中的q=**表示的是搜索的内容 s=**表示页数
接下来确定网页中我们将要采集的数据
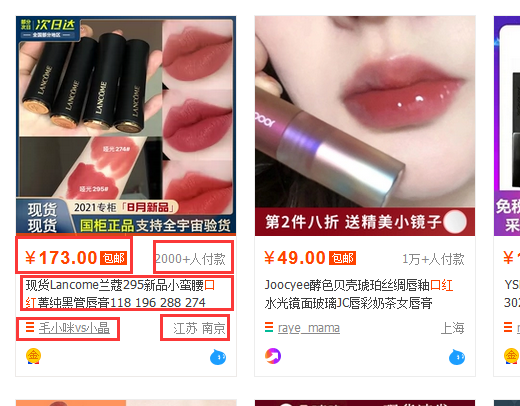
采集的数据有:商品价格;付款人数;商品标题;店铺url;店家地址;
三、代码编写
1、类库引用
import json

import pandas as pd

from selenium import webdriver

import time

from tkinter import *

import tkinter.messagebox
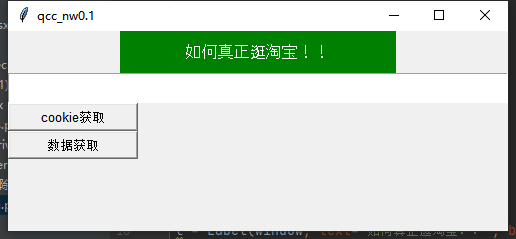
2、窗口化代码实现
# 设置窗口

window = Tk()

window.title('qcc_nw0.1')

# 设置窗口大小

window.geometry('500x200')

# lable标签

l = Label(window, text='如何真正逛淘宝!!', bg='green', fg='white', font=('Arial', 12), width=30, height=2)

l.pack()

# 输入要查询的宝贝的文本框

E1 = Text(window,width='100',height='2')

E1.pack()

def get_cookie():

pass

def get_data():

pass

# cookie获取按钮

cookie = Button(window, text='cookie获取', font=('Arial', 10), width=15, height=1,ommand=get_cookie)

# 数据开按钮

data = Button(window, text='数据获取', font=('Arial', 10), width=15, height=1,ommand=get_data)

cookie.pack(anchor='nw')

data.pack(anchor='nw')

window.mainloop()
3、免登陆功能实现
对已经登录网站的cookie获取
def get_cookie():

# 新建浏览器

dirver = webdriver.Firefox()

dirver.get('https://login.taobao.com/member/login.jhtml?redirectURL=http%3A%2F%2Fbuyertrade.taobao.com%2Ftrade%2Fitemlist%2Flist_bought_items.htm%3Fspm%3D875.7931836%252FB.a2226mz.4.66144265Vdg7d5%26t%3D20110530')

# 设置登录延时获取cookie

time.sleep(20)

# 直接用手机扫码登陆淘宝即可获取

dictCookies = dirver.get_cookies()

# 登录完成后,将cookies保存到本地文件

jsonCookies = json.dumps(dictCookies)

with open("cookies_tao.json", "w") as fp:

fp.write(jsonCookies)
读取获取后的cookie实现登录效果:
1)先对selenium使用的模拟浏览器进行下伪装设置否则会被检测
def get_data():

options = webdriver.FirefoxOptions()

profile = webdriver.FirefoxProfile()

ua = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36'

profile.set_preference('general.useragent.override', ua)#UA伪装

profile.set_preference("dom.webdriver.enabled", False) # 设置非driver驱动

profile.set_preference('useAutomationExtension', False) # 关闭自动化提示

profile.update_preferences() # 更新设置

browser = webdriver.Firefox(firefox_profile=profile, firefox_options=options)
2)读取获取到的cookie实现免登陆
# 删除原有的cookie

browser.delete_all_cookies()

with open('cookies_tao.json', encoding='utf-8') as f:

listCookies = json.loads(f.read())

# cookie 读取发送

for cookie in listCookies:

# print(cookie)

browser.add_cookie({

'domain': '.taobao.com', # 此处xxx.com前,需要带点

'name': cookie['name'],

'value': cookie['value'],

'path': '/',

'expires': None

})
4、解析网页进行数据获取
# 获取输入框中的信息

thing =E1.get('1.0','end')

# 设置将要采集的URL地址

url= "https://s.taobao.com/search?q=%s"

# 设置采集的商品名称

browser.get(url%thing)

# 窗口最小化

browser.minimize_window()

# 获取商品总页数

page_count = browser.find_element_by_xpath('/html/body/div[1]/div[2]/div[3]/div[1]/div[26]/div/div/div/div[1]').text

page_count = int(page_count.split(' ')[1])

# 设置接收字典

dic = {'real_title':[],'price':[],'payment_num':[],'provide':[],'city':[],'shop_name':[],'shop_url':[]}

# 循环翻页设置

for i in range(page_count):

page = i*44

browser.get(url%thing + '&s=%d'%page)

div_list = browser.find_elements_by_xpath('//div[@class="ctx-box J_MouseEneterLeave J_IconMoreNew"]')

# 循环遍历商品信息

for divs in div_list:

# 商品标题获取

real_title = divs.find_element_by_xpath('.//div[@class="row row-2 title"]/a').text

# 商品价格获取

price = divs.find_element_by_xpath('.//div[@class="price g_price g_price-highlight"]/strong').text

# 商品付款人数获取

payment_num = divs.find_element_by_xpath('.//div[@class="deal-cnt"]').text

# 店家地址获取

location = divs.find_element_by_xpath('.//div[@class="row row-3 g-clearfix"]/div[@class="location"]').text

# 店家名称获取

shop_name = divs.find_element_by_xpath('.//div[@class="row row-3 g-clearfix"]/div[@class="shop"]/a/span').text

# 店家URL获取

shop_url = divs.find_element_by_xpath('.//div[@class="row row-3 g-clearfix"]/div[@class="shop"]/a').get_attribute('href')

# 判断地址是否为自治区或直辖市

if len(location.split(' '))>1:

provide=location.split(' ')[0]

city=location.split(' ')[1]

else:

provide=location.split(' ')[0]

city = location.split(' ')[0]

# 将采集的数据添加至字典中

dic['real_title'].append(real_title)

dic['price'].append(price)

dic['payment_num'].append(payment_num.replace('+人付款',''))

dic['provide'].append(provide)

dic['city'].append(city)

dic['shop_name'].append(shop_name)

dic['shop_url'].append(shop_url)

print(real_title,price,payment_num.replace('+人付款',''),provide,city,shop_name,shop_url)

# 使用pandas将获取的数据写入csv文件持久化存储

df=pd.DataFrame(dic)

df.to_csv('C:/Users/admin/Desktop/'+thing.strip('\n')+'.csv')

browser.close()
截止至此基本完成
发现这样的数据写入是不会保存的所以要添加一个提示框来终止get_data函数的运行
def warning():

# 弹出对话框

result = tkinter.messagebox.showinfo(title = 'success!',message='主人!数据获取完成')

# 返回值为:ok
在get_data函数中嵌套warning函数.
-----完活下班!!!!-----
selenium实战:窗口化爬取*宝数据(附源码链接)的更多相关文章
- android高仿抖音、点餐界面、天气项目、自定义view指示、爬取美女图片等源码
Android精选源码 一个爬取美女图片的app Android高仿抖音 android一个可以上拉下滑的Ui效果 android用shape方式实现样式源码 一款Android上的新浪微博第三方轻量 ...
- Web爬虫|入门实战之糗事百科(附源码)
coding by real mind writing by genuine heart 解析 任务背景:https://www.qiushibaike.com/hot/ 窥探网页细节:观察每一页 ...
- 加班时的灵感迸发,我用selenium做了个窗口化的爬*宝数据。(附源码链接)
完整代码&火狐浏览器驱动下载链接:https://pan.baidu.com/s/1pc8HnHNY8BvZLvNOdHwHBw 提取码:4c08 双十一刚过,想着某宝的信息看起来有些少很难做 ...
- python 使用selenium和requests爬取页面数据
目的:获取某网站某用户下市场大于1000秒的视频信息 1.本想通过接口获得结果,但是使用post发送信息到接口,提示服务端错误. 2.通过requests获取页面结果,使用html解析工具,发现麻烦而 ...
- SpringBoot整合Redis、mybatis实战,封装RedisUtils工具类,redis缓存mybatis数据 附源码
创建SpringBoot项目 在线创建方式 网址:https://start.spring.io/ 然后创建Controller.Mapper.Service包 SpringBoot整合Redis 引 ...
- 【SSH网上商城项目实战30】项目总结(附源码下载地址)
项目基本完成了,加上这个总结,与这个项目相关的博客也写了30篇了,积少成多,写博客的过程是固化思路的一个过程,对自己很有用,同时也能帮助别人.顺便说个题外话,在学习的过程中肯定会遇到很多异常出现,我们 ...
- 利用js编写一个简单的html表单验证,验证通过时提交数据(附源码)
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8 ...
- 使用selenium再次爬取疫情数据(链接数据库)
爬取网页地址: 丁香医生 数据库连接代码: def db_connect(): try: db=pymysql.connect('localhost','root','zzm666','payiqin ...
- Java爬取同花顺股票数据(附源码)
最近有小伙伴问我能不能抓取同花顺的数据,最近股票行情还不错,想把数据抓下来自己分析分析.我大A股,大家都知道的,一个概念火了,相应的股票就都大涨. 如果能及时获取股票涨跌信息,那就能在刚开始火起来的时 ...
随机推荐
- HTML对溢出的控制:overflow
用于对超出模块的内容进行控制 overflow的三种参数 1.visible(默认):溢出部分可见 2.hidden:溢出部分隐藏 3.auto:适当加入滚动条 overflow使用方法 1.常用 o ...
- dp凸优化/wqs二分学习笔记(洛谷4383 [八省联考2018]林克卡特树lct)
qwq 安利一个凸优化讲的比较好的博客 https://www.cnblogs.com/Gloid/p/9433783.html 但是他的暴力部分略微有点问题 qwq 我还是详细的讲一下这个题+这个知 ...
- 容器化之路Docker网络核心知识小结,理清楚了吗?
Docker网络是容器化中最难理解的一点也是整个容器化中最容易出问题又难以排查的地方,加上使用Kubernets后大部分人即使是专业运维如果没有扎实的网络知识也很难定位容器网络问题,因此这里就容器网络 ...
- Spark分区器浅析
分区器作用:决定该数据在哪个分区 概览: 仅仅只有pairRDD才可能持有分区器,普通RDD的分区器为None 在分区器为None时RDD分区一般继承至父RDD分区 初始RDD分区数: 由集合创建,R ...
- Hive面试题整理(一)
1.Hive表关联查询,如何解决数据倾斜的问题?(☆☆☆☆☆) 1)倾斜原因:map输出数据按key Hash的分配到reduce中,由于key分布不均匀.业务数据本身的特.建表时考虑不周.等原因 ...
- 【UE4 设计模式】单例模式 Singleton Pattern
概述 描述 保证一个类只有一个实例 提供一个访问该实例的全局节点,可以视为一个全局变量 仅在首次请求单例对象时对其进行初始化. 套路 将默认构造函数设为私有, 防止其他对象使用单例类的 new运算符. ...
- Noip模拟59 2021.9.22
新机房首模拟变倒数 T1 柱状图 关于每一个点可以做出两条斜率分别为$1,-1$的直线, 然后题意转化为移动最少的步数使得所有点都在某一个点的两条直线上 二分出直线的高度,判断条件是尽量让这条直线上部 ...
- Noip模拟7 2021.6.11
前言 考试时候der展了,T1kmp没特判(看来以后还是能hash就hash),T2搜索细节没注意,ans没清零,130飞到14.... T1 匹配(hash/kmp) 这太水了,其实用个hash随便 ...
- HZOI帝国2019欢乐时刻
前言: update 只是恢复一下原来手残删掉的博客,不是在水,嘤嘤嘤 update 以后改成Stack,但是之前的就懒得改了... by 10.31 为了窝的访问量大家的好心情,模仿学长搞了一个这个 ...
- 零基础入门非常好的C语言基础资料
C语言程序的结构认识 用一个简单的c程序例子,介绍c语言的基本构成.格式.以及良好的书写风格,使小伙伴对c语言有个初步认识. 例1:计算两个整数之和的c程序: #include main() { in ...