
Lucene实现自己的英文空格小写分词器
看一下继承图,Tokenizer和TokenFilter都是继承于TokenStream,TokenStream继承了AttributeSource
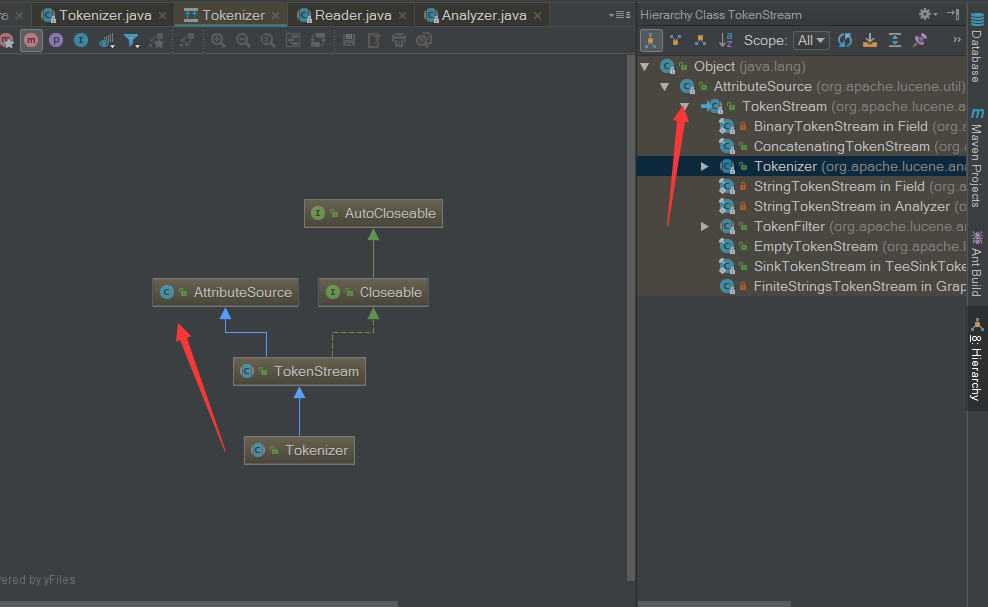
package com.lucene.demo.analizer;

import org.apache.lucene.analysis.Analyzer;

import org.apache.lucene.analysis.TokenFilter;

import org.apache.lucene.analysis.TokenStream;

import org.apache.lucene.analysis.Tokenizer;

import org.apache.lucene.util.Attribute;

import org.apache.lucene.util.AttributeImpl;

import org.apache.lucene.util.AttributeReflector;

import java.io.IOException;

public class SansamAnalyzer extends Analyzer{

    /**

     *

     */

    @Override

    protected TokenStreamComponents createComponents(String fieldName) {

        //装饰器模式,将分出的词项用filter进行处理,可以链式装饰实现多个filter

        MyTokenizer myTokenizer = new MyTokenizer();

        MyLowerCaseTokenFilter myLowerCaseTokenFilter = new MyLowerCaseTokenFilter(myTokenizer);

        return new TokenStreamComponents(myTokenizer, myLowerCaseTokenFilter);

    }

    public static class MyTokenizer extends Tokenizer{

        //调用AttributeSource-addAttribute方法

        //维护了一个attributes Map,实现可复用

        //private final Map<Class<? extends Attribute>, AttributeImpl> attributes;

        //private final Map<Class<? extends AttributeImpl>, AttributeImpl> attributeImpls;

        MyAttribute attribute = this.addAttribute(MyAttribute.class);

        char[] buffer = new char[255];

        int length = 0;

        int c;

        @Override

        public boolean incrementToken() throws IOException {

            //进行分析处理逻辑

            clearAttributes();

            length = 0;

            while (true){

                c = this.input.read();

                if(c == -1){

                    if(length > 0){

                        this.attribute.setChar(buffer,length);

                        return true;

                    }else {

                        return false;

                    }

                }

                if(Character.isWhitespace(c)){

                    if(length > 0){

                        this.attribute.setChar(buffer,length);

                        return true;

                    }

                }

                buffer[length++] = (char)c;

            }

        }

    }

    public static class MyLowerCaseTokenFilter extends TokenFilter{

        public MyLowerCaseTokenFilter(TokenStream s){

            super(s);

        }

        MyAttribute attribute = this.addAttribute(MyAttribute.class);

        @Override

        public boolean incrementToken() throws IOException {

            //获取一个分词项进行处理

            boolean b = this.input.incrementToken();

            if (b){

                char[] chars = this.attribute.getChar();

                int length = this.attribute.getLength();

                if(length > 0){

                    for (int i = 0; i < length; i++) {

                        chars[i] = Character.toLowerCase(chars[i]);

                    }

                }

            }

            return b;

        }

    }

    /**

     * 自定义Attribute属性接口 继承Attribute

     */

    public static interface MyAttribute extends Attribute {

        void setChar(char [] c, int length);

        char [] getChar();

        int getLength();

        String getString();

    }

    /**

     * 必须使用interface+Impl 继承AttributeImpl

     */

    public static class MyAttributeImpl extends AttributeImpl implements MyAttribute {

        char [] term = new char[255];

        int length = 0;

        @Override

        public void setChar(char[] c, int length) {

            this.length = length;

            if(c.length > 0){

                System.arraycopy(c,0,term,0,length);

            }

        }

        @Override

        public char[] getChar() {

            return term;

        }

        @Override

        public int getLength() {

            return length;

        }

        @Override

        public String getString() {

            if(length > 0){

                return new String(term,0,length);

            }

            return null;

//            return new String(term);  //不能直接返回 因为长度问题 默认255字符

        }

        @Override

        public void clear() {

            term = null;

            term = new char[255];

            this.length = 0;

        }

        @Override

        public void reflectWith(AttributeReflector reflector) {

        }

        @Override

        public void copyTo(AttributeImpl target) {

        }

    }

    public static void main(String[] args) {

        String text = "Hello World A b C";

        try(SansamAnalyzer analyzer = new SansamAnalyzer();

            //调用tokenStream()时 会先得到TokenStreamComponents对象 得到了MyLowerCaseTokenFilter 对象 观察其构造方法及此方法的返回值

            TokenStream stream =  analyzer.tokenStream("title",text);){

            MyAttribute attribute = stream.getAttribute(MyAttribute.class);

            stream.reset();

            while (stream.incrementToken()){

                System.out.print(attribute.getString()+" | ");

            }

            stream.end();

        }catch (Exception e){

                e.printStackTrace();

        }

    }

}
Lucene实现自己的英文空格小写分词器的更多相关文章
- lucene整理3 -- 排序、过滤、分词器
1. 排序 1.1. Sort类 public Sort() public Sort(String field) public Sort(String field,Boolean reverse ...
- Lucene的中文分词器IKAnalyzer
分词器对英文的支持是非常好的. 一般分词经过的流程: 1)切分关键词 2)去除停用词 3)把英文单词转为小写 但是老外写的分词器对中文分词一般都是单字分词,分词的效果不好. 国人林良益写的IK Ana ...
- Lucene介绍及简单入门案例(集成ik分词器)
介绍 Lucene是apache软件基金会4 jakarta项目组的一个子项目,是一个开放源代码的全文检索引擎工具包,但它不是一个完整的全文检索引擎,而是一个全文检索引擎的架构,提供了完整的查询引擎和 ...
- elasticsearch 分析器 分词器
参考:https://www.elastic.co/guide/en/elasticsearch/reference/current/analysis-tokenizers.html 在全文搜索(Fu ...
- Elasticsearch之文档的增删改查以及ik分词器
文档的增删改查 增加文档 使用elasticsearch-head查看 修改文档 使用elasticsearch-head查看 删除文档 使用elasticsearch-head查看 查看文档的三种方 ...
- Restful认识和 IK分词器的使用
什么是Restful风格 Restful是一种面向资源的架构风格,可以简单理解为:使用URL定位资源,用HTTP动词(GET,POST,DELETE,PUT)描述操作. 使用Restful的好处: 透 ...
- IK分词器 原理分析 源码解析
IK分词器在是一款 基于词典和规则 的中文分词器.本文讲解的IK分词器是独立于elasticsearch.Lucene.solr,可以直接用在java代码中的部分.关于如何开发es分词插件,后续会有文 ...
- ElasticSearch-IK分词器和集成使用
1.查询存在问题分析 在进行字符串查询时,我们发现去搜索"搜索服务器"和"钢索"都可以搜索到数据: 而在进行词条查询时,我们搜索"搜索"却没 ...
- 三、Solr多核心及分词器(IK)配置
多核心的概念 多核心说白了就是多索引库.也可以理解为多个"数据库表" 说一下使用multicore的真实场景,比若说,产品搜索和会员信息搜索,不使用多核也没问题,这样带来的问题是 ...
随机推荐
- FPGA——按键(二)
直接上源码: module key_led( input sys_clk , //50Mhz系统时钟 input sys_rst_n, //系统复位,低有效 :] key, //按键输入信号 :] l ...
- Django url
urlpatterns = [ url(正则表达式, views视图函数,参数,别名),] 参数说明: 一个正则表达式字符串 一个可调用对象,通常为一个视图函数或一个指定视图函数路径的字符 ...
- P4702 取石子
我什么时候写一下污污的小故事呢?反正不是现在. 题目描述 Alice 和 Bob 在玩游戏. 他们有 nn 堆石子,第 ii 堆石子有 a_iai 个,保证初始时 a_i \leq a_{i + 1 ...
- linux下redis的安装方法
一.Linux环境下安装Redis Redis的官方下载网址是:http://redis.io/download (这里下载的是Linux版的Redis源码包) Redis服务器端的默认端口是6 ...
- Confluence安装部署
前言:Confluence是一个专业的企业知识管理与协同软件,可以用于构建企业wiki.通过它可以实现团队成员之间的协作和知识共享.现在大多数公司都会部署一套Confluence,用作内部WiKi. ...
- 《DOM Scripting》学习笔记-——第四章 案列分析 JS美术馆(点击链接到图片)
实现效果:点击图片链接,可以在当前网页显示图片,并且显示图片标题. Html代码 <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.1//EN&qu ...
- JS数据类型之Number类型
Number类型的转换及方法 var num = 10; num.toString() //"10"转字符串,参数表示几进制 num.toFixed(2) //10.00 自动舍入 ...
- MongoDB集群的搭建
一.环境准备 1.Centos7 2.mongodb3.4.10 3.三台机器IP分别是:192.168.1.100.192.168.1.135.192.168.1.136 二.mongdb数据库的安 ...
- nginx开机启动
centos 7以上是用Systemd进行系统初始化的 Systemd服务文件以.service结尾,比如现在要建立nginx为开机启动,如果用yum install命令安装的,yum命令会自动创建n ...
- pip安装scrapy出错解决措施
安装报错提示: building 'twisted.test.raiser' extensionerror: Microsoft Visual C++ 14.0 is required. Get it ...