
python爬虫-爬取你想要的小姐姐
一、准备
1. 原地址
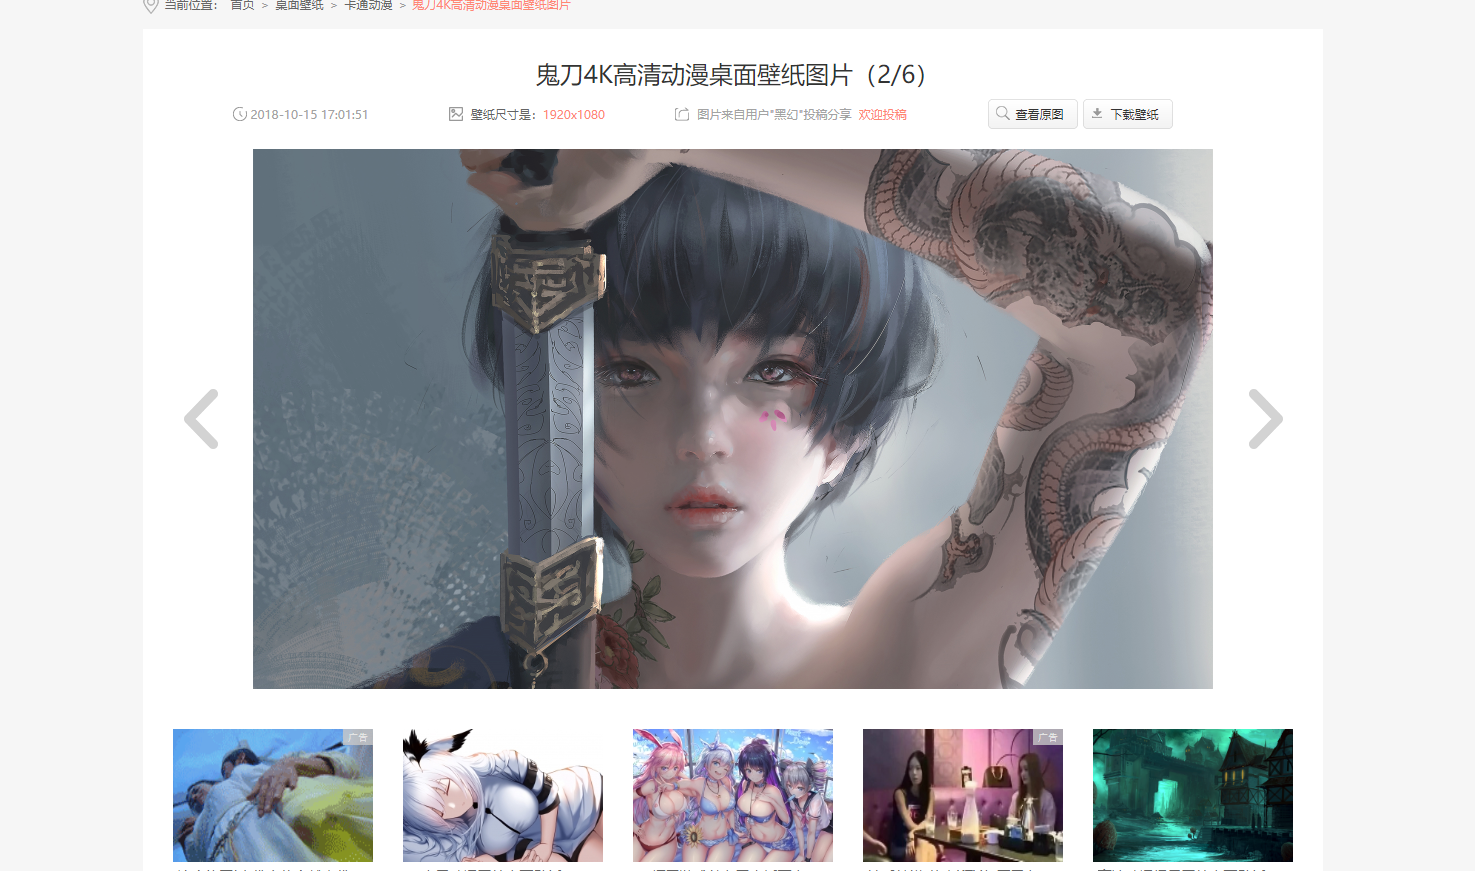
2. 检查html发现,网页是有规则的分页, 最大图片的class为pic-large
二、代码
 import requests

 import os

 from bs4 import BeautifulSoup

 url = 'http://www.win4000.com/wallpaper_detail_157712.html'

 imgmkdir = 'D://Download//ghost_1//'

 # 获取网页url

 def getUrlList():

     imgUrlList = []

     for i in range(0, 10):

         imgUrl = ''

         url_split = url.split('.html')

         if not i == 0:

             imgUrl += url_split[0] + '_' + str(i) + '.html'

             # print(imgUrl)

             imgUrlList.append(imgUrl)

     return imgUrlList

 # 下载图片

 def downImg(imgUrl):

     try:

         if not os.path.exists(imgmkdir):

             os.mkdir(imgmkdir)

         if not os.path.exists(imgUrl):

             r = requests.get(imgUrl)

             r.raise_for_status()

             # 使用with语句可以不用自己手动关闭已经打开的文件流

             imgpath = imgmkdir + imgUrl.split('/')[-1]

             # 开始写文件, wb表示写二进制文件

             with open(imgpath, 'wb') as f:

                 f.write(r.content)

             print(imgUrl + '【爬取完成】')

         else:

             print(imgUrl.split('/')[-1] + '【文件已存在】')

     except Exception as e:

         print("爬取失败" + str(e))

 # 获取imgHtml标签

 def getcontent(soup):

     for i in soup.find_all('img', class_='pic-large'):

         imgsrc = i['src']

         if imgsrc.find('http') >= 0 or imgsrc.find('https') >= 0:

             # 下载图片

             downImg(imgsrc)

 # 根据url获取html源码

 def getHtmlByUrl(htmlUrl):

     htmlText = requests.get(htmlUrl).content

     # 使用beautifulSoup解析html

     soup = BeautifulSoup(htmlText, 'lxml')

     return soup

 def main():

     htmlUrlList = getUrlList()

     for url in htmlUrlList:

         htmltext = getHtmlByUrl(url)

         getcontent(htmltext)

 if __name__ == '__main__':

     main()
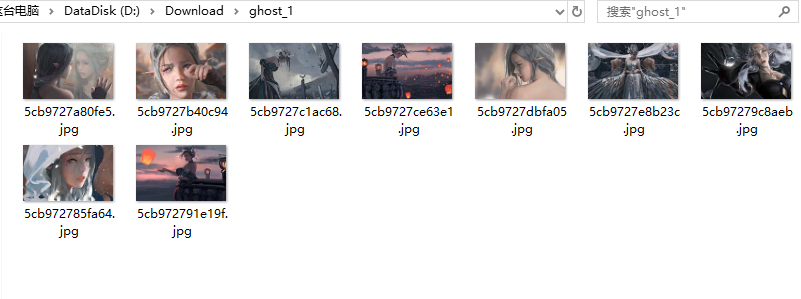
三、结果
四、总结
代码用比较笨的方法来获取,先试水
python爬虫-爬取你想要的小姐姐的更多相关文章
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python爬虫—爬取英文名以及正则表达式的介绍
python爬虫—爬取英文名以及正则表达式的介绍 爬取英文名: 一. 爬虫模块详细设计 (1)整体思路 对于本次爬取英文名数据的爬虫实现,我的思路是先将A-Z所有英文名的连接爬取出来,保存在一个cs ...
- 一个简单的python爬虫,爬取知乎
一个简单的python爬虫,爬取知乎 主要实现 爬取一个收藏夹 里 所有问题答案下的 图片 文字信息暂未收录,可自行实现,比图片更简单 具体代码里有详细注释,请自行阅读 项目源码: # -*- cod ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- python爬虫爬取内容中,-xa0,-u3000的含义
python爬虫爬取内容中,-xa0,-u3000的含义 - CSDN博客 https://blog.csdn.net/aiwuzhi12/article/details/54866310
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
随机推荐
- 在Typora中使用Latex
https://blog.csdn.net/happyday_d/article/details/83715440 今后可能更多在本地编辑出Markdown之后复制上博客或者上传到GitHub.
- 实现一个兼容eleUI form表单的多选组件
本质上是实现了一个eleUI select组件中的创建条目功能的组件,仅仅是将dropdown的选择框变成了label形式.支持eleUI的form表单校验,同时组件也提供了组件内自定义校验的方法.常 ...
- [Windows] 输入字符间距变宽
今天在输入时,不会到误触到哪里,输入的字符间距变得很宽,如下图: 最后找到原因是不小心同时按下了 Shift+Space(空格),进入全角模式,就会导致输入的字符间距变宽 想要恢复,再按一次 shif ...
- Oracle语法 及 SQL题目(一)
目录 课例复制 SQL题目一 SQL题目二 SQL题目三 笔记 课例复制 OCM 全称:Oracle Certified Master 认证大师 含义:Oracle 原厂推出的数据库方向最高级别认证 ...
- 做动画animation--matplotlib--python2和3通用代码
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/weixin_42053726/artic ...
- 基因表达半衰期 | mRNA Half-Life
做单细胞RNA-seq分析,自然就能想到我们测到的其实是一个概率学的东西,就像女士品茶里的酵母的泊松分布一样. 真实的细胞里,一切都是连续的,从DNA到mRNA到蛋白,是有一个时间间隔的,每一个pro ...
- C# 获取USB设备信息
C# 获取USB设备信息WMI方式 using System; using System.Management; using System.Text.RegularExpressions; using ...
- graph embedding 使用方法
无论是network embedding 还是graph embedding都是通过节点(node)和边的图,学出每个节点的embedding向量. 比较流行的算法有: Model Paper Not ...
- etcd常用命令记录
etcd常用命令记录 1.查看etcd的版本 [root@etcd01 ssl]# curl -L http://127.0.0.1:2379/version {"etcdserver& ...
- java和c# md5加密
MD5加密的方式有很多,加盐的方式更多,最近项目需要java和c#加密结果一致,形成方法如下: 1.c#加密方法/// <summary> /// MD5 加密字符串 /// </s ...