
MapReduce编程之Map Join多种应用场景与使用
Map Join 实现方式一:分布式缓存
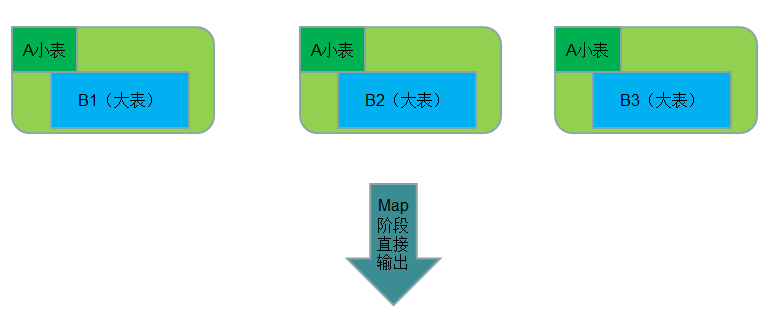
● 使用场景:一张表十分小、一张表很大。
● 用法:
在提交作业的时候先将小表文件放到该作业的DistributedCache中,然后从DistributeCache中取出该小表进行join (比如放到Hash Map等等容器中)。然后扫描大表,看大表中的每条记录的join key /value值是否能够在内存中找到相同join key的记录,如果有则直接输出结果。
DistributedCache是分布式缓存的一种实现,它在整个MapReduce框架中起着相当重要的作用,他可以支撑我们写一些相当复杂高效的分布式程序。说回到这里,JobTracker在作业启动之前会获取到DistributedCache的资源uri列表,并将对应的文件分发到各个涉及到该作业的任务的TaskTracker上。另外,关于DistributedCache和作业的关系,比如权限、存储路径区分、public和private等属性。
代码实现
package com.hadoop.reducejoin.test;

import java.io.BufferedReader;

import java.io.FileNotFoundException;

import java.io.IOException;

import java.io.InputStreamReader;

import java.net.URI;

import java.util.Hashtable;

import org.apache.commons.lang.StringUtils;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.FSDataInputStream;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.Reducer.Context;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

/*

 * 通过分布式缓存实现 map join

 * 适用场景:一个小表,一个大表

 */

public class MapJoinByDistributedCache extends Configured implements Tool {

    /*

     * 直接在map 端进行join合并

     */

    public static class MapJoinMapper extends

            Mapper<LongWritable, Text, Text, Text> {

        private Hashtable<String, String> table = new Hashtable<String, String>();// 定义Hashtable存放缓存数据

        /**

         * 获取分布式缓存文件

         */

        @SuppressWarnings("deprecation")

        protected void setup(Context context) throws IOException,

                InterruptedException {

            Path[] localPaths = (Path[]) context.getLocalCacheFiles();// 返回本地文件路径

            if (localPaths.length == 0) {

                throw new FileNotFoundException(

                        "Distributed cache file not found.");

            }

            FileSystem fs = FileSystem.getLocal(context.getConfiguration());// 获取本地

                                                                            // FileSystem

                                                                            // 实例

            FSDataInputStream in = null;

            in = fs.open(new Path(localPaths[0].toString()));// 打开输入流

            BufferedReader br = new BufferedReader(new InputStreamReader(in));// 创建BufferedReader读取器

            String infoAddr = null;

            while (null != (infoAddr = br.readLine())) {// 按行读取并解析气象站数据

                String[] records = infoAddr.split("\t");

                table.put(records[0], records[1]);// key为stationID,value为stationName

            }

        }

        public void map(LongWritable key, Text value, Context context)

                throws IOException, InterruptedException {

            String line = value.toString();

            String[] valueItems = line.split("\\s+");

//            使用下面一行将没有数据, StringUtils不能接正则,只能接分隔符

//            String[] valueItems = StringUtils.split(value.toString(), "\\s+");

            String stationName = table.get(valueItems[0]);// 天气记录根据stationId

                                                            // 获取stationName

            if (null != stationName)

                context.write(new Text(stationName), value);

        }

    }

    public int run(String[] args) throws Exception {

        // TODO Auto-generated method stub

        Configuration conf = new Configuration();

        Path out = new Path(args[2]);

        FileSystem hdfs = out.getFileSystem(conf);// 创建输出路径

        if (hdfs.isDirectory(out)) {

            hdfs.delete(out, true);

        }

        Job job = Job.getInstance();// 获取一个job实例

        job.setJarByClass(MapJoinByDistributedCache.class);

        FileInputFormat.addInputPath(job, new Path(args[0]));

        FileOutputFormat.setOutputPath(job, new Path(args[2]));

        // 添加分布式缓存文件 station.txt

        job.addCacheFile(new URI(args[1]));

        job.setMapperClass(MapJoinMapper.class);

        job.setOutputKeyClass(Text.class);// 输出key类型

        job.setOutputValueClass(Text.class);// 输出value类型

        return job.waitForCompletion(true) ? 0 : 1;

    }

    public static void main(String[] args0) throws Exception {

        String[] args = { "hdfs://sparks:9000/middle/reduceJoin/records.txt",

                "hdfs://sparks:9000/middle/reduceJoin/station.txt",

                "hdfs://sparks:9000/middle/reduceJoin/MapJoinByDistributedCache-out" };

        int ec = ToolRunner.run(new Configuration(),

                new MapJoinByDistributedCache(), args);

        System.exit(ec);

    }

}
MapJoinByDistributedCache
Map Join 实现方式二:数据库 join
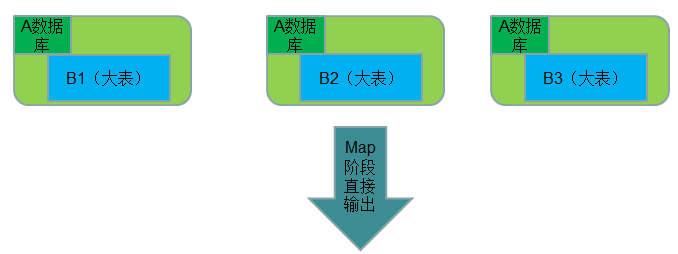
● 使用场景:一张表在数据库、一张表很大。
另外还有一种比较变态的Map Join方式,就是结合HBase来做Map Join操作。这种方式完全可以突破内存的控制,使你毫无忌惮的使用Map Join,而且效率也非常不错。
MapReduce编程之Map Join多种应用场景与使用的更多相关文章
- MapReduce编程之Semi Join多种应用场景与使用
Map Join 实现方式一 ● 使用场景:一个大表(整张表内存放不下,但表中的key内存放得下),一个超大表 ● 实现方式:分布式缓存 ● 用法: SemiJoin就是所谓的半连接,其实仔细一看就是 ...
- MapReduce编程之Reduce Join多种应用场景与使用
在关系型数据库中 Join 是非常常见的操作,各种优化手段已经到了极致.在海量数据的环境下,不可避免的也会碰到这种类型的需求, 例如在数据分析时需要连接从不同的数据源中获取到数据.不同于传统的单机模式 ...
- MapReduce编程之wordcount
实践 MapReduce编程之wordcount import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Fi ...
- Swift函数编程之Map、Filter、Reduce
在Swift语言中使用Map.Filter.Reduce对Array.Dictionary等集合类型(collection type)进行操作可能对一部分人来说还不是那么的习惯.对于没有接触过函数式编 ...
- Python函数式编程之map()
Python函数式编程之map() Python中map().filter().reduce()这三个都是应用于序列的内置函数. 格式: map(func, seq1[, seq2,…]) 第一个参数 ...
- mapReduce编程之Recommender System
1 协同过滤算法 协同过滤算法是现在推荐系统的一种常用算法.分为user-CF和item-CF. 本文的电影推荐系统使用的是item-CF,主要是由于用户数远远大于电影数,构建矩阵的代价更小:另外,电 ...
- mapReduce编程之auto complete
1 n-gram模型与auto complete n-gram模型是假设文本中一个词出现的概率只与它前面的N-1个词相关.auto complete的原理就是,根据用户输入的词,将后续出现概率较大的词 ...
- mapReduce编程之google pageRank
1 pagerank算法介绍 1.1 pagerank的假设 数量假设:每个网页都会给它的链接网页投票,假设这个网页有n个链接,则该网页给每个链接平分投1/n票. 质量假设:一个网页的pagerank ...
- 并发编程之Fork/Join
并发与并行 并发:多个进程交替执行. 并行:多个进程同时进行,不存在线程的上下文切换. 并发与并行的目的都是使CPU的利用率达到最大.Fork/Join就是为了尽可能提高硬件的使用率而应运而生的. 计 ...
随机推荐
- redis未授权访问批量验证脚本编写[python]
漏洞简介 简单来说,redis是一个数据库.在默认的配置下,redis绑定在0.0.0.0:6379,也就是说,如果服务器有公网ip,可以通过访问其公网ip的6379端口来操作redis.最为致命的是 ...
- npm i --save-dev prettier安装警告saveError enoent
出现问题的情况: 或者: D:\Program Files\nodejs>npm i --save-dev prettier npm WARN saveError ENOENT: no such ...
- 日志工具——log4j
资料参考自:http://www.codeceo.com/article/log4j-usage.html 关于日志的基本概念以及从入门到实战,请参见:http://www.cnblogs.com/L ...
- Deep Learning综述[上]
Deep-Learning-Papers-Reading-Roadmap: [1] LeCun, Yann, Yoshua Bengio, and Geoffrey Hinton. "Dee ...
- 18-[模块]-shutil
shutil模块 高级的 文件.文件夹.压缩包 处理模块 (1)文件操作 shutil.copyfileobj(fsrc, fdst[, length]) 将文件内容拷贝到另一个文件中 import ...
- selenium-登录C语言中文网
from selenium import webdriver from selenium.webdriver.support.wait import WebDriverWait from seleni ...
- UWP 滚动条私人定制
最近突然发现微软自带的滚动条好挫哦 微软哒(棒棒哒) 网上找的(美美哒) 好了. 如果你想要棒棒哒,那么就不用往下看了(手动再见). 如果你想要美美哒,就需要下面的神秘代码. <Style Ta ...
- (webapp)微信和safri 对于html5 部分功能不兼容,多选或单选下拉框去除边框无效果。
1 appearance:none; 2 -moz-appearance:none; /* Firefox */ 3 -webkit-appearance:none; /* Safari 和 Chro ...
- hdu2844Coins(多重背包模板)
Coins Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)Total Submi ...
- Fiddler抓包原来可以这么玩
Fiddler是一个抓包工具 1 解压压缩包至C\program files (x86) 2 打开C program files (x86) Fiddler Web Debugger V4.6.201 ...