
scrapy项目1:爬取某培训机构老师信息(spider类)
1、scrapy爬虫的流程,可简单该括为以下4步:
1).新建项目---->scrapy startproject 项目名称(例如:myspider)
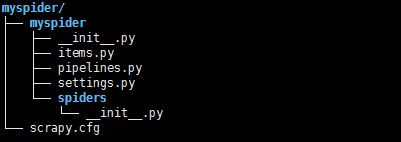
>>scrapy.cfg为项目配置文件
>>myspider:项目的Python模块,将会从这里引用代码
>>mySpider/items.py :项目的目标文件
>>mySpider/pipelines.py :项目的管道文件
>>mySpider/settings.py :项目的设置文件
>>mySpider/spiders/ :存储爬虫代码目录
2).编写items.py文件,可以理解为要爬取的内容,后边在案例中说明
3).编写爬虫文件,在spiders中自己创建,或者通过命令:scrapy genspider 爬虫名 爬虫允许访问的域
4).存储内容(pipelines.py)
案例:爬取黑马培训的老师信息
第一步:创建项目 scrapy startproject ItcastSpider
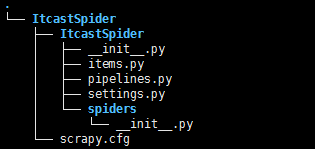
第二步:解析网页,明确要爬取的内容,并编写item文件,代码如下:
# -*- coding: utf-8 -*-

# Define here the models for your scraped items

# See documentation in:

# http://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class ItcastspiderItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    # 老师姓名

    name = scrapy.Field()

    # 职位

    level = scrapy.Field()

    # 介绍信息

    info = scrapy.Field()
第三步:编写爬虫文件 切入spiders文件夹,通过scrapy genspider itcast 'itcast.cn' 来创建
# -*- coding: utf-8 -*-

import scrapy

# 导入之前已经写好的items文件中的类

from ItcastSpider.items import ItcastspiderItem

class ItcastSpider(scrapy.Spider):

    name = "itcast" #爬虫名

    allowed_domains = ["http://www.itcast.cn"] #爬虫允许访问的域

    start_urls = ['http://www.itcast.cn/channel/teacher.shtml#apython'] # 要爬取的第一个url

    def parse(self, response):

       # 通过scrapy内置的xpath规则解析网页,返回一个包含selector对象的列表

        teacher_list = response.xpath('//div[@class="li_txt"]')

        # 实例化类

        item = ItcastspiderItem()

        for each in teacher_list:

            # 通过xpath解析后返回该表达式所对应的所有节点的selector list列表,利用extract()可将该节点序列化为Unicode字符串并返回列表

            # 老师名称

            item['name'] = each.xpath('./h3/text()').extract()[0]

            # 老师的职称

            item['level'] = each.xpath('./h4/text()').extract()[0]

            # 信息

            item['info'] = each.xpath('./p/text()').extract()[0]

            yield item
第四步:编辑管道文件pipelines,将爬取内容存贮到本地
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html

import json

class ItcastspiderPipeline(object):

    def __init__(self):

        # 在本地创建teacher.json文件

        self.filename = open('teacher.json','w')

    def process_item(self, item, spider):

        # python类型转化为json字符串

        text = json.dumps(dict(item),ensure_ascii = False) + '\n'

        # 写入

        self.filename.write(text.encode('utf-8'))

        return item

    def close_spider(self,spider):

        self.filename.close()
第五步:在settings.py中配置管道文件

第六步:启动爬虫 命令 scrapy crawl itcast
scrapy项目1:爬取某培训机构老师信息(spider类)的更多相关文章
- 使用python爬取东方财富网机构调研数据
最近有一个需求,需要爬取东方财富网的机构调研数据.数据所在的网页地址为: 机构调研 网页如下所示: 可见数据共有8464页,此处不能直接使用scrapy爬虫进行爬取,因为点击下一页时,浏览器只是发起了 ...
- scrapy爬取全部知乎用户信息
# -*- coding: utf-8 -*- # scrapy爬取全部知乎用户信息 # 1:是否遵守robbots_txt协议改为False # 2: 加入爬取所需的headers: user-ag ...
- [转]使用python爬取东方财富网机构调研数据
最近有一个需求,需要爬取东方财富网的机构调研数据.数据所在的网页地址为: 机构调研 网页如下所示: 可见数据共有8464页,此处不能直接使用scrapy爬虫进行爬取,因为点击下一页时,浏览器只是发起了 ...
- 爬虫系列5:scrapy动态页面爬取的另一种思路
前面有篇文章给出了爬取动态页面的一种思路,即应用Selenium+Firefox(参考<scrapy动态页面爬取>).但是selenium需要运行本地浏览器,比较耗时,不太适合大规模网页抓 ...
- 第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息 crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多 ...
- 十三 web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多网站,当你浏览器访问时看到的信息,在html源文件里却找不到,由得信息还是滚动条滚动到对应的位置后才显示信息, ...
- [Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息
[Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息 2018-07-21 23:53:02 larger5 阅读数 4123更多 分类专栏: 网络爬虫 版权声明: ...
- 爬虫学习(二)--爬取360应用市场app信息
欢迎加入python学习交流群 667279387 爬虫学习 爬虫学习(一)-爬取电影天堂下载链接 爬虫学习(二)–爬取360应用市场app信息 代码环境:windows10, python 3.5 ...
- 使用python爬取MedSci上的期刊信息
使用python爬取medsci上的期刊信息,通过设定条件,然后获取相应的期刊的的影响因子排名,期刊名称,英文全称和影响因子.主要过程如下: 首先,通过分析网站http://www.medsci.cn ...
随机推荐
- 牛客小白月赛13-H(单调栈+树状数组)
题目链接:https://ac.nowcoder.com/acm/contest/549/H 题意:给一个柱状图,包括每个矩阵的宽度和高度,求能组成的最大矩阵的面积. 思路:显然最大矩阵的高一定为n个 ...
- 【转】【mysql面试】https://blog.csdn.net/hanfazy/article/details/14520437
公司招聘MySQL DBA,也面试了10个2年MySQL DBA工作经验的朋友,谈谈自己的心得,欢迎大家指点. 1 2年MySQL DBA经验 其中许多有水分,一看到简历自我介绍,说公司项目的时 ...
- CPU飙高,频繁GC,怎么排查?
处理过线上问题的同学基本上都会遇到系统突然运行缓慢,CPU 100%,以及Full GC次数过多的问题.当然,这些问题的最终导致的直观现象就是系统运行缓慢,并且有大量的报警. 本文主要针对系统运行缓慢 ...
- oracle sid_name service_name
在工作中也遇到了这种情况,使用oracle这么长时间一直使用的都是SID的概念.也是给自己扩充了一下知识,所以后面在配置oracle数据库连接的时候需要确认拿到的是service还是sid再进行相应的 ...
- 洛谷 P2384 最短路 题解
题面 这道题需要用到一个神奇的知识点:log(n*m)=log(n)+log(m): 所以对所有边权取个log,然后算log的最短路的同时维护乘积即可 #include <bits/stdc++ ...
- java tomcate 启动后cmd 出现乱码
今天windows 启动tomcat 后,出现cmd 乱码 尝试改cmd编码为UTF-8后无效,修改tomcat 注册表CodePage ,cmd 依然乱码, 后来把Conf 目录下的logging. ...
- redis 小结二
1.在redis客户端获取redis 配置文件的某个配置信息(需要先打开redis客户端) config get 配置项 , 如果要列出所有的配置项( CONFIG GET *) 2.在redis ...
- Codeforce1196_D_F
D RGB Substring 题意 给定一个只含RGB三种字符的字符串,问最少修改多少个字符,能使得修改后的字符串存在一个长度为\(k\)的子串是...RGBRGB...这个循环字符串的子串. 分析 ...
- 使用html2canvas实现屏幕截图
相关文件(vue3.0) <script src="https://cdn.jsdelivr.net/bluebird/latest/bluebird.js">< ...
- PC端QQ协议说明,完美搞定QQ智能助手
一. 实验目的: 在虚拟机下NAT模式下通过Wireshark抓包,分析QQ的传输模式.了解QQ在传输信息过程中用到的协议.分析在Nat模式下,信息传输的穿透性. 二. 实验环境: Win7 专业版3 ...