
ES-IK分词器
一、安装
https://www.cnblogs.com/wudequn/p/11001382.html
https://github.com/medcl/elasticsearch-analysis-ik/(官方文档)
二、配置
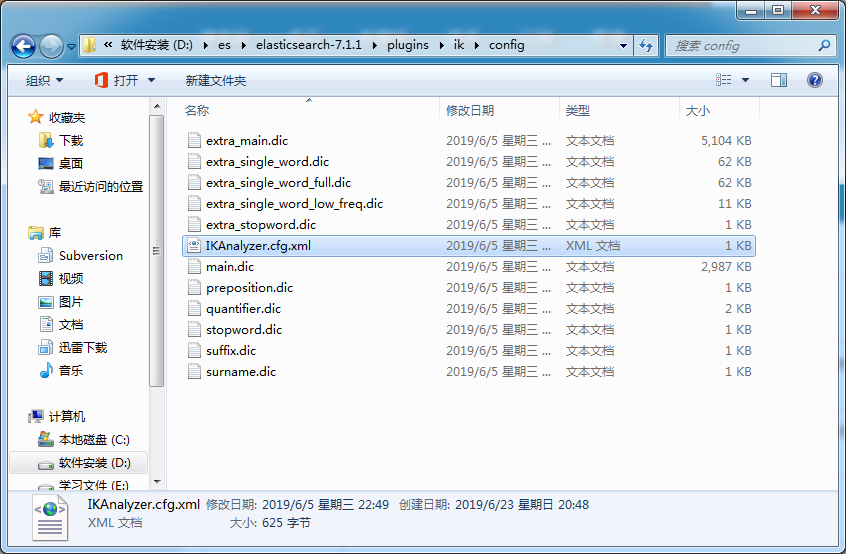
IKAnalyzer.cfg.xml 这个是配置文件,其他的都是自带的分词文件。
    <!--用户可以在这里配置自己的扩展字典 -->

    <entry key="ext_dict"></entry>

     <!--用户可以在这里配置自己的扩展停止词字典-->

    <entry key="ext_stopwords"></entry>
将分词文件填入***.dic <entry key ="exyt_dict">my.dic<entry>中,在重启es。
或者
    <!--用户可以在这里配置远程扩展字典 -->

    <entry key="remote_ext_dict">words_location</entry>

    <!--用户可以在这里配置远程扩展停止词字典-->

    <entry key="remote_ext_stopwords">words_location</entry>
其中location是指一个 url,比如http://*******,该请求只需满足以下两点即可完成分词热更新。
1、该 http 请求需要返回两个头部(header),一个是Last-Modified,一个是ETag,这两者都是字符串类型,只要有一个发生变化,该插件就会去抓取新的分词进而更新词库。
2、该 http 请求返回的内容格式是一行一个分词,换行符用\n即可。
满足上面两点要求可实现热更新分词,不需要重启 ES 实例。
三、测试
https://github.com/medcl/elasticsearch-analysis-ik/ (官网教程 要是跑不通就试试下面的)

mapping相当于指定表中字段 以及 字段类型。这时也可以指定分词。
https://blog.csdn.net/qinyuezhan/article/details/82463340 (mapping 详解)
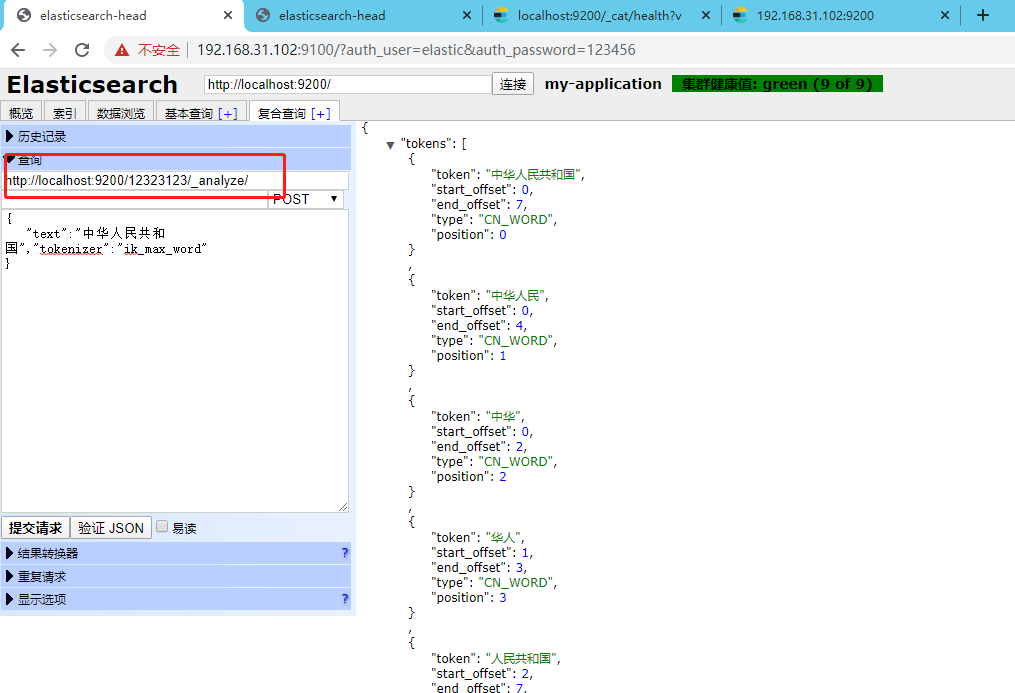
ik_max_word: 会将文本做最细粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,中华人民,中华,华人,人民共和国,人民,人,民,共和国,共和,和,国国,国歌”,会穷尽各种可能的组合,适合 Term Query;
ik_smart: 会做最粗粒度的拆分,比如会将“中华人民共和国国歌”拆分为“中华人民共和国,国歌”,适合 Phrase 查询。
http://localhost:9200/这里是索引名称/_analyze/
ES-IK分词器的更多相关文章
- ES ik分词器使用技巧
match查询会将查询词分词,然后对分词的结果进行term查询. 然后默认是将每个分词term查询之后的结果求交集,所以只要分词的结果能够命中,某条数据就可以被查询出来,而分词是在新建索引时指定的,只 ...
- ES系列一、CentOS7安装ES 6.3.1、集成IK分词器
Elasticsearch 6.3.1 地址: wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-6.3. ...
- 安装ik分词器以及版本和ES版本的兼容性
一.查看自己ES的版本号与之对应的IK分词器版本 https://github.com/medcl/elasticsearch-analysis-ik/blob/master/README.md 二. ...
- es之IK分词器
1:默认的分析器-- standard 使用默认的分词器 curl -XGET 'http://hadoop01:9200/_analyze?pretty&analyzer=standard' ...
- Elasticsearch5.1.1+ik分词器+HEAD插件安装小记
一.安装elasticsearch 1.首先需要安装好java,并配置好环境变量,详细教程请看 http://tecadmin.net/install-java-8-on-centos-rhel-an ...
- elasticsearch 之IK分词器安装
IK分词器地址:https://github.com/medcl/elasticsearch-analysis-ik 安装好ES之后就可以安装分词器插件了 记住选择ES对应的版本 对应的有版本选择下载 ...
- 如何开发自己的搜索帝国之安装ik分词器
Elasticsearch默认提供的分词器,会把每个汉字分开,而不是我们想要的根据关键词来分词,我是中国人 不能简单的分成一个个字,我们更希望 “中国人”,“中国”,“我”这样的分词,这样我们就需要 ...
- elasticsearch安装ik分词器
一.概要: 1.es默认的分词器对中文支持不好,会分割成一个个的汉字.ik分词器对中文的支持要好一些,主要由两种模式:ik_smart和ik_max_word 2.环境 操作系统:centos es版 ...
- ElasticSearch6.5.0 【安装IK分词器】
不得不夸奖一下ES的周边资源,比如这个IK分词器,紧跟ES的版本,卢本伟牛逼!另外ES更新太快了吧,几乎不到半个月一个小版本就发布了!!目前已经发了6.5.2,估计我还没怎么玩就到7.0了. 下载 分 ...
- Elasticsearch入门之从零开始安装ik分词器
起因 需要在ES中使用聚合进行统计分析,但是聚合字段值为中文,ES的默认分词器对于中文支持非常不友好:会把完整的中文词语拆分为一系列独立的汉字进行聚合,显然这并不是我的初衷.我们来看个实例: POST ...
随机推荐
- Pytest权威教程13-Fixture方法及测试用例的参数化
目录 Fixture方法及测试用例的参数化 @pytest.mark.parametrize:参数化测试函数 基本的pytest_generate_tests例子 更多示例 返回: Pytest权威教 ...
- SVN优于CVS之处
1.原子提交.一次提交不管是单个还是多个文件,都是作为一个整体提交的.在这当中发生的意外例如传输中断,不会引起数据库的不完整和数据损坏. 2.重命名.复制.删除文件等动作都保存在版本历史记录当中. 3 ...
- 加入购物车的功能wepy
1.先有一个加入购物车的按钮 <view wx:if="{{(detaildata.boughtNum < detaildata.buy_limit) && de ...
- 开放-封闭原则(OCP)
怎样的升级才能面对需求的改变却可以保持相对稳定,从而使得系统可以在第一个版本以后不断推出新的版本呢?开放-封闭原则(The Open-Closed Principle, OCP)为我们提供了指引.软件 ...
- 深度学习面试题29:GoogLeNet(Inception V3)
目录 使用非对称卷积分解大filters 重新设计pooling层 辅助构造器 使用标签平滑 参考资料 在<深度学习面试题20:GoogLeNet(Inception V1)>和<深 ...
- [转]OpenGL编程指南(第9版)环境搭建--使用VS2017
1.使用CMake Configure中选择VS2017 Win64 , Finish: 点击Generate. 2.进入build目录 打开GLFW.sln , 生成解决方案. 打开vermilio ...
- MySQL not equal to operator <> && !=
MySQL :: MySQL 5.7 Reference Manual :: 12.3.2 Comparison Functions and Operatorshttps://dev.mysql.co ...
- 教你玩转Linux—用户账号的管理
用户账号的管理工作主要涉及到用户账号的添加.修改和删除.添加用户账号就是在系统中创建一个新账号,然后为新账号分配用户号.用户组.主目录和登录Shell等资源.刚添加的账号是被锁定的,无法使用. 1.添 ...
- ISO/IEC 9899:2011 条款6.8——语句和语句块
6.8 语句和语句块 语法 1.statement: labeled-statement compound-statement expression-statement ...
- Python3基础 函数 多值参数 元组与字典形式(使用星号对列表与字典进行拆包)
Python : 3.7.3 OS : Ubuntu 18.04.2 LTS IDE : pycharm-community-2019.1.3 ...