
第三百二十六节,web爬虫,scrapy模块,解决重复ur——自动递归url
第三百二十六节,web爬虫,scrapy模块,解决重复url——自动递归url
一般抓取过的url不重复抓取,那么就需要记录url,判断当前URL如果在记录里说明已经抓取过了,如果不存在说明没抓取过
记录url可以是缓存,或者数据库,如果保存数据库按照以下方式:
id URL加密(建索引以便查询) 原始URL
保存URL表里应该至少有以上3个字段
1、URL加密(建索引以便查询)字段:用来查询这样速度快,
2、原始URL,用来给加密url做对比,防止加密不同的URL出现同样的加密值
自动递归url
# -*- coding: utf-8 -*-

import scrapy       #导入爬虫模块

from scrapy.selector import HtmlXPathSelector  #导入HtmlXPathSelector模块

from scrapy.selector import Selector

class AdcSpider(scrapy.Spider):

    name = 'adc'                                        #设置爬虫名称

    allowed_domains = ['hao.360.cn']

    start_urls = ['https://hao.360.cn/']

    def parse(self, response):

        #这里做页面的各种获取以及处理

        #递归查找url循环执行

        hq_url = Selector(response=response).xpath('//a/@href')   #查找到当前页面的所有a标签的href,也就是url

        for url in hq_url:                                        #循环url

            yield scrapy.Request(url=url, callback=self.parse)    #每次循环将url传入Request方法进行继续抓取,callback执行parse回调函数,递归循环

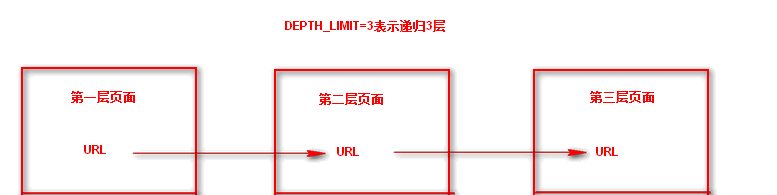
        #这样就会递归抓取url并且自动执行了,但是需要在settings.py 配置文件中设置递归深度,DEPTH_LIMIT=3表示递归3层
这样就会递归抓取url并且自动执行了,但是需要在settings.py 配置文件中设置递归深度,DEPTH_LIMIT=3表示递归3层
第三百二十六节,web爬虫,scrapy模块,解决重复ur——自动递归url的更多相关文章
- 五 web爬虫,scrapy模块,解决重复ur——自动递归url
一般抓取过的url不重复抓取,那么就需要记录url,判断当前URL如果在记录里说明已经抓取过了,如果不存在说明没抓取过 记录url可以是缓存,或者数据库,如果保存数据库按照以下方式: id URL加密 ...
- 第三百二十八节,web爬虫讲解2—urllib库爬虫—状态吗—异常处理—浏览器伪装技术、设置用户代理
第三百二十八节,web爬虫讲解2—urllib库爬虫—状态吗—异常处理—浏览器伪装技术.设置用户代理 如果爬虫没有异常处理,那么爬行中一旦出现错误,程序将崩溃停止工作,有异常处理即使出现错误也能继续执 ...
- 第三百二十三节,web爬虫,scrapy模块以及相关依赖模块安装
第三百二十三节,web爬虫,scrapy模块以及相关依赖模块安装 当前环境python3.5 ,windows10系统 Linux系统安装 在线安装,会自动安装scrapy模块以及相关依赖模块 pip ...
- 第三百二十九节,web爬虫讲解2—urllib库爬虫—ip代理—用户代理和ip代理结合应用
第三百二十九节,web爬虫讲解2—urllib库爬虫—ip代理 使用IP代理 ProxyHandler()格式化IP,第一个参数,请求目标可能是http或者https,对应设置build_opener ...
- 第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签
第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签 标签选择器对象 HtmlXPathSelector()创建标签选择器对象,参数接收response回调的html对象需 ...
- 第三百二十四节,web爬虫,scrapy模块介绍与使用
第三百二十四节,web爬虫,scrapy模块介绍与使用 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了 ...
- 第一百二十六节,JavaScript,XPath操作xml节点
第一百二十六节,JavaScript,XPath操作xml节点 学习要点: 1.IE中的XPath 2.W3C中的XPath 3.XPath跨浏览器兼容 XPath是一种节点查找手段,对比之前使用标准 ...
- 第三百八十六节,Django+Xadmin打造上线标准的在线教育平台—HTML母版继承
第三百八十六节,Django+Xadmin打造上线标准的在线教育平台—HTML母版继承 母板-子板-母板继承 母板继承就是访问的页面继承一个母板,将访问页面的内容引入到母板里指定的地方,组合成一个新页 ...
- 第三百七十六节,Django+Xadmin打造上线标准的在线教育平台—创建用户操作app,在models.py文件生成5张表,用户咨询表、课程评论表、用户收藏表、用户消息表、用户学习表
第三百七十六节,Django+Xadmin打造上线标准的在线教育平台—创建用户操作app,在models.py文件生成5张表,用户咨询表.课程评论表.用户收藏表.用户消息表.用户学习表 创建名称为ap ...
随机推荐
- [Windows Azure] Getting Started with Windows Azure SQL Database
In this tutorial you will learn the fundamentals of Windows Azure SQL Database administration using ...
- ROC曲线(Receiver Operating Characteristic Curve)
分类模型尝试将各个实例(instance)划归到某个特定的类,而分类模型的结果一般是实数值,如逻辑回归,其结果是从0到1的实数值.这里就涉及到如何确定阈值(threshold value),使得模型结 ...
- java double类型保留两位小数4种方法
http://blog.csdn.net/huaishuming/article/details/17752365 ****************************************** ...
- Python爬取爱奇艺【老子传奇】评论数据
# -*- coding: utf-8 -*- import requests import os import csv import time import random base_url = 'h ...
- Thinkphp在Tpl中调用common.php中的公共函数
Common/common.php //产生随机验证码 function random($length, $chars = '0123456789') { //随机生成的逻辑 return $hash ...
- UIButton的竖排图片和文本
UIButton的竖排图片和文本html, body {overflow-x: initial !important;}.CodeMirror { height: auto; } .CodeMirro ...
- mac上校验文件的 md5 sha-1
文件校验 mac md5 sha-1html, body {overflow-x: initial !important;}.CodeMirror { height: auto; } .CodeMir ...
- Ehcache BlockingCache 源码分析
BlockingCache是对Ehcache进行的扩展,BlockingCache内置了读写锁,不需要用户显示调用. 要彻底分析BlockingCache的原理,需要首先来看一下它内部用到的一些类. ...
- Python-OpenCV快速教程
一.Mat生成图片 面的简单代码就可以生成两种表示方式下,图6-1中矩阵的对应的图像,生成图像后,放大看就能体会到区别: import numpy as np import cv2 import ma ...
- Swing获取字符串的宽度和高度
import java.awt.Color; import java.awt.Font; import java.awt.font.FontRenderContext; import java.awt ...