
五 web爬虫,scrapy模块,解决重复ur——自动递归url
一般抓取过的url不重复抓取,那么就需要记录url,判断当前URL如果在记录里说明已经抓取过了,如果不存在说明没抓取过
记录url可以是缓存,或者数据库,如果保存数据库按照以下方式:
id URL加密(建索引以便查询) 原始URL
保存URL表里应该至少有以上3个字段
1、URL加密(建索引以便查询)字段:用来查询这样速度快,
2、原始URL,用来给加密url做对比,防止加密不同的URL出现同样的加密值
自动递归url

# -*- coding: utf-8 -*-

import scrapy       #导入爬虫模块

from scrapy.selector import HtmlXPathSelector  #导入HtmlXPathSelector模块

from scrapy.selector import Selector

class AdcSpider(scrapy.Spider):

    name = 'adc'                                        #设置爬虫名称

    allowed_domains = ['hao.360.cn']

    start_urls = ['https://hao.360.cn/']

    def parse(self, response):

        #这里做页面的各种获取以及处理

        #递归查找url循环执行

        hq_url = Selector(response=response).xpath('//a/@href')   #查找到当前页面的所有a标签的href,也就是url

        for url in hq_url:                                        #循环url

            yield scrapy.Request(url=url, callback=self.parse)    #每次循环将url传入Request方法进行继续抓取,callback执行parse回调函数,递归循环

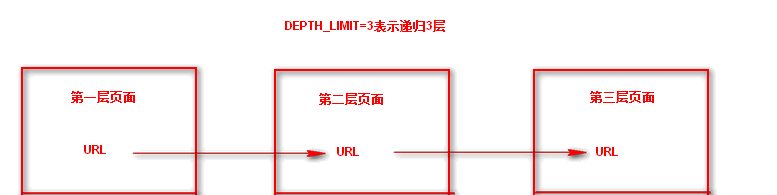
        #这样就会递归抓取url并且自动执行了,但是需要在settings.py 配置文件中设置递归深度,DEPTH_LIMIT=3表示递归3层
这样就会递归抓取url并且自动执行了,但是需要在settings.py 配置文件中设置递归深度,DEPTH_LIMIT=3表示递归3层
五 web爬虫,scrapy模块,解决重复ur——自动递归url的更多相关文章
- 第三百二十六节,web爬虫,scrapy模块,解决重复ur——自动递归url
第三百二十六节,web爬虫,scrapy模块,解决重复url——自动递归url 一般抓取过的url不重复抓取,那么就需要记录url,判断当前URL如果在记录里说明已经抓取过了,如果不存在说明没抓取过 ...
- 爬虫scrapy模块
首先下载scrapy模块 这里有惊喜 https://www.cnblogs.com/bobo-zhang/p/10068997.html 创建一个scrapy文件 首先在终端找到一个文件夹 输入 s ...
- 十五 web爬虫讲解2—urllib库中使用xpath表达式—BeautifulSoup基础
在urllib中,我们一样可以使用xpath表达式进行信息提取,此时,你需要首先安装lxml模块,然后将网页数据通过lxml下的etree转化为treedata的形式 urllib库中使用xpath表 ...
- (4)分布式下的爬虫Scrapy应该如何做-规则自动爬取及命令行下传参
本次探讨的主题是规则爬取的实现及命令行下的自定义参数的传递,规则下的爬虫在我看来才是真正意义上的爬虫. 我们选从逻辑上来看,这种爬虫是如何工作的: 我们给定一个起点的url link ,进入页面之后提 ...
- 第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签
第三百二十五节,web爬虫,scrapy模块标签选择器下载图片,以及正则匹配标签 标签选择器对象 HtmlXPathSelector()创建标签选择器对象,参数接收response回调的html对象需 ...
- 第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码
第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码 打码接口文件 # -*- coding: cp936 -*- import sys import os ...
- 第三百二十四节,web爬虫,scrapy模块介绍与使用
第三百二十四节,web爬虫,scrapy模块介绍与使用 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了 ...
- 第三百二十三节,web爬虫,scrapy模块以及相关依赖模块安装
第三百二十三节,web爬虫,scrapy模块以及相关依赖模块安装 当前环境python3.5 ,windows10系统 Linux系统安装 在线安装,会自动安装scrapy模块以及相关依赖模块 pip ...
- 二 web爬虫,scrapy模块以及相关依赖模块安装
当前环境python3.5 ,windows10系统 Linux系统安装 在线安装,会自动安装scrapy模块以及相关依赖模块 pip install Scrapy 手动源码安装,比较麻烦要自己手动安 ...
随机推荐
- 创建使用pycharm virtualenv
创建使用pycharm virtualenv 在python的世界里,真该感谢有PyCharm,pip,virtualenv 这些好东东,为python程序员提供了极大的方便. virtualenv ...
- OVN实战---《A Primer on OVN》翻译
overview 在本文中,我们将在三个host之间创建一个简单的二层overlay network.首先,我们来简单看一下,整个系统是怎么工作的.OVN基于分布式的control plane,其中各 ...
- 携程greenlet模块使用
import greenlet def f1(): print(11) gr2.switch() print(22) gr2.switch() def f2(): print(33) gr1.swit ...
- (3.8)常用知识-临时表、表变量、CTE的对比
转自:https://www.cnblogs.com/xiaozhi1236/p/5895935.html 深入了解:https://www.cnblogs.com/kissdodog/archive ...
- 爬虫任务一:使用httpclient去爬取百度新闻首页的新闻标题和url,编码是utf-8
第一个入手的爬虫小任务: maven工程 <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi=" ...
- rtsp over udp
#include <stdio.h> #include <netinet/in.h> #include <sys/socket.h> #include <st ...
- 编译原理课后习题答案令A,B和C是任意正规式,证明以下关系成立(A|B)*=(A*B*)*=(A*|B*)*
题目: 令A.B和C是任意正规式,证明以下关系成立: A∣A=A (A*)*= A* A*=ε∣A A* (AB)*A=A(BA)* (A∣B)*=(A*B ...
- 4 TensorFlow入门之dropout解决overfitting问题
------------------------------------ 写在开头:此文参照莫烦python教程(墙裂推荐!!!) ---------------------------------- ...
- boost atomic
文档: http://www.boost.org/doc/libs/1_53_0/doc/html/atomic.html Presenting Boost.Atomic Boost.Atomic i ...
- 操作系统(Day2.5)
一.为何要有操作系统 现代的计算机系统主要是由一个或者多个处理器,主存,硬盘,键盘,鼠标,显示器,打印机,网络接口及其他输入输出设备组成. 程序员无法把所有的硬件操作细节都了解到,管理这些硬件并且加以 ...