
大数据笔记(四)——操作HDFS
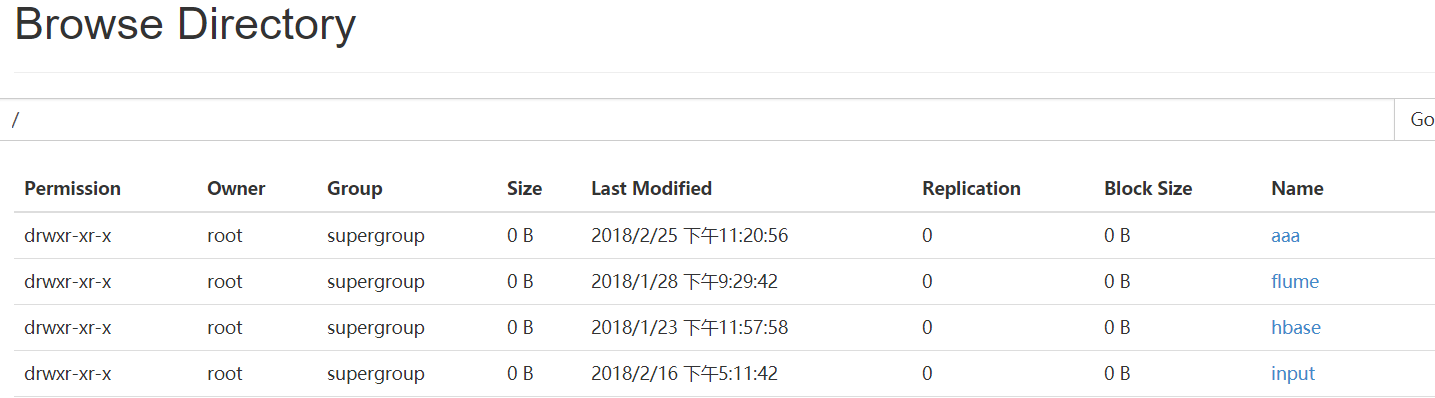
一.Web Console:端口50070
二.HDFS的命令行操作
(一)普通操作命令
HDFS 操作命令帮助信息: hdfs dfs + Enter键
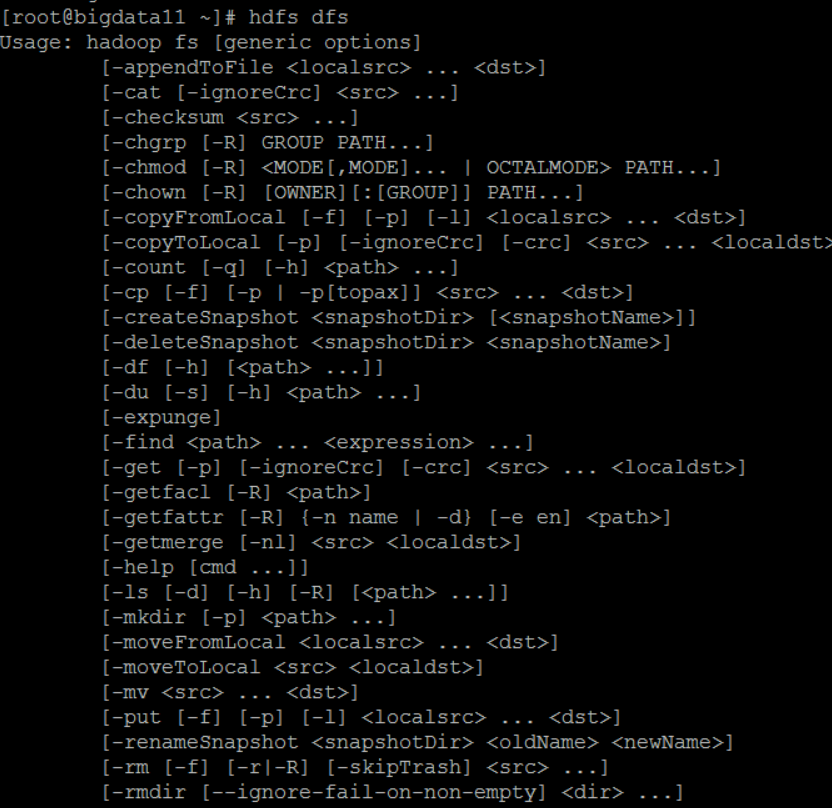
常见命令
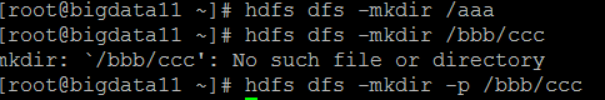
1. -mkdir
- 在HDFS上创建目录:hdfs dfs -mkdir /aaa
- 如果父目录不存在,使用 -p 命令先创建父目录:
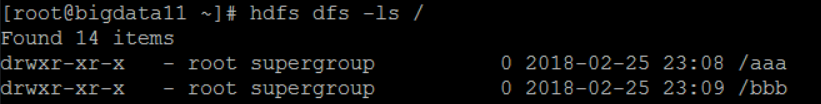
2. -ls /
查看hdfs文件系统根目录下的目录和文件:
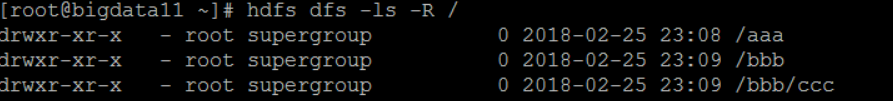
3.-ls -R /
查看所有目录和文件:
4.-put
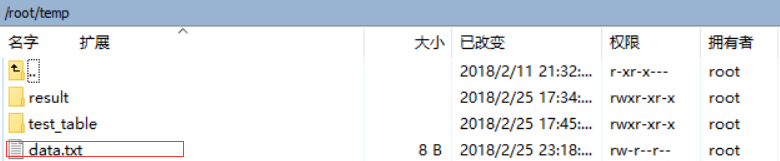
上传数据:将本地Linux文件data.txt上传到HDFS的aaa目录下
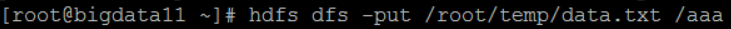
-copyFromLocal 上传数据,类似-put
-moveFromLocal 上传数据,类似-put,相当于ctrl+x
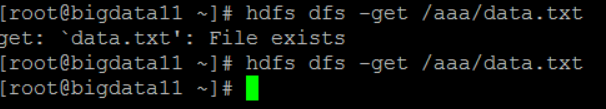
5.-get 下载数据(刚才上传数据时已经有data.txt,所以要把Linux目录下的data.txt先删除)
6.-rm: 删除目录
-rmr: 删除目录,包括子目录
hdfs dfs -rmr /bbb
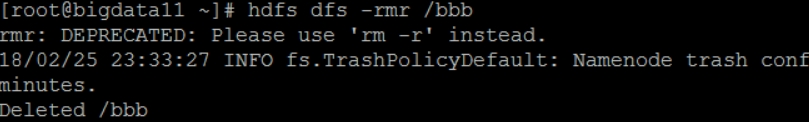
7. -getmerge:把某个目录下的文件,合并后再下载
8.-cp:拷贝 hdfs dfs -cp /input/data.txt /input/data2.txt
9.-mv:移动 hdfs dfs -cp /input/data.txt /aaa/a.txt
10.-count 统计hdfs对应路径下的目录个数,文件个数,文件总计大小:hdfs dfs -count /students

11.-du 显示hdfs对应路径下每个文件夹和目录的大小 hdfs dfs -du /students
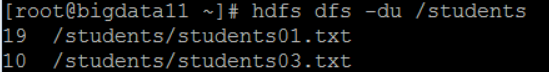
12.-cat 查看文本的内容 hdfs dfs -cat /input/data.txt
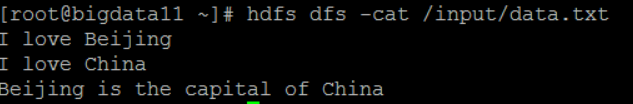
13.balancer:平衡操作 如果管理员发现某些DataNode上保存数据过多,某些过少,就可以采取此操作
(二)管理命令:hdfs dfsadmin
举例:
1.-report 打印hdfs的报告 hdfs dfsadmin -report
2.-safemode:安全模式(安全模式下对hdfs只能进行只读操作)
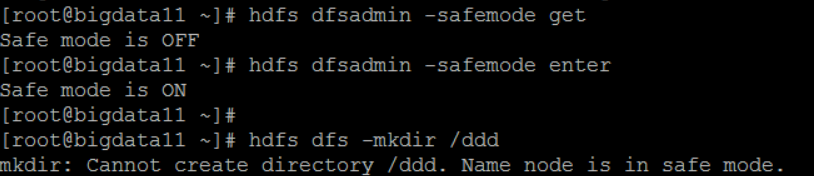

三.JavaAPI
通过HDFS提供的JavaAPI,我们可以完成以下的功能:
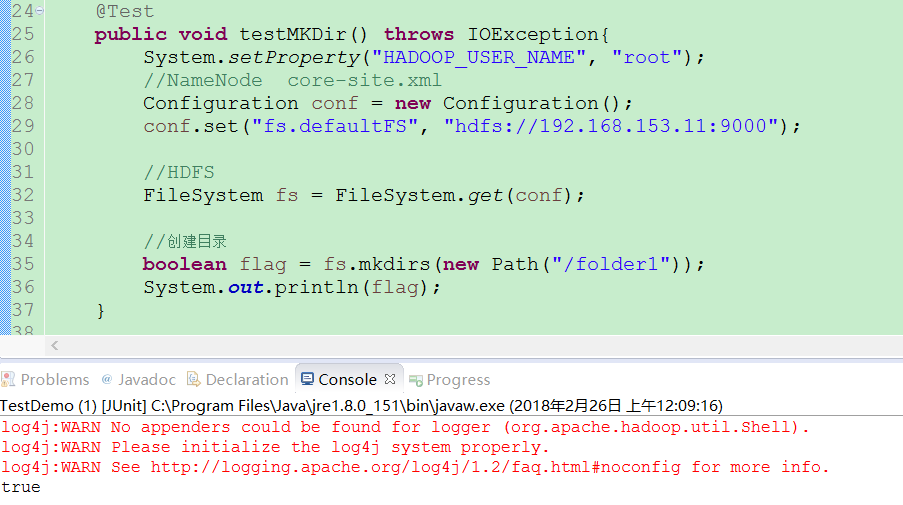
(一)在HDFS上创建目录
(二)写入数据(上传文件)
import java.io.FileInputStream;

import java.io.IOException;

import java.io.InputStream;

import java.io.OutputStream;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.junit.Test;

import com.jcraft.jsch.Buffer;

public class TestUpload {

    @Test

    public void testUpload() throws IOException{

        System.setProperty("HADOOP_USER_NAME", "root");

        //NameNode   core.site.xml

        Configuration conf = new Configuration();

        conf.set("fs.defaultFS", "hdfs://192.168.153.11:9000");

        //构造一个输入流 <---HDFS

        FileSystem fs = FileSystem.get(conf);

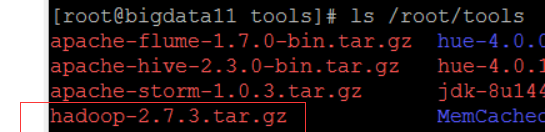
        InputStream in = new FileInputStream("D:\\temp\\hadoop-2.7.3.tar.gz");

        //构造一个输出流------> HDFS

        OutputStream out = fs.create(new Path("/tools/hadoop-2.7.3.tar.gz"));

        byte[] buffer = new byte[1024];

        int len = 0;

        while ((len=in.read(buffer)) > 0) {

            out.write(buffer, 0, len);

        }

        out.flush();

        in.close();

        out.close();

    }

}
(三)通过 FileSystem API 读取数据(下载文件)
(四)查看目录及文件信息
(五)查找某个文件在HDFS集群的位置
(六)删除数据
(七)获取HDFS集群上所有数据节点信息

大数据笔记(四)——操作HDFS的更多相关文章
- 大数据学习——java操作hdfs环境搭建以及环境测试
1 新建一个maven项目 打印根目录下的文件的名字 添加pom依赖 pom.xml <?xml version="1.0" encoding="UTF-8&quo ...
- 大数据系列2:Hdfs的读写操作
在前文大数据系列1:一文初识Hdfs中,我们对Hdfs有了简单的认识. 在本文中,我们将会简单的介绍一下Hdfs文件的读写流程,为后续追踪读写流程的源码做准备. Hdfs 架构 首先来个Hdfs的架构 ...
- Dapper学习(四)之Dapper Plus的大数据量的操作
这篇文章主要讲 Dapper Plus,它使用用来操作大数量的一些操作的.比如插入1000条,或者10000条的数据时,再使用Dapper的Execute方法,就会比较慢了.这时候,可以使用Dappe ...
- 大数据笔记04:大数据之Hadoop的HDFS(基本概念)
1.HDFS是什么? Hadoop分布式文件系统(HDFS),被设计成适合运行在通用硬件(commodity hardware)上的分布式文件系统.它和现有的分布式文件系统有很多共同点. 2.HDFS ...
- 大数据笔记09:大数据之Hadoop的HDFS使用
1. HDFS使用: HDFS内部中提供了Shell接口,所以我们可以以命令行的形式操作HDFS
- 大数据-hadoop生态之-HDFS
一.HDFS初识 hdfs的概念: HDFS,它是一个文件系统,用于存储文件,通过目录树定位文件,其次,他是分布式的,由很多服务器联合起来 实现功能,集群中的服务器各有各自的角色 HDFS设计适合一次 ...
- 大数据 - hadoop基础概念 - HDFS
Hadoop之HDFS的概念及用法 1.概念介绍 Hadoop是Apache旗下的一个项目.他由HDFS.MapReduce.Hive.HBase和ZooKeeper等成员组成. HDFS是一个高度容 ...
- 大数据【二】HDFS部署及文件读写(包含eclipse hadoop配置)
一 原理阐述 1' DFS 分布式文件系统(即DFS,Distributed File System),指文件系统管理的物理存储资源不一定直接连接在本地节点上,而是通过计算机网络与节点相连.该系统架构 ...
- 大数据【四】MapReduce(单词计数;二次排序;计数器;join;分布式缓存)
前言: 根据前面的几篇博客学习,现在可以进行MapReduce学习了.本篇博客首先阐述了MapReduce的概念及使用原理,其次直接从五个实验中实践学习(单词计数,二次排序,计数器,join,分 ...
- 大数据:Hadoop(HDFS 的设计思路、设计目标、架构、副本机制、副本存放策略)
一.HDFS 的设计思路 1)思路 切分数据,并进行多副本存储: 2)如果文件只以多副本进行存储,而不进行切分,会有什么问题 缺点 不管文件多大,都存储在一个节点上,在进行数据处理的时候很难进行并行处 ...
随机推荐
- RocketMQ高可用集群
集群支持: RocketMQ天生对集群的支持非常友好 单Master: 优点:除了配置简单没什么优点 缺点:不可靠,该机器重启或宕机,将导致整个服务不可用 多Master: 优点:配置简单,性能最高 ...
- IDEA导入Junit jar包,在JavaSE的Module中使用Junit测试
写代码时偶尔想试一下自己的小想法,于是在IDEA中建了一个JavaEE项目.JavaEE项目中只能在main方法中运行代码块,不如单元测试的@Test灵活. 于是在网上找到了Junit的jar包:Do ...
- dp基础√
1.重叠子问题 2.能从小问题推到大问题 Dp: 设计状态+状态转移 状态: 1.状态表示: 是对当前子问题的解的局面集合的一种(充分的)描述.(尽量简洁qwq) ◦ 对于状态的表示 ...
- 最少多少人说谎(dp)
https://ac.nowcoder.com/acm/contest/1168/H 题意:n个学生,邓志聪想知道这些学生的考试情况,于是一个一个叫这些学生叫去办公室问他们,但是有些学生并没有讲真话, ...
- [集合]HashMap和Hashtable区别
底层 哈希算法,双列集合 HashMap 线程不安全,效率高,JDK1.2版本 Hashtable 线程安全,效率低,JDK1.0版本 HashMap 可以存储 null 键和 null 值 ...
- Django使用Celery进行异步任务
Celery Celery是一个功能完备即插即用的异步任务队列系统.它适用于异步处理问题,当发送邮件.或者文件上传, 图像处理等等一些比较耗时的操作,我们可将其异步执行,这样用户不需要等待很久,提高用 ...
- django中的FBV和CBV??
django中请求处理方式有2种:FBV 和 CBV 一.FBV FBV(function base views) 就是在视图里使用函数处理请求. 看代码: urls.py from django.c ...
- jupyter与requests的初步使用
upyter 是一个简易的,方便的写Python代码的工具包,requests是Python里非常好用的用来发送 http 请求的包. 开始学习本教程之前,请确保你已经安装了Python,并且安装了P ...
- LNMP环境搭建哈哈
经过一番折腾,终于将LNMP环境搭建完成了.本文介绍的LNMP环境是在windows的Oracle VM VirtualBox中的Centos虚拟机上搭建的,各个软件的版本为:Centos7 + Ng ...
- Math、Date内置对象方法整理
Math : 内置的对象(构造函数)静态属性或静态方法. 一. Math.PI : 圆周率 ...