
CMU Database Systems - Query Processing
Query Model
Query处理有三种方式,

首先是Iterator model,这是最基本的model,又称为volcano,pipeline模式
他是top-down的模式,通过next函数去逐层获取tuple
好处是比较简单,并且很容易做limit
iterator的例子,
输出一个数据,从top开始调用next,这里第二步需要join,建hashtable,需要把3的数据全部读取上来

第二种方式,materialization model
反其道,这是一种bottom-up的方式,每个把数据都准备好后,往上传递
这种方式,明显适合TP,对于AP会产生大量的中间结果,
而且不好控制limit,limit1,底下节点可能也要把所有的数据都读出来
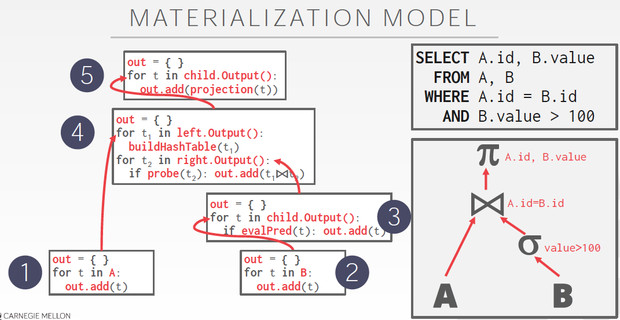
Materailization Model的例子,
多了个out,来记录返回的全量结果
Vectorization Model
向量化模型,iterator的时候每次取一个batch,而不是一个tuple
这样大大降低next的调用频率,而且可以更好的利用SIMD进行并行处理
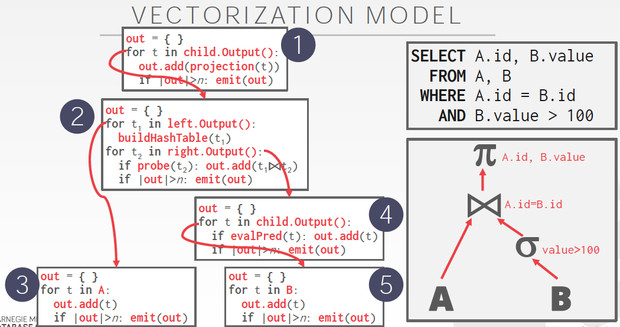
Vectorization Model的例子,
加上对out大小的判断以形成batch
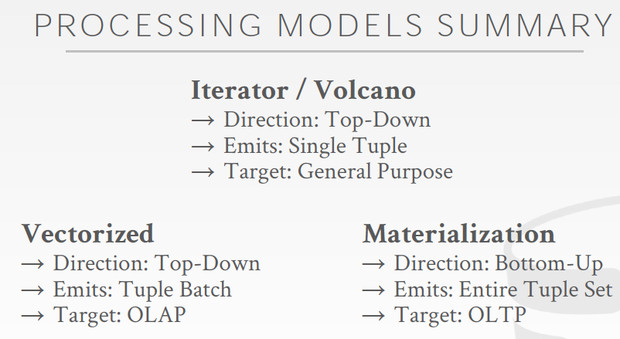
3种模型的区别如下,
Access Methods
刚刚的查询计划里面,只是说读取数据,但是没有怎么说如何读取数据
Access Methods就是说明如何从数据库中读取数据的
Access Methods也有三种,
Sequentail Scan,Index Scan, Multi-Index/'Bitmap' Scan
Sequential Scan
顺序读,就是一个个page这么读过去,然后用一个内部的cursor去记录读到哪儿了

顺序读会比较慢,但有时是无法避免的
优化的方法如下,
预取,并行化,bypass bufferPool,都是前面说过的优化

Zone Maps
在每个page上加上一些统计信息,又称为pre-computed aggregates
这样我就可以根据这个信息来判断是否需要读这个page

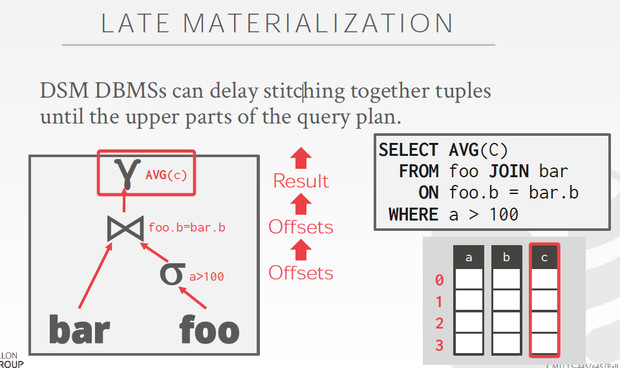
Late Materialization
这个只能用于列存,因为列存才能一次读一列,
所以在前两个过滤条件上,我们只需要把offset传上来,不需要原始数据
到最后一步,才需要把C这一列真正的materialization出来
Heap Clustering
Tuples在pages中是按照clustering index排序的,所以根据clustering index进行query是非常高效的

但是如果要按非clustered index的字段进行排序,就是比较低效的
因为tuples会分布在不同的pages中,你需要混着读
一个优化是,把所有要读的tuples按page id进行排序,然后一个个page顺序读过来会比较高效

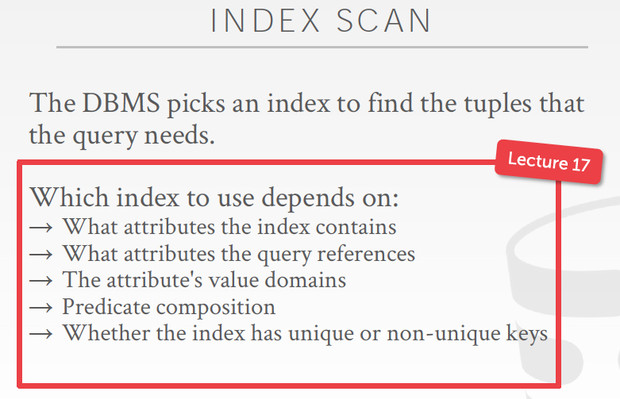
Index Scan
关键就是如何pick合适的index来进行查询,这个比较复杂,在后面会详细描述
Multi-index Scan
同时用多个index进行索引,
然后对多个索引的结果集,进行union和intersect,最终得到结果
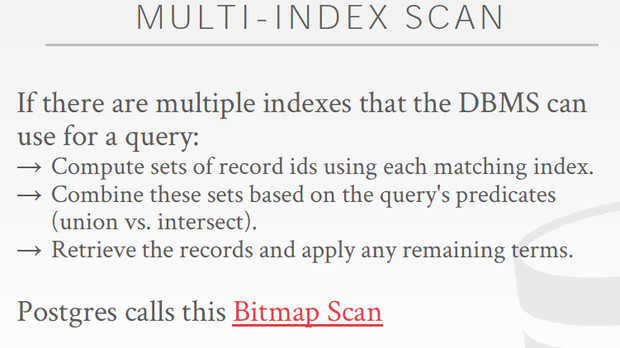
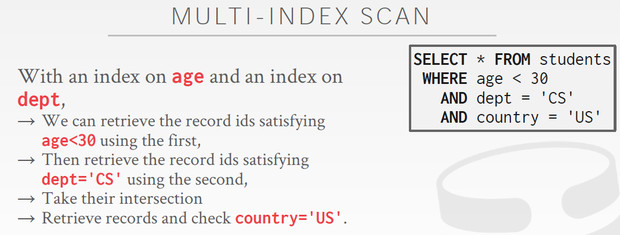
intersection往往通过bitmaps,hash tables,bloom filters来实现,所以有时也称为Bitmap Scan

Expression Evaluation
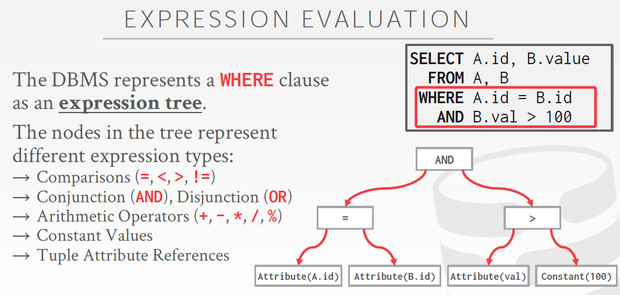
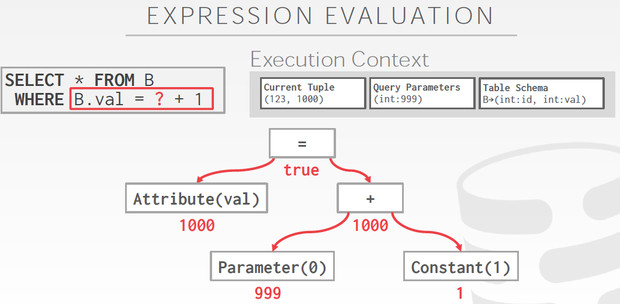
SQL中的表达式,可以通过expression tree来表示,这种方式很灵活,但是性能比较差,所以比较高效的方式是直接codegen
CMU Database Systems - Query Processing的更多相关文章
- CMU Database Systems - Query Optimization
查询优化应该是数据库领域最难的topic 当前查询优化,主要有两种思路, Rules-based,基于先验知识,用if-else把优化逻辑写死 Cost-based,试图去评估各个查询计划的cost, ...
- CMU Database Systems - Database Recovery
数据库数据丢失的典型场景如下, 数据commit后,还没有来得及flush到disk,这时候crash就会丢失数据 当然这只是fail的一种情况,DataBase Recovery要讨论的是,在各种f ...
- CMU Database Systems - Storage and BufferPool
Database Storage 存储分为volatile和non-volatile,越快的越贵越小 那么所以要解决的第一个问题就是,如果尽量在有限的成本下,让读写更快些 意思就是,尽量读写volat ...
- CMU Database Systems - Timestamp Ordering Concurrency Control
2PL是悲观锁,Pessimistic,这章讲乐观锁,Optimistic,单机的,非分布式的 Timestamp Ordering,以时间为序,这个是非常自然的想法,按每个transaction的时 ...
- CMU Database Systems - Concurrency Control Theory
并发控制是数据库理论里面最难的课题之一 并发控制首先了解一下事务,transaction 定义如下, 其实transaction关键是,要满足ACID属性, 左边的正式的定义,由于的intuitive ...
- CMU Database Systems - Parallel Execution
并发执行,主要为了增大吞吐,降低延迟,提高数据库的可用性 先区分一组概念,parallel和distributed的区别 总的来说,parallel是指在物理上很近的节点,比如本机的多个线程或进程,不 ...
- CMU Database Systems - Two-phase Locking
首先锁是用来做互斥的,解决并发执行时的数据不一致问题 如图会导致,不可重复读 如果这里用lock就可以解决,数据库里面有个LockManager来作为master,负责锁的记录和授权 数据库里面的基本 ...
- CMU Database Systems - Distributed OLTP & OLAP
OLTP scale-up和scale-out scale-up会有上限,无法不断up,而且相对而言,up升级会比较麻烦,所以大数据,云计算需要scale-out scale-out,就是分布式数据库 ...
- CMU Database Systems - MVCC
MVCC是一种用空间来换取更高的并发度的技术 对同一个对象不去update,而且记录下每一次的不同版本的值 存在不会消失,新值并不能抹杀原先的存在 所以update操作并不是对世界的真实反映,这是一种 ...
随机推荐
- nginx反向代理实现均衡负载及调度方法
http upstream配置参数: ngx_http_upstream_module模块将多个服务器定义成服务器组,而由proxy_pass, fastcgi_pass等指令进行引用 upstrea ...
- github markdown语法及使用
历史 Markdown是一种轻量级标记语言,创始人为约翰·格鲁伯(英语:John Gruber).它允许人们"使用易读易写的纯文本格式编写文档,然后转换成有效的XHTML(或者HTML)文档 ...
- tensorflow 与cuda、cudnn的对应版本关系
来源:https://www.cnblogs.com/zzb-Dream-90Time/p/9688330.html
- house买房原理,2019,第一版
,购买框架 1,通过自己的买房预算金额 和 pre-approval 确定你要的房屋总价, 估计到自己可以接受的房子,卖方也喜欢这样的买家,但不一定能拿全额贷款 2,pre-approval对信用分数 ...
- SP1825 【FTOUR2 - Free tour II】
# \(SP1825\) 看到没有人用老师的办法,于是自己写一下思路 思路第一步:排除旧方法 首先这道题和\(4178\)不一样,因为那道题是计数,而这道题是求最值,最值有个坏处,就是对于来自相同子树 ...
- RookeyFrame Bug 表单管理 -> 查看表单 ->编辑字段页面 JS报错
表单管理 -> 查看表单 ->编辑字段页面 小bug onchange里面直接就是方法,修改:去掉外面的function(){},直接把方法体写在onchange里面就可以了. 后台方法: ...
- P1168 中位数(线段树)
题目描述 给出一个长度为N的非负整数序列A[i],对于所有1 ≤ k ≤ (N + 1) / 2,输出A[1], A[3], …, A[2k - 1]的中位数.即前1,3,5,……个数的中位数. 输入 ...
- python 之 列表常用 操作
- 安装wazuh-agent
安装wazuh-agent 1. windows 下载地址:https://packages.wazuh.com/3.x/windows/wazuh-agent-3.9.5-1.msi 安装运行 设置 ...
- C语言scanf函数返回值小记
scanf scanf是C标准库stdio里面定义的用于获取用户输入的函数,具体的介绍可以在CppReference上看到.scanf的返回值是已经成功赋值的变量个数,也就是说在 scanf(&quo ...