
scrapy框架爬取开源中国项目大厅所有的发布项目。
本文爬取的字段,项目名称,发布时间,项目周期,应用领域,最低报价,最高报价,技术类型
1,items中定义爬取字段。
import scrapy

class KaiyuanzhongguoItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    name = scrapy.Field()

    publishTime = scrapy.Field()

    cycle = scrapy.Field()

    application = scrapy.Field()

    budgetMinByYuan = scrapy.Field()

    budgetMaxByYuan = scrapy.Field()

    ski = scrapy.Field()
2, 爬虫主程序
# -*- coding: utf-8 -*-
import scrapy
import json
from kaiyuanzhongguo.items import KaiyuanzhongguoItem
class KyzgSpider(scrapy.Spider):
name = 'kyzg'
# allowed_domains = ['www.xxx.com']
base_url = 'https://zb.oschina.net/project/contractor-browse-project-and-reward?pageSize=10¤tPage='
start_urls = ['https://zb.oschina.net/project/contractor-browse-project-and-reward?pageSize=10¤tPage=1']
def parse(self, response):
result = json.loads(response.text)
totalpage = result['data']['totalPage']
for res in result['data']['data']:
item = KaiyuanzhongguoItem()
item['name'] = res['name']
item['publishTime'] = res['publishTime']
item['cycle'] = res['cycle']
item['application'] = res['application']
item['budgetMinByYuan'] = res['budgetMinByYuan']
item['budgetMaxByYuan'] = res['budgetMaxByYuan']
skillList = res['skillList']
skill = []
item['ski'] = ''
if skillList:
for sk in skillList:
skill.append(sk['value'])
item['ski'] = ','.join(skill)
yield item
for i in range(2,totalpage+1):
url_info = self.base_url+str(i)
yield scrapy.Request(url=url_info,callback=self.parse)
3,数据库设计
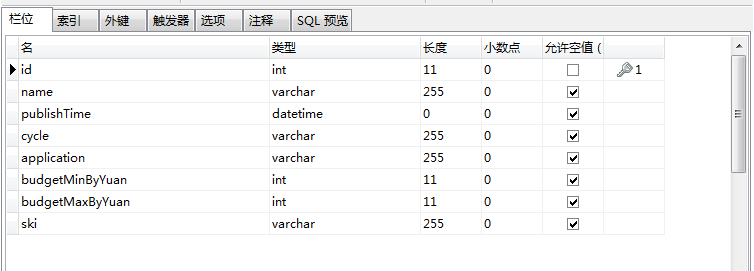
4,pipelines.py文件中写入mysql数据库
# 写入mysql数据库

import pymysql

class KaiyuanzhongguoPipeline(object):

    conn = None

    mycursor = None

    def open_spider(self, spider):

        self.conn = pymysql.connect(host='172.16.25.4', user='root', password='root', db='scrapy')

        self.mycursor = self.conn.cursor()

    def process_item(self, item, spider):

        print(':正在写数据库...')

        sql = 'insert into kyzg VALUES (null,"%s","%s","%s","%s","%s","%s","%s")' % (

            item['name'], item['publishTime'], item['cycle'], item['application'], item['budgetMinByYuan'], item['budgetMaxByYuan'], item['ski'])

        bool = self.mycursor.execute(sql)

        self.conn.commit()

        return item

    def close_spider(self, spider):

        print('写入数据库完成...')

        self.mycursor.close()

        self.conn.close()
5,settings.py文件中设置请求头和打开下载管道
USER_AGENT = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71 Safari/537.36'

ITEM_PIPELINES = {

   'kaiyuanzhongguo.pipelines.KaiyuanzhongguoPipeline': 300,

}
6,运行爬虫
scrapy crawl kyzg --nolog
7,查看数据库是否写入成功

done。
scrapy框架爬取开源中国项目大厅所有的发布项目。的更多相关文章
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- 基于python的scrapy框架爬取豆瓣电影及其可视化
1.Scrapy框架介绍 主要介绍,spiders,engine,scheduler,downloader,Item pipeline scrapy常见命令如下: 对应在scrapy文件中有,自己增加 ...
- scrapy框架爬取糗妹妹网站妹子图分类的所有图片
爬取所有图片,一个页面的图片建一个文件夹.难点,图片中有不少.gif图片,需要重写下载规则, 创建scrapy项目 scrapy startproject qiumeimei 创建爬虫应用 cd qi ...
- scrapy框架爬取妹子图片
首先,建立一个项目#可在github账户下载完整代码:https://github.com/connordb/scrapy-jiandan2 scrapy startproject jiandan2 ...
- 使用scrapy框架爬取自己的博文(3)
既然如此,何不再抓一抓网页的文字内容呢? 谷歌浏览器有个审查元素的功能,就是按树的结构查看html的组织形式,如图: 这样已经比较明显了,博客的正文内容主要在div 的class = cnblogs_ ...
随机推荐
- Unable to create application 异常
这个错误是空指针,但你怎么去找就是找不到为什么会空指针 这时,你要去检查Application 中是否有重写的方法例如这个 @Override protected void attachBaseC ...
- Windows下同时安装了Python2与Python3时如何使用RobotFrameWork
由于windows下不能像linux那样指定python文件的运行路径,当电脑中即安装了python2,又安装了python3时,也不能在环境变量中都配置运行路径吧(当然是可以配置的,系统会按照靠前的 ...
- 在Gridview 中 对日期格式的控制
在数据库中保存日期格式的时候,我们需要在客户端的显示有自己的要求 这就需要对 datatime 类型的数据进行控制,使之显示为你需要的格式 数据库中 如果不对其进行控制,显示的格式为 当在前端页面上进 ...
- repost: Deep Reinforcement Learning
From: http://wanghaitao8118.blog.163.com/blog/static/13986977220153811210319/ accessed 2016-03-10 深度 ...
- 16 SpringMVC 的请求参数的绑定与常用注解
1.SpringMVC 绑定请求参数 (1)支持的数据类型 基本类型参数: 包括基本类型和 String 类型POJO 类型参数: 包括实体类,以及关联的实体类数组和集合类型参数: 包括 List 结 ...
- xe.10.2的下载路径
为了这个玩意,我折腾了一天,为了以后自己还用到 官网地址: http://altd.embarcadero.com/download/radstudio/10.2/delphicbuilder10_2 ...
- Go基础编程实践(七)—— 并发
同时运行多个函数 观察常规代码和并发代码的输出顺序. // 常规代码,顺序执行,依次输出 package main import ( "fmt" "time" ...
- Python-记事本
1.文本颜色 格式:\[显示方式;前景色;背景色m要打印的字符串\[0m 2.format 格式 print('{}的三次方为{:*^20}'.format(a,pow(a, 3))) print(& ...
- emmet css 缩写
css 缩写 对于CSS语法,Emmet有许多用于属性的预定义代码段.例如,您可以扩展 m 缩写以获取margin: ;代码段. 要获取 margin: 10px;您可以简单地扩展m10缩写. 需要多 ...
- 《JAVA高并发编程详解》-并发编程有三个至关重要的特性:原子性,有序性,可见性