
scrapy-splash抓取动态数据例子十一
一、介绍
本例子用scrapy-splash抓取活动树网站给定关键字抓取活动信息。
给定关键字:数字;融合;电视
抓取信息内如下:
1、资讯标题
2、资讯链接
3、资讯时间
4、资讯来源
二、网站信息
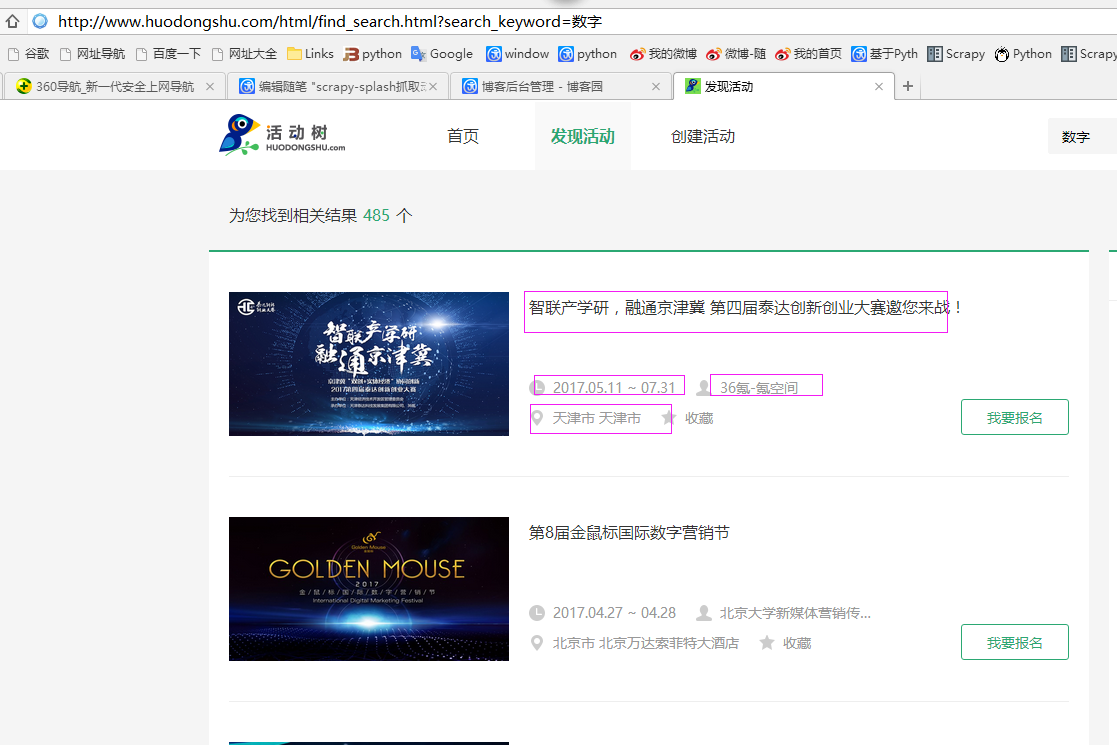
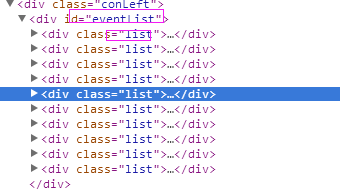
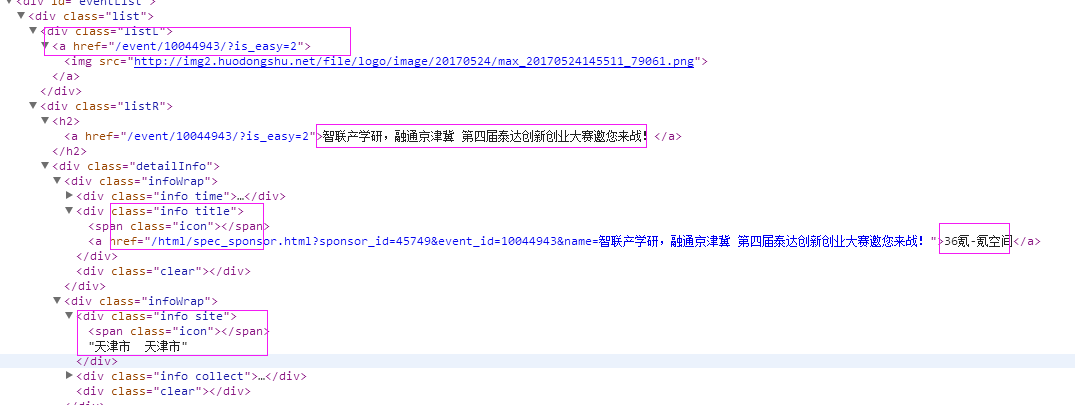
三、数据抓取
针对上面的网站信息,来进行抓取
1、首先抓取信息列表
抓取代码:sels = site.xpath("//div[@id ='eventList']/div[@class ='list']")
2、抓取标题
抓取代码:title = str(sel.xpath('.//div[2]/h2/a/text()')[0].extract())
3、抓取链接
抓取代码:url = 'http://www.huodongshu.com' + str(sel.xpath('.//div[1]/a/@href')[0].extract())
4、抓取日期
抓取代码:dates = sel.xpath('.//div[@class="info time"]/text()')
5、抓取来源
抓取代码:sources = sel.xpath('.//div[@class="info title"]/a/text()')
6、地点
抓取代码:areas = sel.xpath('.//div[@class="info site"]/text()')
四、完整代码
# -*- coding: utf-8 -*-

import scrapy

from scrapy import Request

from scrapy.spiders import Spider

from scrapy_splash import SplashRequest

from scrapy_splash import SplashMiddleware

from scrapy.http import Request, HtmlResponse

from scrapy.selector import Selector

from scrapy_splash import SplashRequest

from splash_test.items import SplashMeetingItem

import IniFile

import sys

import os

import re

import time

reload(sys)

sys.setdefaultencoding('utf-8')

import urllib

# sys.stdout = open('output.txt', 'w')

class huodongshuSpider(Spider):

    name = 'huodongshu'

    configfile = os.path.join(os.getcwd(), 'splash_test\spiders\setting.conf')

    cf = IniFile.ConfigFile(configfile)

    meeting_wordlist = cf.GetValue("section", "meeting_keywords").split(';')

    websearch_url = cf.GetValue("huodongshu", "websearchurl")

    start_urls = []

    for keyword in meeting_wordlist:

        url = websearch_url +keyword

        start_urls.append(url)

    # request需要封装成SplashRequest

    def start_requests(self):

        for url in self.start_urls:

            index = url.rfind('=')

            yield SplashRequest(url

                                , self.parse

                                , args={'wait': ''},

                                meta={'keyword': url[index + 1:]}

                                )

    def compareDate(self, dateLeft, dateRight):

        '''

        比较俩个日期的大小

        :param dateLeft: 日期 格式2017-03-04

        :param dateRight:日期 格式2017-03-04

        :return: 1:左大于右,0:相等,-1:左小于右

        '''

        dls = dateLeft.split('-')

        drs = dateRight.split('-')

        if len(dls) > len(drs):

            return 1

        if int(dls[0]) == int(drs[0]) and int(dls[1]) == int(drs[1]) and int(dls[2]) == int(drs[2]):

            return 0

        if int(dls[0]) > int(drs[0]):

            return 1

        elif int(dls[0]) == int(drs[0]) and int(dls[1]) > int(drs[1]):

            return 1

        elif int(dls[0]) == int(drs[0]) and int(dls[1]) == int(drs[1]) and int(dls[2]) > int(drs[2]):

            return 1

        return -1

    def date_isValid(self, strDateText):

        '''

        判断日期时间字符串是否合法:如果给定时间大于当前时间是合法,或者说当前时间给定的范围内

        :param strDateText: 三种格式 '2017.04.27 ~ 04.28'; '2017.04.20  08:30 ~ 12:30' ; '2015.12.29 ~ 2016.01.03'

        :return: True:合法;False:不合法

        '''

        datePattern = re.compile(r'\d{4}-\d{2}-\d{2}')

        date = strDateText.replace('.', '-')

        strDate = re.findall(datePattern, date)

        currentDate = time.strftime('%Y-%m-%d')

        flag = False

        startdate = ''

        enddate = ''

        if len(strDate) == 2:

            if self.compareDate(strDate[1], currentDate) > 0:

                flag = True

                startdate = strDate[0]

                enddate = strDate[1]

        elif len(strDate) == 1:

            # 2017.07.13 ~ 07.15

            if date.find(':') > 0:

                if self.compareDate(strDate[0], currentDate) >= 0:

                    flag = True

                    startdate = strDate[0]

                    enddate = strDate[0]

            else:

                startdate = strDate[0]

                enddate = date[0:5] + date[len(date) - 5:]

                if self.compareDate(enddate, currentDate) >= 0:

                    flag = True

        return flag, startdate, enddate

    def parse(self, response):

        site = Selector(response)

        sels = site.xpath("//div[@id ='eventList']/div[@class ='list']")

        keyword = response.meta['keyword']

        it_list = []

        for sel in sels:

            dates = sel.xpath('.//div[@class="info time"]/text()')

            if len(dates) > 0:

                strdate = str(dates[0].extract())

                flag, startdate, enddate = self.date_isValid(strdate)

                if flag:

                    title = str(sel.xpath('.//div[2]/h2/a/text()')[0].extract())

                    if title.find(keyword) > -1:

                        url = 'http://www.huodongshu.com' + str(sel.xpath('.//div[1]/a/@href')[0].extract())

                        it = SplashMeetingItem()

                        it['title'] = title

                        it['url'] = url

                        it['date'] = strdate

                        it['startdate'] = startdate

                        it['enddate'] = enddate

                        it['keyword'] = keyword

                        areas = sel.xpath('.//div[@class="info site"]/text()')

                        if len(areas) > 0:

                            it['area']=areas[0].extract()

                        sources = sel.xpath('.//div[@class="info title"]/a/text()')

                        if len(sources)>0:

                            it['source'] = sources[0].extract()

                        it_list.append(it)

        return it_list
scrapy-splash抓取动态数据例子十一的更多相关文章
- scrapy-splash抓取动态数据例子一
目前,为了加速页面的加载速度,页面的很多部分都是用JS生成的,而对于用scrapy爬虫来说就是一个很大的问题,因为scrapy没有JS engine,所以爬取的都是静态页面,对于JS生成的动态页面都无 ...
- scrapy-splash抓取动态数据例子八
一.介绍 本例子用scrapy-splash抓取界面网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子七
一.介绍 本例子用scrapy-splash抓取36氪网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子六
一.介绍 本例子用scrapy-splash抓取中广互联网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子五
一.介绍 本例子用scrapy-splash抓取智能电视网网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站 ...
- scrapy-splash抓取动态数据例子四
一.介绍 本例子用scrapy-splash抓取微众圈网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子三
一.介绍 本例子用scrapy-splash抓取今日头条网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子二
一.介绍 本例子用scrapy-splash抓取一点资讯网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子十六
一.介绍 本例子用scrapy-splash爬取梅花网(http://www.meihua.info/a/list/today)的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电 ...
随机推荐
- python基础===修改idle的输入风格
http://blog.csdn.net/aq_cainiao_aq/article/details/51701861
- CHM文件出现的常见错误及解决办法
一.chm文件内容乱码: 解决方式:将IE浏览器的编码换成自动选择,或者选择UTF-8和GBK看那个能使用.因为chm文件默认的是IE浏览器的内核. 二.easy chm软件编译文件时左侧索引乱码,源 ...
- mysql常用函数示例
CREATE TABLE `orders` ( `OrderId` INT(10) NOT NULL AUTO_INCREMENT COMMENT '编号', `ProductName` VARCHA ...
- CSS3颜色渐变模式总结
1.线性渐变:linear-gradient 语法:= linear-gradient([ [ | to [, ]+) = [left | right] || [top | bottom] = [ | ...
- python中的闭包与装饰器
#原创,转载请留言联系 装饰器的本质就是闭包,所以想知道装饰器是什么,首先要理解一下什么是闭包. 闭包 1. 外部函数返回内部函数的引用.2. 内部函数使用外部函数的变量或者参数. def outer ...
- tcpdump 学习(3):MySQL Query
在MySQL线上环境我们一般只打开了binary log,slow log,有时我们需要查看general log呢?因为该log记录所有的请求,打开该日志肯定给磁盘造成很大压力,IO能力有所下降,所 ...
- flask学习:如何从config里载入配置
代码如下: 1.main.py from flask import Flask from config import DevConfig app=Flask(__name__) app.config. ...
- SecureCRT的安装、介绍、简单操作
网上看到一篇名为<SecureCRT的使用方法和技巧(详细使用教程)>的secureCRT教程,可能软件版本与我不一样我安装的是8.1. 原文来源:http://www.jb51.net/ ...
- aoj 0033 Ball【dfs/枚举】
有一个形似央视大楼(Orz)的筒,从A口可以放球,放进去的球可通过挡板DE使其掉进B裤管或C裤管里,现有带1-10标号的球按给定顺序从A口放入,问是否有一种控制挡板的策略可以使B裤管和C裤管中的球从下 ...
- 使用Nginx+uWSGI部署Django项目
1.linux安装python3环境 参考链接:https://www.cnblogs.com/zzqit/p/10087680.html 2.安装uwsgi pip3 install uwsgi l ...