
BatchNorm caffe源码
1、计算的均值和方差是channel的
2、test/predict 或者use_global_stats的时候,直接使用moving average
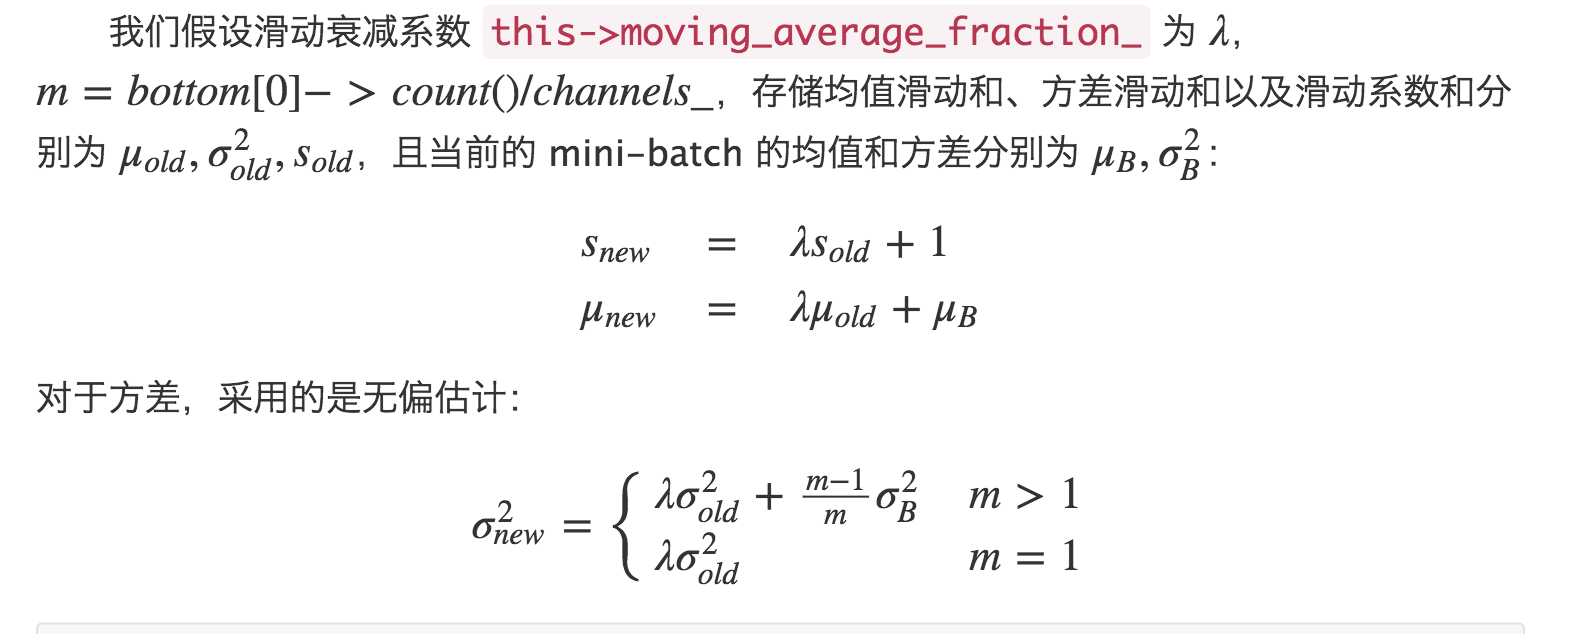
use_global_stats 表示是否使用全部数据的统计值(该数据实在train 阶段通过moving average 方法计算得到)训练阶段设置为 fasle, 表示通过当前的minibatch 数据计算得到, test/predict 阶段使用 通过全部数据计算得到的统计值
那什么是 moving average 呢:
反向传播:
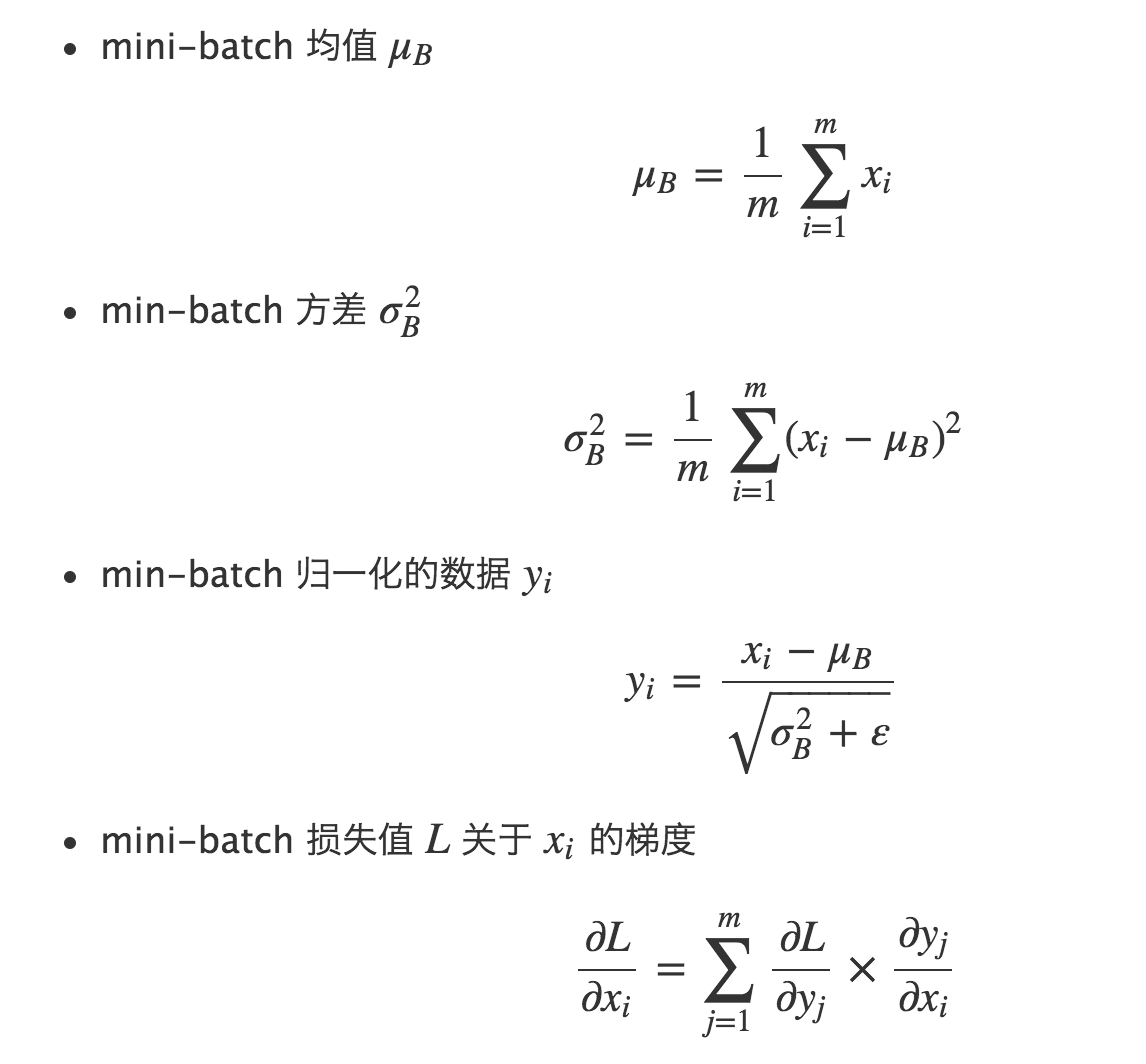
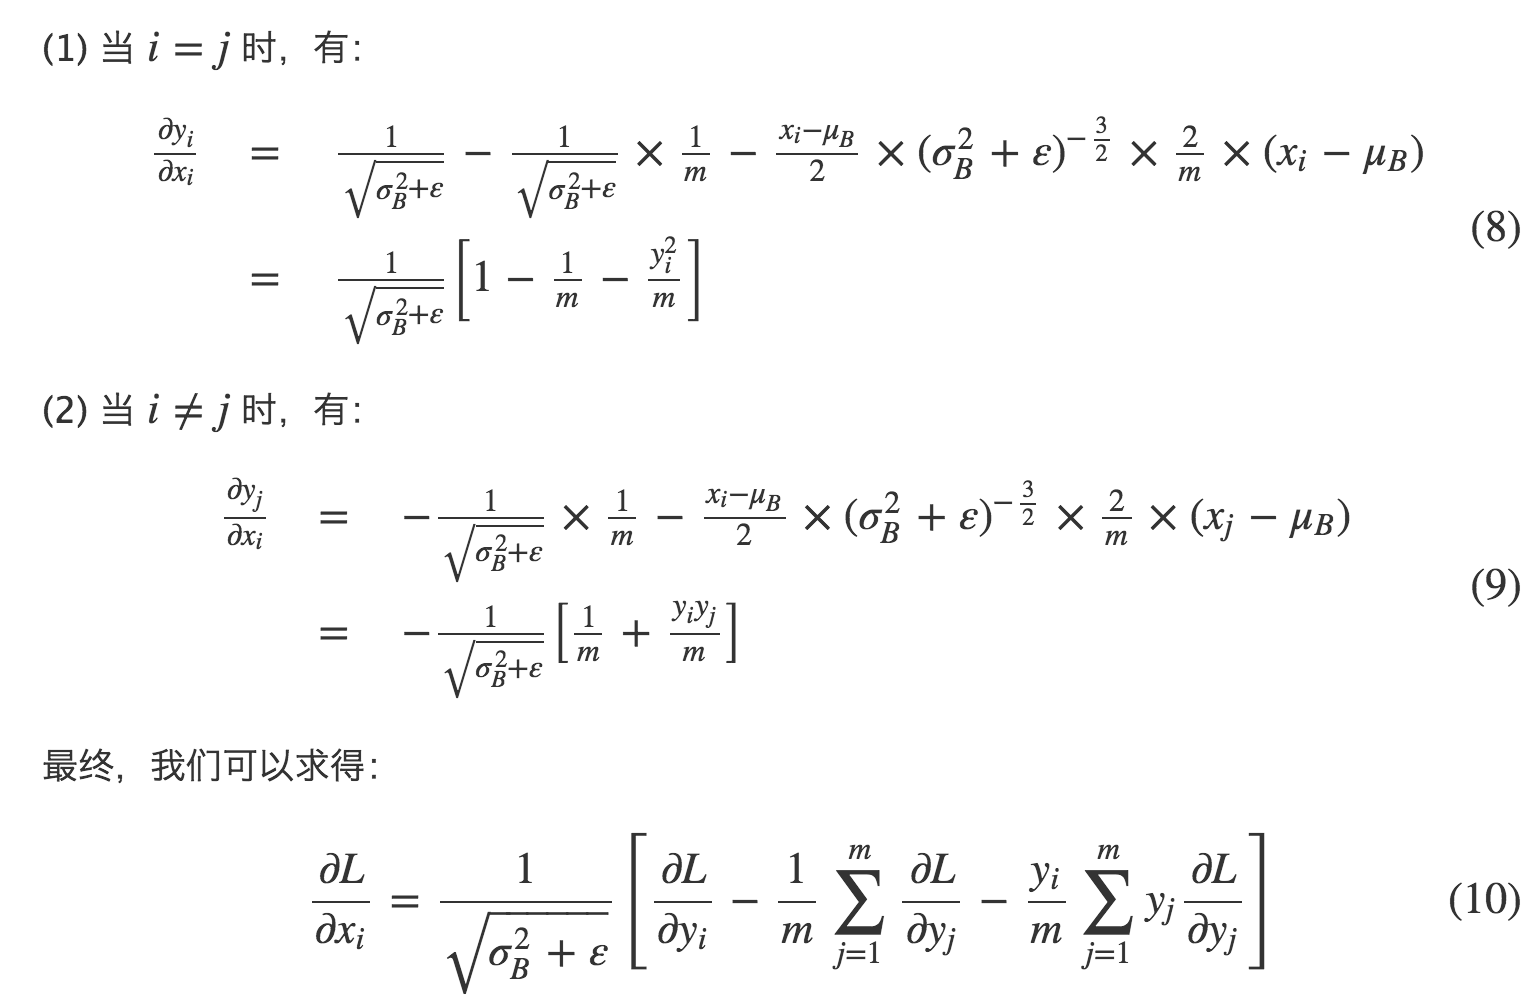
源码:(注:caffe_cpu_scale 是y=alpha*x ,这里面求滑动均值时候,alpha是滑动系数和的倒数,x是滑动均值和
template <typename Dtype>

void BatchNormLayer<Dtype>::Forward_cpu(const vector<Blob<Dtype>*>& bottom,

    const vector<Blob<Dtype>*>& top) {

  const Dtype* bottom_data = bottom[0]->cpu_data();

  Dtype* top_data = top[0]->mutable_cpu_data();

  int num = bottom[0]->shape(0);

  int spatial_dim = bottom[0]->count()/(bottom[0]->shape(0)*channels_);

  if (bottom[0] != top[0]) {

    caffe_copy(bottom[0]->count(), bottom_data, top_data);

  }

  if (use_global_stats_) {

    // use the stored mean/variance estimates.

    const Dtype scale_factor = this->blobs_[2]->cpu_data()[0] == 0 ?

        0 : 1 / this->blobs_[2]->cpu_data()[0];

    caffe_cpu_scale(variance_.count(), scale_factor,

        this->blobs_[0]->cpu_data(), mean_.mutable_cpu_data());

    caffe_cpu_scale(variance_.count(), scale_factor,

        this->blobs_[1]->cpu_data(), variance_.mutable_cpu_data());

  } else {

    // compute mean

    caffe_cpu_gemv<Dtype>(CblasNoTrans, channels_ * num, spatial_dim,

        1. / (num * spatial_dim), bottom_data,

        spatial_sum_multiplier_.cpu_data(), 0.,

        num_by_chans_.mutable_cpu_data());

    caffe_cpu_gemv<Dtype>(CblasTrans, num, channels_, 1.,

        num_by_chans_.cpu_data(), batch_sum_multiplier_.cpu_data(), 0.,

        mean_.mutable_cpu_data());

  }

  // subtract mean

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, num, channels_, 1, 1,

      batch_sum_multiplier_.cpu_data(), mean_.cpu_data(), 0.,

      num_by_chans_.mutable_cpu_data());

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, channels_ * num,

      spatial_dim, 1, -1, num_by_chans_.cpu_data(),

      spatial_sum_multiplier_.cpu_data(), 1., top_data);

  if (!use_global_stats_) {

    // compute variance using var(X) = E((X-EX)^2)

    caffe_powx(top[0]->count(), top_data, Dtype(2),

        temp_.mutable_cpu_data());  // (X-EX)^2

    caffe_cpu_gemv<Dtype>(CblasNoTrans, channels_ * num, spatial_dim,

        1. / (num * spatial_dim), temp_.cpu_data(),

        spatial_sum_multiplier_.cpu_data(), 0.,

        num_by_chans_.mutable_cpu_data());

    caffe_cpu_gemv<Dtype>(CblasTrans, num, channels_, 1.,

        num_by_chans_.cpu_data(), batch_sum_multiplier_.cpu_data(), 0.,

        variance_.mutable_cpu_data());  // E((X_EX)^2)

    // compute and save moving average

    this->blobs_[2]->mutable_cpu_data()[0] *= moving_average_fraction_;

    this->blobs_[2]->mutable_cpu_data()[0] += 1;

    caffe_cpu_axpby(mean_.count(), Dtype(1), mean_.cpu_data(),

        moving_average_fraction_, this->blobs_[0]->mutable_cpu_data());

    int m = bottom[0]->count()/channels_;

    Dtype bias_correction_factor = m > 1 ? Dtype(m)/(m-1) : 1;

    caffe_cpu_axpby(variance_.count(), bias_correction_factor,

        variance_.cpu_data(), moving_average_fraction_,

        this->blobs_[1]->mutable_cpu_data());

  }

  // normalize variance

  caffe_add_scalar(variance_.count(), eps_, variance_.mutable_cpu_data());

  caffe_powx(variance_.count(), variance_.cpu_data(), Dtype(0.5),

             variance_.mutable_cpu_data());

  // replicate variance to input size

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, num, channels_, 1, 1,

      batch_sum_multiplier_.cpu_data(), variance_.cpu_data(), 0.,

      num_by_chans_.mutable_cpu_data());

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, channels_ * num,

      spatial_dim, 1, 1., num_by_chans_.cpu_data(),

      spatial_sum_multiplier_.cpu_data(), 0., temp_.mutable_cpu_data());

  caffe_div(temp_.count(), top_data, temp_.cpu_data(), top_data);

  // TODO(cdoersch): The caching is only needed because later in-place layers

  //                 might clobber the data.  Can we skip this if they won't?

  caffe_copy(x_norm_.count(), top_data,

      x_norm_.mutable_cpu_data());

}

template <typename Dtype>

void BatchNormLayer<Dtype>::Backward_cpu(const vector<Blob<Dtype>*>& top,

    const vector<bool>& propagate_down,

    const vector<Blob<Dtype>*>& bottom) {

  const Dtype* top_diff;

  if (bottom[0] != top[0]) {

    top_diff = top[0]->cpu_diff();

  } else {

    caffe_copy(x_norm_.count(), top[0]->cpu_diff(), x_norm_.mutable_cpu_diff());

    top_diff = x_norm_.cpu_diff();

  }

  Dtype* bottom_diff = bottom[0]->mutable_cpu_diff();

  if (use_global_stats_) {

    caffe_div(temp_.count(), top_diff, temp_.cpu_data(), bottom_diff);

    return;

  }

  const Dtype* top_data = x_norm_.cpu_data();

  int num = bottom[0]->shape()[0];

  int spatial_dim = bottom[0]->count()/(bottom[0]->shape(0)*channels_);

  // if Y = (X-mean(X))/(sqrt(var(X)+eps)), then

  //

  // dE(Y)/dX =

  //   (dE/dY - mean(dE/dY) - mean(dE/dY \cdot Y) \cdot Y)

  //     ./ sqrt(var(X) + eps)

  //

  // where \cdot and ./ are hadamard product and elementwise division,

  // respectively, dE/dY is the top diff, and mean/var/sum are all computed

  // along all dimensions except the channels dimension.  In the above

  // equation, the operations allow for expansion (i.e. broadcast) along all

  // dimensions except the channels dimension where required.

  // sum(dE/dY \cdot Y)

  caffe_mul(temp_.count(), top_data, top_diff, bottom_diff);

  caffe_cpu_gemv<Dtype>(CblasNoTrans, channels_ * num, spatial_dim, 1.,

      bottom_diff, spatial_sum_multiplier_.cpu_data(), 0.,

      num_by_chans_.mutable_cpu_data());

  caffe_cpu_gemv<Dtype>(CblasTrans, num, channels_, 1.,

      num_by_chans_.cpu_data(), batch_sum_multiplier_.cpu_data(), 0.,

      mean_.mutable_cpu_data());

  // reshape (broadcast) the above

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, num, channels_, 1, 1,

      batch_sum_multiplier_.cpu_data(), mean_.cpu_data(), 0.,

      num_by_chans_.mutable_cpu_data());

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, channels_ * num,

      spatial_dim, 1, 1., num_by_chans_.cpu_data(),

      spatial_sum_multiplier_.cpu_data(), 0., bottom_diff);

  // sum(dE/dY \cdot Y) \cdot Y

  caffe_mul(temp_.count(), top_data, bottom_diff, bottom_diff);

  // sum(dE/dY)-sum(dE/dY \cdot Y) \cdot Y

  caffe_cpu_gemv<Dtype>(CblasNoTrans, channels_ * num, spatial_dim, 1.,

      top_diff, spatial_sum_multiplier_.cpu_data(), 0.,

      num_by_chans_.mutable_cpu_data());

  caffe_cpu_gemv<Dtype>(CblasTrans, num, channels_, 1.,

      num_by_chans_.cpu_data(), batch_sum_multiplier_.cpu_data(), 0.,

      mean_.mutable_cpu_data());

  // reshape (broadcast) the above to make

  // sum(dE/dY)-sum(dE/dY \cdot Y) \cdot Y

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, num, channels_, 1, 1,

      batch_sum_multiplier_.cpu_data(), mean_.cpu_data(), 0.,

      num_by_chans_.mutable_cpu_data());

  caffe_cpu_gemm<Dtype>(CblasNoTrans, CblasNoTrans, num * channels_,

      spatial_dim, 1, 1., num_by_chans_.cpu_data(),

      spatial_sum_multiplier_.cpu_data(), 1., bottom_diff);

  // dE/dY - mean(dE/dY)-mean(dE/dY \cdot Y) \cdot Y

  caffe_cpu_axpby(temp_.count(), Dtype(1), top_diff,

      Dtype(-1. / (num * spatial_dim)), bottom_diff);

  // note: temp_ still contains sqrt(var(X)+eps), computed during the forward

  // pass.

  caffe_div(temp_.count(), bottom_diff, temp_.cpu_data(), bottom_diff);

}

#ifdef CPU_ONLY

STUB_GPU(BatchNormLayer);

#endif

INSTANTIATE_CLASS(BatchNormLayer);

REGISTER_LAYER_CLASS(BatchNorm);

}  // namespace caffe
BatchNorm caffe源码的更多相关文章
- caffe源码学习之Proto数据格式【1】
前言: 由于业务需要,接触caffe已经有接近半年,一直忙着阅读各种论文,重现大大小小的模型. 期间也总结过一些caffe源码学习笔记,断断续续,这次打算系统的记录一下caffe源码学习笔记,巩固一下 ...
- Caffe源码理解2:SyncedMemory CPU和GPU间的数据同步
目录 写在前面 成员变量的含义及作用 构造与析构 内存同步管理 参考 博客:blog.shinelee.me | 博客园 | CSDN 写在前面 在Caffe源码理解1中介绍了Blob类,其中的数据成 ...
- caffe源码阅读
参考网址:https://www.cnblogs.com/louyihang-loves-baiyan/p/5149628.html 1.caffe代码层次熟悉blob,layer,net,solve ...
- Caffe源码中syncedmem文件分析
Caffe源码(caffe version:09868ac , date: 2015.08.15)中有一些重要文件,这里介绍下syncedmem文件. 1. include文件: (1).& ...
- Caffe源码中math_functions文件分析
Caffe源码(caffe version:09868ac , date: 2015.08.15)中有一些重要文件,这里介绍下math_functions文件. 1. include文件: ...
- Caffe源码中caffe.proto文件分析
Caffe源码(caffe version:09868ac , date: 2015.08.15)中有一些重要文件,这里介绍下caffe.proto文件. 在src/caffe/proto目录下有一个 ...
- Caffe源码阅读(1) 全连接层
Caffe源码阅读(1) 全连接层 发表于 2014-09-15 | 今天看全连接层的实现.主要看的是https://github.com/BVLC/caffe/blob/master/src ...
- vscode下调试caffe源码
caffe目录: ├── build -> .build_release // make生成目录,生成各种可执行bin文件,直接调用入口: ├── cmake ├── CMakeLists.tx ...
- Caffe源码中common文件分析
Caffe源码(caffe version:09868ac , date: 2015.08.15)中的一些重要头文件如caffe.hpp.blob.hpp等或者外部调用Caffe库使用时,一般都会in ...
随机推荐
- Counting
Description 数学老师走啦,英语老师来上课啦 他的性格与众不同,又因为大家都是理科班的学生 他希望大家在数字母的过程中领悟英语的快乐 他用m种字母进行排列组合, 得到了所 ...
- Ansible基础概述
一.Ansible简介 Ansible基于Python语言实现,由paramiko和PyYAML两个关键模块构建.Ansible的编排引擎可以出色地完成配置管理,流程控制,资源部署等多方面工作.Ans ...
- 20165218 《网络对抗技术》Exp3 免杀原理与实践
Exp3 免杀原理与实践 任务一:正确使用msf编码器,msfvenom生成如jar之类的其他文件,veil-evasion,自己利用shellcode编程等免杀工具或技巧 使用VirusTotal或 ...
- Go interface{}、类型断言
在 golang 中 interface{} 可用于向函数传递任意类型的变量, 但在函数内部使用的话, 该变量的类型就是 interface{}, 也称为空接口类型 比如我们定义一个函数, 输出字符串 ...
- 2017 3 11 分治FFT
考试一道题的递推式为$$f[i]=\sum_{j=1}^{i} j^k \times (i-1)! \times \frac{f[i-j]}{(i-j)!}$$这显然是一个卷积的形式,但$f$需要由自 ...
- CentOS-5的yum源无法使用问题
CentOS-5的yum源无法使用问题 [root@37wan ~]# yum -y install gcc Loaded plugins: fastestmirror Determining fas ...
- libcurl代码示例
http://note.youdao.com/noteshare?id=e60a679d1731c870ff45e403de81a2c0
- 01 C++ 多线程入门实例
1.可复用的完整实例 #include <iostream> #include <thread> #include <mutex> using namespace ...
- [大数据]-Fscrawler导入文件(txt,html,pdf,worf...)到Elasticsearch5.3.1并配置同义词过滤
fscrawler是ES的一个文件导入插件,只需要简单的配置就可以实现将本地文件系统的文件导入到ES中进行检索,同时支持丰富的文件格式(txt.pdf,html,word...)等等.下面详细介绍下f ...
- JDBC编程扩展
数据库的分类:关系型数据库.非关系型数据库.这跟数据库的发展相关.关系型数据库:mysql.oracle.sqlserver非关系型数据库:redis.memcathe.mogodb.hadoop1. ...