
python 3 爬取某小说网站小说,注释详细
目标:每一个小说保存成一个txt文件
思路:获取每个小说地址(图一),进入后获取每章节地址(图二),然后进入获取该章节内容(图三)保存文件中。循环


效果图:
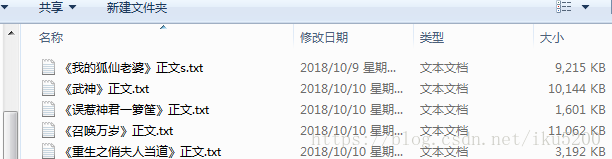
每一行都有注释,不多解释了
import requests

from bs4 import BeautifulSoup

import os

if __name__ == '__main__':

    # 要下载的网页

    url = 'https://www.biqubao.com/quanben/'

    # 网站根网址

    root_url = 'https://www.biqubao.com'

    # 保存本地路径

    path = 'F:\\python\\txt'

    # 解析网址

    req = requests.get(url)

    # 设置编码,浏览器查看网站编码:F12,控制开输入document.characterSet回车即可查看

    req.encoding = 'gbk'

    # 获取网页所有内容

    soup = BeautifulSoup(req.text, 'html.parser')

    # 查找网页中div的id为main的标签

    list_tag = soup.div(id="main")

    # 查看div内所有里标签

    li = list_tag[0](['li'])

    # 删除第一个没用的标签

    del li[0]

    # 循环遍历

    for i in li:

        # 获取到a标签间的内容---小说类型

        txt_type = i.a.string

        # 获取a标签的href地址值---小说网址

        short_url = (i(['a'])[1].get('href'))

        # 获取第三个span标签的值---作者

        author = i(['span'])[3].string

        # 获取网页设置网页编码

        req = requests.get(root_url + short_url)

        req.encoding = 'gbk'

        # 解析网页

        soup = BeautifulSoup(req.text, "html.parser")

        list_tag = soup.div(id="list")

        # 获取小说名

        name = list_tag[0].dl.dt.string

        print("类型:{}    短址:{}   作者:{}   小说名:{}".format(txt_type, short_url, author, name))

        # 创建同名文件夹

        # paths = path + '\\' + name

        if not os.path.exists(path):

            # 获取当前目录并组合新目录

            # os.path.join(path, name)

            os.mkdir(path)

        # 循环所有的dd标签

        for dd_tag in list_tag[0].dl.find_all('dd'):

            # 章节名

            zjName = dd_tag.string

            # 章节地址

            zjUrl = root_url + dd_tag.a.get('href')

            # 访问网址爬取章节内容

            req2 = requests.get(zjUrl)

            req2.encoding = 'gbk'

            zj_soup = BeautifulSoup(req2.text, "html.parser")

            content_tag = zj_soup.div.find(id="content")

            # 把空格内容替换成换行

            text = str(content_tag.text.replace('\xa0', '\n'))

            text.replace('\ufffd', '\n')

            # 写入文件操作'a'追加

            with open(path + "\\" + name + ".txt", 'a') as f:

                f.write('\n' + '\n' + zjName)

                f.write(text)

                print("{}------->写入完毕".format(zjName))
python 3 爬取某小说网站小说,注释详细的更多相关文章
- Python轻松爬取Rosimm写真网站全部图片
RosimmImage 爬取Rosimm写真网站图片 有图有真相 def main_start(url): """ 爬虫入口,主要爬取操作 ""&qu ...
- Python爬虫爬取美剧网站
一直有爱看美剧的习惯,一方面锻炼一下英语听力,一方面打发一下时间.之前是能在视频网站上面在线看的,可是自从广电总局的限制令之后,进口的美剧英剧等貌似就不在像以前一样同步更新了.但是,作为一个宅diao ...
- Python——Scrapy爬取链家网站所有房源信息
用scrapy爬取链家全国以上房源分类的信息: 路径: items.py # -*- coding: utf-8 -*- # Define here the models for your scrap ...
- python爬虫爬取ip记录网站信息并存入数据库
import requests import re import pymysql #10页 仔细观察路由 db = pymysql.connect("localhost",&quo ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- bs4爬取笔趣阁小说
参考链接:https://www.cnblogs.com/wt714/p/11963497.html 模块:requests,bs4,queue,sys,time 步骤:给出URL--> 访问U ...
- Python 爬取所有51VOA网站的Learn a words文本及mp3音频
Python 爬取所有51VOA网站的Learn a words文本及mp3音频 #!/usr/bin/env python # -*- coding: utf-8 -*- #Python 爬取所有5 ...
- Python开发爬虫之BeautifulSoup解析网页篇:爬取安居客网站上北京二手房数据
目标:爬取安居客网站上前10页北京二手房的数据,包括二手房源的名称.价格.几室几厅.大小.建造年份.联系人.地址.标签等. 网址为:https://beijing.anjuke.com/sale/ B ...
- python爬虫学习之使用BeautifulSoup库爬取开奖网站信息-模块化
实例需求:运用python语言爬取http://kaijiang.zhcw.com/zhcw/html/ssq/list_1.html这个开奖网站所有的信息,并且保存为txt文件和excel文件. 实 ...
随机推荐
- Git服务器Gogs简易安装-Windows环境
1.下载git for windows https://github.com/git-for-windows/git/releases/download/v2.15.0.windows.1/Git-2 ...
- linux下串口函数
tcgetattr(), tcsetattr(), tcdrain(),tcflush(), tcflow(), tcsendbreak(),cfmakeraw(), cfgetispeed(),cf ...
- utf8mb4的大小写敏感性测试及其修改方法
utf8mb4的大小写敏感性测试及其修改方法 utf8mb4_ unicode_ ci 与 utf8mb4_ general_ ci 如何选择字符除了需要存储,还需要排序或比较大小,涉及到与编码字符集 ...
- Andrew Ng机器学习公开课笔记 -- 线性回归和梯度下降
网易公开课,监督学习应用.梯度下降 notes,http://cs229.stanford.edu/notes/cs229-notes1.pdf 线性回归(Linear Regression) 先看个 ...
- [物理学与PDEs]第3章第2节 磁流体力学方程组 2.1 考虑到导电媒质 (等离子体) 的运动对 Maxwell 方程组的修正
1. Maxwell 方程组 $$\bee\label{3_2_1_Maxwell} \bea \Div{\bf D}&=\rho_f,\\ \rot{\bf E}&=-\cfrac ...
- metasploit 教程之基本参数和扫描
前言 首先我也不知道我目前的水平适不适合学习msf. 在了解一些msf之后,反正就是挺想学的.就写博记录一下.如有错误的地方,欢迎各位大佬指正. 感激不尽.! 我理解的msf msf全程metaspl ...
- iTOP-iMX6开发板-Android-can测试例程介绍
TOP-iMX6开发板的 Android 源码的 can 例程包含在 Android 源码中,在“ packages/apps/”目 录下,如下图所示,这个是应用界面的源码. 如下图所示,can ...
- JS获取当月第一天和最后一天
/** * 获取当前月的第一天 */function getCurrentMonthFirst(){ var date=new Date(); date.setDate(1); return date ...
- pythonのdjango连接MYSQL
在py3.*中利用django使用mysql时,会出现一些问题.由于django默认的是 MySQLdb,但MySQLdb目前不支持py3.*所以我们要改用pymysql,首先要安装pymysql,命 ...
- 20165221-week2课上测试补做
week2-课上测试补做 测试一: 参考附图代码,编写一个程序 "week0201学号.c",判断一下你的电脑是大端还是小端. 提交运行结果"学号XXXX的笔记本电脑是X ...