
Python爬虫,爬取腾讯漫画实战
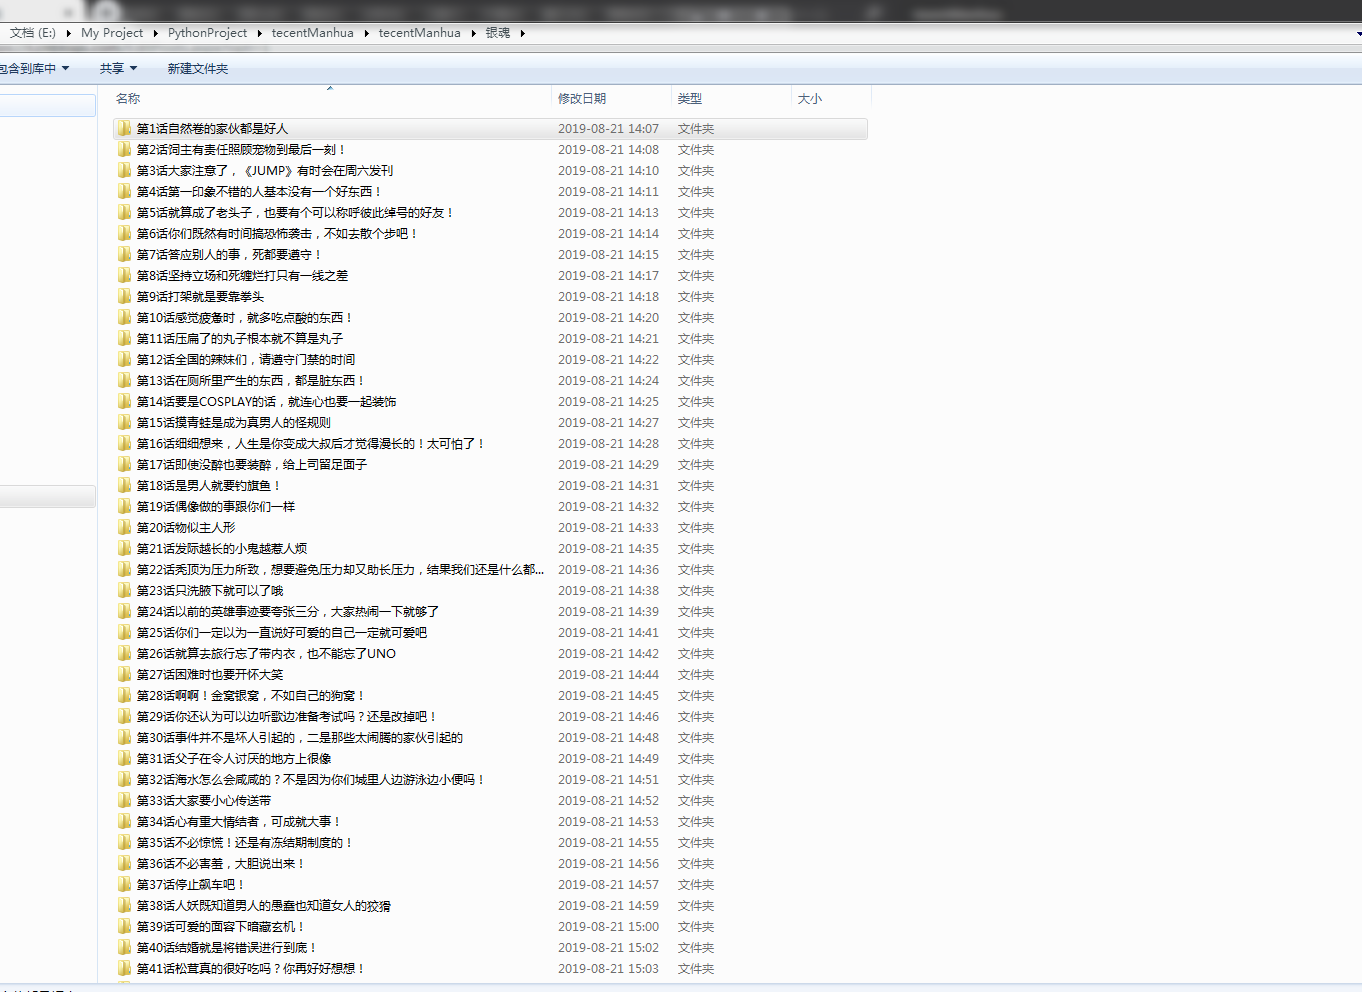
先上个爬取的结果图
最后的结果为每部漫画按章节保存

运行环境
IDE VS2019
Python3.7
Chrome、ChromeDriver
Chrome和ChromeDriver的版本需要相互对应
先上代码,代码非常简短,包含空行也才50行,多亏了python强大的库
import os

import time

import requests

from selenium import webdriver

from lxml import etree

def getChapterUrl(url):

    headers = {

            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_13_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36"

        }

    part_url = "http://ac.qq.com"

    res = requests.get(url, headers=headers)

    html=res.content.decode()

    el = etree.HTML(html)

    li_list = el.xpath('//*[@id="chapter"]/div[2]/ol[1]/li')

    for li in li_list:

            for p in li.xpath("./p"):

                for span in p.xpath("./span[@class='works-chapter-item']"):

                    item = {}

                    list_title = span.xpath("./a/@title")[0].replace(' ', '').split(':')

                    if list_title[1].startswith(('第', '序')):

                        getChapterFile(part_url + span.xpath("./a/@href")[0], list_title[0],list_title[1])

def getChapterFile(url,path1,path2):

    #path = os.path.join(path)

    #漫画名称目录

    path=os.path.join(path1)

    if not os.path.exists(path):

        os.mkdir(path)

    #章节目录

    path=path+'\\'+path2

    if not os.path.exists(path):

        os.mkdir(path)

    chrome=webdriver.Chrome()

    #"http://ac.qq.com/ComicView/index/id/505435/cid/2"

    chrome.get(url)

    time.sleep(4)

    imgs = chrome.find_elements_by_xpath("//div[@id='mainView']/ul[@id='comicContain']//img")

    for i in range(0, len(imgs)):

            js="document.getElementById('mainView').scrollTop="+str((i) * 1280)

            chrome.execute_script(js)

            time.sleep(3)

            print(imgs[i].get_attribute("src"))

            with open(path+'\\'+str(i)+'.png', 'wb') as f:

                f.write(requests.get(imgs[i].get_attribute("src")).content)

    chrome.close()

    print('下载完成')

if __name__ == '__main__':

    getChapterUrl('http://ac.qq.com/Comic/ComicInfo/id/505435')
简单解释
输入一个漫画的url即可爬取该漫画所有的章节,由于是模拟用户爬取的,所以速度方面有点慢,我试了下爬取银魂前70章,用了1个半小时,代码中的sleep可以适当简短点已加快爬取的速度
付费的漫画是没有办法爬取的
谈一下过程中遇到的坑
腾讯的漫画网站打开章节时没有把所有图片的url都加载出来,所以我在这里用的方式是使用selenium来模拟用户操作,每次打开页面以后使用js操作滚动条下拉
最后再贴下代码库,其实贴出的代码已经是所有的代码了
https://dev.azure.com/shenjuncaci/PythonTecentManhua
Python爬虫,爬取腾讯漫画实战的更多相关文章
- Python爬虫---爬取腾讯动漫全站漫画
目录 操作环境 网页分析 明确目标 提取漫画地址 提取漫画章节地址 提取漫画图片 编写代码 导入需要的模块 获取漫画地址 提取漫画的内容页 提取章节名 获取漫画源网页代码 下载漫画图片 下载结果 完整 ...
- python爬虫爬取腾讯招聘信息 (静态爬虫)
环境: windows7,python3.4 代码:(亲测可正常执行) import requests from bs4 import BeautifulSoup from math import c ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- python爬虫爬取内容中,-xa0,-u3000的含义
python爬虫爬取内容中,-xa0,-u3000的含义 - CSDN博客 https://blog.csdn.net/aiwuzhi12/article/details/54866310
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python爬虫—爬取英文名以及正则表达式的介绍
python爬虫—爬取英文名以及正则表达式的介绍 爬取英文名: 一. 爬虫模块详细设计 (1)整体思路 对于本次爬取英文名数据的爬虫实现,我的思路是先将A-Z所有英文名的连接爬取出来,保存在一个cs ...
随机推荐
- [Spring+SpringMVC+Mybatis]框架学习笔记(六):事务
第7讲 事务 7.1 事务的概念 事务是一系列作为一个逻辑单元来执行的操作集合. 它是数据库维护数据一致性的单位,它讲数据库从一个一致状态,转变为新的另外一个一致状态.说的简单一点就是:如果一组处理步 ...
- 用了三星Dex,我已经快一个月回家没开过电脑了
其实比较早就知道手机使用显示屏扩展的功能,但是以前的技术可能受性能影响体验还不太好.后来让我期待的是Linux On Dex这个项目知道了手机已经如此强大了,可惜只能是是特定机器,因此在618之际乘着 ...
- 能访问的谷歌 http://209.116.186.231/
能访问的谷歌 http://209.116.186.231/
- java面试题库(长期)
本文内容来自互联网各种面试实例,以及自己的面试经历,主要是中级开发的面试题 初中级java面试主要分为几个部分: 0.序 1.java基础 2. java多线程 3. jvm知识 4. spring等 ...
- 题解 P1864 【[NOI2009]二叉查找树】
#include<cstdio> #include<string> #include<cstring> #include<iostream> #incl ...
- python正则表达式与re模块-02
正则表达式 正则表达式与python的关系 # 正则表达式不是Python独有的,它是一门独立的技术,所有的编程语言都可以使用正则 # 但要在python中使用正则表达式,就必须依赖于python内置 ...
- compute节点上开启服务openstack-nova-compute.service时,无法启动的解决方法
本文前一部分为本人解决问题的过程,但最终没有解决:无奈在网上找方法时,看到有网友评论说:修改controller上的guest账号密码,再重启openstack-nova-compute. ...
- dubbo同步调用、异步调用和是否返回结果源码分析和实例
0. dubbo同步调用.异步调用和是否返回结果配置 (1)dubbo默认为同步调用,并且有返回结果. (2)dubbo异步调用配置,设置 async="true",异步调用可以提 ...
- 从零开始实现ASP.NET Core MVC的插件式开发(三) - 如何在运行时启用组件
标题:从零开始实现ASP.NET Core MVC的插件式开发(三) - 如何在运行时启用组件 作者:Lamond Lu 地址:https://www.cnblogs.com/lwqlun/p/112 ...
- NLP(十二)依存句法分析的可视化及图分析
依存句法分析的效果虽然没有像分词.NER的效果来的好,但也有其使用价值,在日常的工作中,我们免不了要和其打交道.笔者这几天一直在想如何分析依存句法分析的结果,一个重要的方面便是其可视化和它的图分析 ...