
爬虫小例1:ajax形式的网页数据的抓取
---恢复内容开始---
下面记录如何抓取ajax形式加载的网页数据:
目标:获取“https://movie.douban.com/typerank?type_name=%E5%89%A7%E6%83%85&type=11&interval_id=100:90&action=”下的网页数据
第一步:网页数据分析-----》特点:当列表条滚动到页面下方时数据自动加载,而页面的url并未发生变化
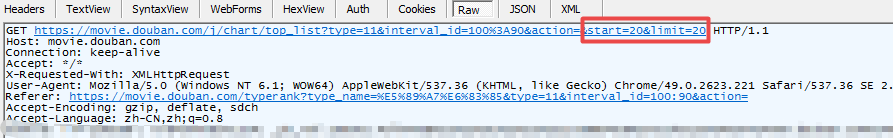
第二步:利用Fiddler抓包,如下图:
图一:请求数据
图二:form表单
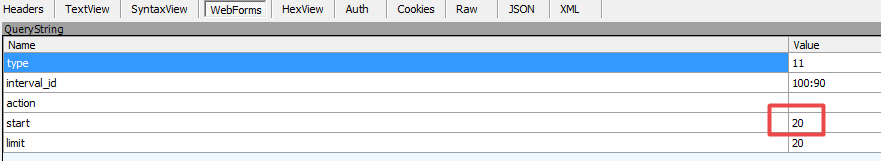
通过抓包获取到数据规律:图二from表单中start对应数据和图一中的url中start对应数据随着每次加载而递增,其他数据未发生变化。对应这种规律我们便可构造相应请求获取数据
需注意,数据形式为json
代码如下:
1).urllib形式
import urllib2

import urllib

#此处的url为上述抓包获取的url去掉start以及limit,start以及limit数据后边以form表单的形式传入

url = ' https://movie.douban.com/j/chart/top_list?type=11&interval_id=100%3A90&action='

#请求投信息,伪造成浏览器,方式被反爬虫策略拦截

headers = {"User-Agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0"}

#构建form表单

formdata = {

        "start":"",

        "limit":""

        }

#urlencode()urllib中的函数,作用:将key:value形式的键值对转换为"key=value"形式的字符串

data = urllib.urlencode(formdata)

#构建request实例对象

request = urllib2.Request(url,data=data,headers=headers)

#发送请求并返回响应信息

response = urllib2.urlopen(request)

#注意此处的数据形式并不是html文档,而是json数据

json = response.read()

print html
2).request库的get请求代码
#coding=utf-8

import requests

url = ' https://movie.douban.com/j/chart/top_list?type=11&interval_id=100%3A90&action='

headers = {"User-Agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0"}

data = {

    "start":"",

    "limit":"",

    }

response = requests.get(url,params = data,headers = headers)

print response.text
3).request库的post请求
#coding=utf-8

import requests

url = ' https://movie.douban.com/j/chart/top_list?type=11&interval_id=100%3A90&action='

formdata = {

    "start":"",

    "limit":""

    }

headers = {"User-Agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:60.0) Gecko/20100101 Firefox/60.0"}

response = requests.post(url,data=formdata,headers=headers)

print response.text
---恢复内容结束---
爬虫小例1:ajax形式的网页数据的抓取的更多相关文章
- 使用 Chrome 浏览器插件 Web Scraper 10分钟轻松实现网页数据的爬取
web scraper 下载:Web-Scraper_v0.2.0.10 使用 Chrome 浏览器插件 Web Scraper 可以轻松实现网页数据的爬取,不写代码,鼠标操作,点哪爬哪,还不用考虑爬 ...
- c# 正则表达式对网页进行内容抓取
原文 c# 正则表达式对网页进行内容抓取 搜索引擎中一个比较重要的环节就是从网页中抽取出有效内容.简单来说,就是吧HTML文本中的HTML标记去掉,留下我们用IE等浏览器打开HTML文档看到的部分(我 ...
- Python 网页投票信息抓取
最近学习python,为了巩固一下学过的知识,花了半天(主要还是因为自己正则表达式不熟)写了个小脚本来抓取一个网站上的投票信息,排名后进行输出. 抓取的网站网址是http://www.mudidi.n ...
- [Python爬虫] 之二十八:Selenium +phantomjs 利用 pyquery抓取网站排名信息
一.介绍 本例子用Selenium +phantomjs爬取中文网站总排名(http://top.chinaz.com/all/index.html,http://top.chinaz.com/han ...
- [Python爬虫] 之二十五:Selenium +phantomjs 利用 pyquery抓取今日头条网数据
一.介绍 本例子用Selenium +phantomjs爬取今日头条(http://www.toutiao.com/search/?keyword=电视)的资讯信息,输入给定关键字抓取资讯信息. 给定 ...
- 爬虫小探-Python3 urllib.request获取页面数据
使用Python3 urllib.request中的Requests()和urlopen()方法获取页面源码,并用re正则进行正则匹配查找需要的数据. #forex.py#coding:utf-8 ' ...
- 吴裕雄--天生自然PYTHON爬虫:使用BeautifulSoup解析中国旅游网页数据
import requests from bs4 import BeautifulSoup url = "http://www.cntour.cn/" strhtml = requ ...
- 吴裕雄--天生自然python爬虫:使用requests模块的get和post方式抓取中国旅游网站和有道翻译网站翻译内容数据
import requests url = 'http://www.cntour.cn/' strhtml = requests.get(url) print(strhtml.text) URL='h ...
- [Python爬虫] 之二十九:Selenium +phantomjs 利用 pyquery抓取节目信息信息
一.介绍 本例子用Selenium +phantomjs爬取节目(http://tv.cctv.com/epg/index.shtml?date=2018-03-25)的信息 二.网站信息 三.数据抓 ...
随机推荐
- maven 异常 提示 cannot be read or is not a valid ZIP file
Archive for required library: 'D:/repository/Maven/org/springframework/spring-aop/4.3.6.RELEASE/spri ...
- python 并发编程 多进程 JoinableQueue
JoinableQueue和Queue 使用一样 这就像是一个Queue对象,但队列允许项目的使用者通知生成者项目已经被成功处理.通知进程是使用共享的信号和条件变量来实现的. JoinableQueu ...
- [转帖]深入理解 MySQL—锁、事务与并发控制
深入理解 MySQL—锁.事务与并发控制 http://www.itpub.net/2019/04/28/1723/ 跟oracle也类似 其实所有的数据库都有相同的机制.. 学习了机制才能够更好的工 ...
- Tensorflow模型保存与加载
在使用Tensorflow时,我们经常要将以训练好的模型保存到本地或者使用别人已训练好的模型,因此,作此笔记记录下来. TensorFlow通过tf.train.Saver类实现神经网络模型的保存和提 ...
- virtualenvwrapper安装和使用
virtualenvwrapper安装和使用步骤: 1.安装: *nix上安装的命令: pip install virtualenvwrapper windows上安装的命令: pip install ...
- [LeetCode] 137. 只出现一次的数字 II
题目链接 : https://leetcode-cn.com/problems/single-number-ii/ 题目描述: 给定一个非空整数数组,除了某个元素只出现一次以外,其余每个元素均出现了三 ...
- HNUSTOJ-1437 无题
1437: 无题 时间限制: 1 Sec 内存限制: 128 MB提交: 268 解决: 45[提交][状态][讨论版] 题目描述 tc在玩一个很无聊的游戏:每一次电脑都会给一个长度不超过10^5 ...
- Fusioncharts图表常用参数设置
1.1 <chart>参数设置: 图表和轴的标题* caption=”String” : 图表上方的标题* subCaption=”String” : 图表上方的副标题* xAxisNam ...
- Vue的渐进式理解(笔记)
在我看来,渐进式代表的含义是:主张最少. 每个框架都不可避免会有自己的一些特点,从而会对使用者有一定的要求,这些要求就是主张,主张有强有弱,它的强势程度会影响在业务开发中的使用方式. 比如说,Angu ...
- js中的object类型
特点: 每个Object类型的实例共有的属性和方法: constructor: 保存着用于创建当前对象的函数. hasOwnProperty:用于检测给定的属性在当前对象的实例中是否存在. isPro ...