
Scrapy项目 - 实现百度贴吧帖子主题及图片爬取的爬虫设计
要求编写的程序可获取任一贴吧页面中的帖子链接,并爬取贴子中用户发表的图片,在此过程中使用user agent 伪装和轮换,解决爬虫ip被目标网站封禁的问题。熟悉掌握基本的网页和url分析,同时能灵活使用Xmind工具对Python爬虫程序(网络爬虫)流程图进行分析。
一、项目分析
1. 网页分析
贴吧页面简洁,所有内容让人一目了然,使用起来也较其他社区论坛简单,注册简单甚至可以不注册,发 帖简单。但栏目创建得参差不齐,内容千奇百怪。
2. url分析
分析贴吧中,贴子链接的拼接构成形态,在程序中将贴子链接重构。
如本例实验,经过多次进入不同贴吧可知,贴吧的链接组成为:fullurl=url+key。其中fullurl表示贴吧总链接
url为贴吧链接的共同体:https://tieba.baidu.com/f?
key为经过urlencode编码的贴吧中文名
使用xpath_helper_2_0_2.crx浏览器插件,可将贴子的链接入口归结为:
“//li/div[@class="t_con cleafix"]/div/div/div/a/@href”,贴子中用户发表的图片链接表达式为:“//img ··[@class="BDE_Image"]/@src”
二、项目工具
Python 3.7.1 、 JetBrains PyCharm 2018.3.2
三、项目过程
(一)使用Xmind工具对Python爬虫程序(网络爬虫)流程图进行分析,绘制如图4-1所示的程序逻辑框架图
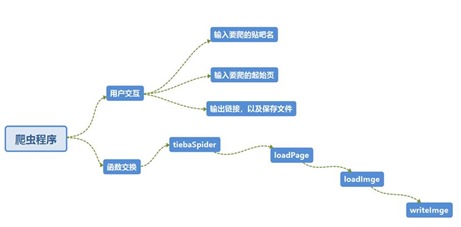
图4-1 程序逻辑框架图
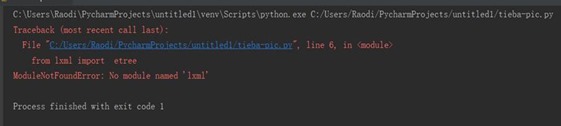
(二)爬虫程序调试过程BUG描述(截图)
(三)爬虫运行结果
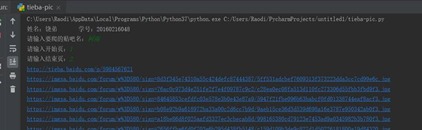
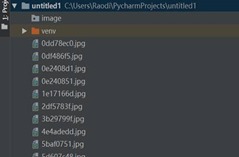
(四)项目心得
关于本例实验心得可总结如下:
1、 当程序运行结果提示错误为:ModuleNotFoundError: No module named 'lxml',最好的解决方法是:首先排除是否lxml是否安装,再检查lxml是否被导入。本实验中,是由于工程项目为能成功导入lxml,解决方法如图5-1所示,在“Project Interperter”中选择python安装目录,即可。
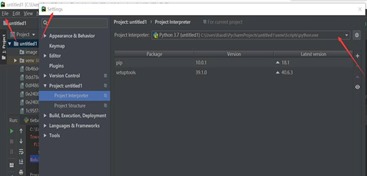
图5-1 错误解决过程
2、 有的时候要模拟浏览器 ,不然做过反爬虫的网站会知道你是robot
例如针对浏览器的限制我们可以设置User-Agent头部,针对防盗链限制,我们可以设置Referer头部 有的网站用了Cookie来限制,主要是涉及到登录和限流,这时候没有什么通用的方法,只能看能否做自动登录或者分析Cookie的问题了。
3、 我们第一步可以在主界面的html代码中抽取出这些套图起始的链接地址,这里显然需要用到正则来提取这些不同地址。那么,有了每个套图的起始地址之后,我们进入到子页面,刷新网页,观察它的加载流程。
四、项目源码
tieba-pic.py
from urllib import  request,parse

import ssl

import random

import time

from lxml import  etree

ua_list=[

    'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/71.0.3578.98 Safari/537.36',

    'Mozilla/4.0 (compatible; MSIE 8.0; Windows NT 6.1; WOW64; Trident/4.0; SLCC2; .NET CLR 2.0.50727; .NET CLR 3.5.30729; .NET CLR 3.0.30729; Media Center PC 6.0; .NET4.0C; .NET4.0E)',

    'Mozilla/5.0 (Windows NT 6.1; WOW64; rv:45.0) Gecko/20100101 Firefox/45.0'

]

def loadPage(url):

    userAgent=random.choice(ua_list)

    headers={"User-Agent":userAgent}

    req =request.Request(url,headers=headers)

    context=ssl._create_unverified_context()

    response=request.urlopen(req,context=context)

    html=response.read()

    content=etree.HTML(html)

    link_list=content.xpath('//li/div[@class="t_con cleafix"]/div/div/div/a/@href')

    for link in link_list:

        fullurl='http://tieba.baidu.com'+link

        print(fullurl)

        loadImge(fullurl)

def loadImge(url):

    req = request.Request(url)

    context = ssl._create_unverified_context()

    response = request.urlopen(req, context=context)

    html = response.read()

    content = etree.HTML(html)

    link_list = content.xpath('//img[@class="BDE_Image"]/@src')

    for link in link_list:

        print(link)

        writeImge(link)

def writeImge(url):

    req = request.Request(url)

    context = ssl._create_unverified_context()

    response = request.urlopen(req, context=context)

    image = response.read()

    filename=url[-12:]

    f=open(filename,'wb')

    f.write(image)

    f.close()

def tiebaSpider(url,beginPage,endPage):

    for page in range(beginPage,endPage+100):

        pn=(page-1)*50

        fullurl=url+"&pn="+str(pn)

        loadPage(fullurl)

if __name__=="__main__":

    print("测试成功!")

    kw=input("请输入要爬的贴吧名:")

    beginPage=int(input("请输入开始页:"))

    endPage = int(input("请输入结束页:"))

    url="http://tieba.baidu.com/f?"

    key=parse.urlencode({"kw":kw})

    fullurl=url+key

    tiebaSpider(fullurl,beginPage,endPage)
Scrapy项目 - 实现百度贴吧帖子主题及图片爬取的爬虫设计的更多相关文章
- Scrapy项目 - 源码工程 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
一.项目目录结构 spiders文件夹内包含doubanSpider.py文件,对于项目的构建以及结构逻辑,详见环境搭建篇. 二.项目源码 1.doubanSpider.py # -*- coding ...
- Scrapy项目 - 数据简析 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
一.数据分析截图(weka数据分析截图 ) 本例实验,使用Weka 3.7对豆瓣电影网页上所罗列的上映电影信息,如:标题.主要信息(年份.国家.类型)和评分等的信息进行数据分析,Weka 3.7数据分 ...
- Scrapy项目 - 数据简析 - 实现斗鱼直播网站信息爬取的爬虫设计
一.数据分析截图(weka数据分析截图 2-3个图,作业文字描述) 本次将所爬取的数据信息,如:房间数,直播类别和人气,导入Weka 3.7工具进行数据分析.有关本次的数据分析详情详见下图所示: ...
- Scrapy项目 - 实现腾讯网站社会招聘信息爬取的爬虫设计
通过使Scrapy框架,进行数据挖掘和对web站点页面提取结构化数据,掌握如何使用Twisted异步网络框架来处理网络通讯的问题,可以加快我们的下载速度,也可深入接触各种中间件接口,灵活的完成各种需求 ...
- Scrapy项目 - 实现豆瓣 Top250 电影信息爬取的爬虫设计
通过使Scrapy框架,掌握如何使用Twisted异步网络框架来处理网络通讯的问题,进行数据挖掘和对web站点页面提取结构化数据,可以加快我们的下载速度,也可深入接触各种中间件接口,灵活的完成各种需求 ...
- Scrapy项目 - 实现斗鱼直播网站信息爬取的爬虫设计
要求编写的程序可爬取斗鱼直播网站上的直播信息,如:房间数,直播类别和人气等.熟悉掌握基本的网页和url分析,同时能灵活使用Xmind工具对Python爬虫程序(网络爬虫)流程图进行分析. 一.项目 ...
- Scrapy项目 - 数据简析 - 实现腾讯网站社会招聘信息爬取的爬虫设计
一.数据分析截图 本例实验,使用Weka 3.7对腾讯招聘官网中网页上所罗列的招聘信息,如:其中的职位名称.链接.职位类别.人数.地点和发布时间等信息进行数据分析,详见如下图: 图1-1 Weka ...
- Scrapy项目 - 项目源码 - 实现腾讯网站社会招聘信息爬取的爬虫设计
1.tencentSpider.py # -*- coding: utf-8 -*- import scrapy from Tencent.items import TencentItem #创建爬虫 ...
- Python爬虫实例(一)爬取百度贴吧帖子中的图片
程序功能说明:爬取百度贴吧帖子中的图片,用户输入贴吧名称和要爬取的起始和终止页数即可进行爬取. 思路分析: 一.指定贴吧url的获取 例如我们进入秦时明月吧,提取并分析其有效url如下 http:// ...
随机推荐
- Codeforces 936B
题意略. 思路: 图论里掺杂了一些动态规划. 有几个注意点: 1.dp时状态的设计:因为我们要寻求的是出度为0并且可以从起点走奇数步抵达的点,由于同一个点可以通过多种方式到达. 并且我们在获得奇数步点 ...
- MSIL实用指南-数学运算
C#支持的数学运算是加.减.乘.除.取模,它们对应的指令是Add.Sub.Mul.Div.Rem. 这五个运算都需要两个参数,它们的通用步骤1.生成加载左边变量2.生成加载右边变量3.生成运算指令 实 ...
- TextCNN 代码详解(附测试数据集以及GitHub 地址)
前言:本篇是TextCNN系列的第三篇,分享TextCNN的优化经验 前两篇可见: 文本分类算法TextCNN原理详解(一) 一.textCNN 整体框架 1. 模型架构 图一:textCNN 模型结 ...
- Delphi - cxGrid设定合并单元格
在cxGrid中选中需要合并的字段,单击F11调出属性控制面板,展开Options,设置CellMerging的Value为True.
- 【Edu49 1027D】 Mouse Hunt DFS 环
1027D. Mouse Hunt:http://codeforces.com/contest/1027/problem/D 题意: 有n个房间,每个房间放置捕鼠器的费用是不同的,已知老鼠在一个房间x ...
- hdu 4614 Vases and Flowers(线段树)
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=4614 题意: 给你N个花瓶,编号是0 到 N - 1 ,初始状态花瓶是空的,每个花瓶最多插一朵花. ...
- Codeforces Round #409 C. Voltage Keepsake(二分+思维)
题目链接:http://codeforces.com/contest/801/problem/C 题意:给出一个充电器每秒钟充p个点,还有n个电器要同时使用a[i]表示第i个电器每秒钟用多少点,b[i ...
- codeforces 919C Seat Arrangements 思维模拟
C. Seat Arrangements time limit per test 1 second memory limit per test 256 megabytes input standard ...
- 面向对象程序设计(Java) 第1周学习指导及要求
面向对象程序设计(Java)第1周学习指导及要求 (2019.8.30-2019.9.2) 学习目标 了解课程上课方式及老师教学要求,掌握课程学习必要的软件工具: 理解JVM.JRE与JDK等概念 ...
- 【LeetCode】79-单词搜索
题目描述 给定一个二维网格和一个单词,找出该单词是否存在于网格中. 单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中 "相邻" 单元格是那些水平相邻或垂直相邻的单元格.同一 ...