
Spark DAGSheduler生成Stage过程分析实验
RDD.Action触发SparkContext.run,这里举最简单的例子rdd.count()
  /**

   * Return the number of elements in the RDD.

   */

  def count(): Long = sc.runJob(this, Utils.getIteratorSize _).sum
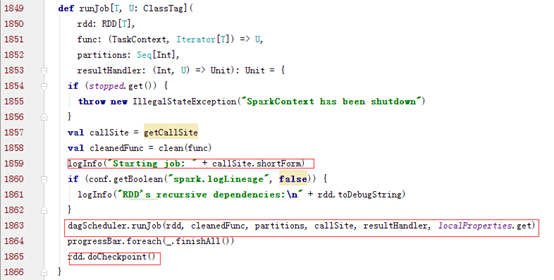
Spark Action会触发SparkContext类的runJob,而runJob会继续调用DAGSchduler类的runJob

DAGSchduler类的runJob方法调用submitJob方法,并根据返回的completionFulture的value判断Job是否完成。
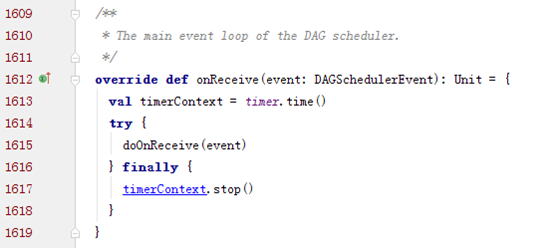
onReceive用于DAGScheduler不断循环的处理事件,其中submitJob()会产生JobSubmitted事件,进而触发handleJobSubmitted方法。

正常情况下会根据finalStage创建一个ActiveJob。而finalStage就是由spark action对应的finalRDD生成的,而该stage要确认所有依赖的stage都执行完,才可以执行。也就是通过getMessingParentStages方法判断的。

这个方法用一个栈来实现递归的切分stage,然后返回一个宽依赖的HashSet,如果是宽依赖类型就会调用
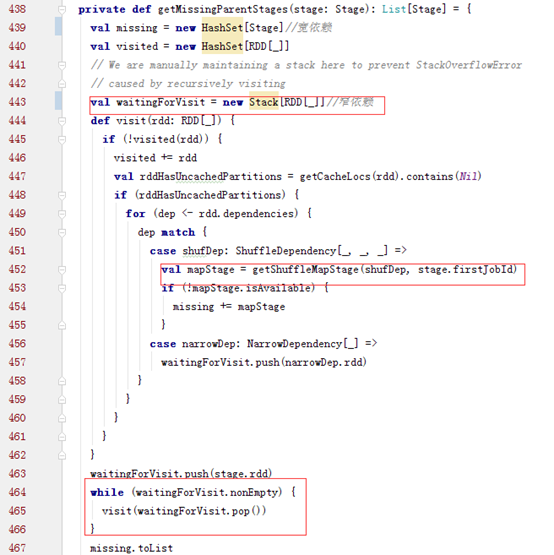
之后提交stage,根据missingStage执行各个stage。划分DAG结束

submitStage会依次执行这个DAG中的stage,如果有父stage就先执行父stage,否则就提交这个stage,加入watingstages中。

示例:
scala> sc.makeRDD(Seq(1,2,3)).count
16/10/28 17:54:59 [INFO] [org.apache.spark.SparkContext:59] - Starting job: count at <console>:13
16/10/28 17:54:59 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Got job 0 (count at <console>:13) with 22 output partitions (allowLocal=false)
16/10/28 17:54:59 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Final stage: Stage 0(count at <console>:13)
16/10/28 17:54:59 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Parents of final stage: List()
16/10/28 17:54:59 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Missing parents: List()
16/10/28 17:54:59 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Submitting Stage 0 (ParallelCollectionRDD[0] at makeRDD at <console>:13), which has no missing parents
scala> sc.makeRDD(Seq(1,2,3)).map(l =>(l,1)).reduceByKey((v1,v2) => v1+v2).collect
16/10/28 18:00:07 [INFO] [org.apache.spark.SparkContext:59] - Starting job: collect at <console>:13
16/10/28 18:00:07 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Registering RDD 2 (map at <console>:13)
16/10/28 18:00:07 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Got job 1 (collect at <console>:13) with 22 output partitions (allowLocal=false)
16/10/28 18:00:07 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Final stage: Stage 2(collect at <console>:13)
16/10/28 18:00:07 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Parents of final stage: List(Stage 1)
16/10/28 18:00:07 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Missing parents: List(Stage 1)
16/10/28 18:00:07 [INFO] [org.apache.spark.scheduler.DAGScheduler:59] - Submitting Stage 1 (MappedRDD[2] at map at <console>:13), which has no missing parents
collect依赖于reduceByKey,reduceByKey依赖于map,而reduceByKey是一个Shuffle操作,故会先提交map (Stage 1 (MappedRDD[2] at map at <console>:13))
Spark DAGSheduler生成Stage过程分析实验的更多相关文章
- Spark2.2+ES6.4.2(三十一):Spark下生成测试数据,并在Spark环境下使用BulkProcessor将测试数据入库到ES
Spark下生成2000w测试数据(每条记录150列) 使用spark生成大量数据过程中遇到问题,如果sc.parallelize(fukeData, 64);的记录数特别大比如500w,1000w时 ...
- Spark 资源调度包 stage 类解析
spark 资源调度包 Stage(阶段) 类解析 Stage 概念 Spark 任务会根据 RDD 之间的依赖关系, 形成一个DAG有向无环图, DAG会被提交给DAGScheduler, DAGS ...
- spark job, stage ,task介绍。
1. spark 如何执行程序? 首先看下spark 的部署图: 节点类型有: 1. master 节点: 常驻master进程,负责管理全部worker节点. 2. worker 节点: 常驻wor ...
- Spark Streaming应用启动过程分析
本文为SparkStreaming源码剖析的第三篇,主要分析SparkStreaming启动过程. 在调用StreamingContext.start方法后,进入JobScheduler.start方 ...
- spark 中划分stage的思路
窄依赖指父RDD的每一个分区最多被一个子RDD的分区所用,表现为 一个父RDD的分区对应于一个子RDD的分区 两个父RDD的分区对应于一个子RDD 的分区. 宽依赖指子RDD的每个分区都要依赖于父RD ...
- spark中job stage task关系
1.1 例子,美国 1880 - 2014 年新生婴儿数据统计 目标:用美国 1880 - 2014 年新生婴儿的数据来做做简单的统计 数据源:https://catalog.data.gov 数据格 ...
- Spark Streaming和Flume-NG对接实验
Spark Streaming是一个新的实时计算的利器,而且还在快速的发展.它将输入流切分成一个个的DStream转换为RDD,从而可以使用Spark来处理.它直接支持多种数据源:Kafka, Flu ...
- Spark(四十八):Spark MetricsSystem信息收集过程分析
MetricsSystem信息收集过程 参考: <Apache Spark源码走读之21 -- WEB UI和Metrics初始化及数据更新过程分析> <Spark Metrics配 ...
- spark 笔记 8: Stage
Stage 是一组独立的任务,他们在一个job中执行相同的功能(function),功能的划分是以shuffle为边界的.DAG调度器以拓扑顺序执行同一个Stage中的task. /** * A st ...
随机推荐
- D3中动画(transition函数)的使用
关于transition的几个基本点: 1. transition()是针对与每个DOM element的,每个DOM element的transition并不会影响其他DOM element的tra ...
- jquery 回车事件
简单地记下jquery实现回车事件,代码如下: 全局: $(document).keydown(function(e){ if(e.keyCode==13){ $(".login-li in ...
- 构建高性能的MYSQL数据库系统
实验环境: DB1:172.16.1.100 DB2:172.16.1.101 VRRIP:172.16.1.99 步骤: yum -y install mysql 1.修改DB1的mysql配置文件 ...
- 网站banner写法
css .banner{ width: %; height: 375px; background: url(X.jpg) no-repeat center;} html <div class=& ...
- Codeforces CF#628 Education 8 E. Zbazi in Zeydabad
E. Zbazi in Zeydabad time limit per test 5 seconds memory limit per test 512 megabytes input standar ...
- 从零开始山寨Caffe·捌:IO系统(二)
生产者 双缓冲组与信号量机制 在第陆章中提到了,如何模拟,以及取代根本不存的Q.full()函数. 其本质是:除了为生产者提供一个成品缓冲队列,还提供一个零件缓冲队列. 当我们从外部给定了固定容量的零 ...
- 如何发布付费WP8应用
如何发布付费应用,听起来蛮简单的,事实上也确实如此,但是发布付费WP8应用前的资料填写却让我郁闷不已. 我打开仪表板,点击进入账户--账户摘要,填写税务资料和付款账户,发现付款账户保存成功了,税务资料 ...
- 四道简单DP
DP类题目找到子问题(状态),然后找到转移方程,就OK #dp #likes matrixchain #according to two point's distance to recurrence ...
- js兼容总结之获取非行间样式
非行间样式案例 #div1 { width: 200px; height: 200px; background: red; } IE获取非行间样式 var oDiv = document.getEle ...
- tungsten抽取和应用mysql binlog
首先举例说明 api的基本使用方式 首先进行配置 , 可以看到源数据库和目的数据库 TungstenProperties tp=new TungstenProperties(); tp.setStri ...