
《GPU高性能编程CUDA实战》第九章 原子性
▶ 本章介绍了原子操作,给出了基于原子操作的直方图计算的例子。
● 章节代码
 #include <stdio.h>

 #include "cuda_runtime.h"

 #include "device_launch_parameters.h"

 #include "D:\Code\CUDA\book\common\book.h"

 #define SIZE    (100*1024*1024)

 #define USE_SHARE_MEMORY true

 __global__ void histo_kernel(unsigned char *buffer, long size, unsigned int *histo)

 {

     int i = threadIdx.x + blockIdx.x * blockDim.x;

 #if USE_SHARE_MEMORY

     __shared__  unsigned int temp[];

     temp[threadIdx.x] = ;

     __syncthreads();

     while (i < size)

     {

         atomicAdd(&temp[buffer[i]], );

         i += blockDim.x * gridDim.x;

     }

     __syncthreads();

     atomicAdd(&(histo[threadIdx.x]), temp[threadIdx.x]);

 #else

     while (i < size)

     {

         atomicAdd(&histo[buffer[i]], );

         i += blockDim.x * gridDim.x;;

     }

 #endif

     return;

 }

 int main(void)

 {

     int i;

     unsigned char *buffer = (unsigned char*)big_random_block(SIZE);// 内置的生成随机字符数组的函数

     cudaEvent_t     start, stop;

     cudaEventCreate(&start);

     cudaEventCreate(&stop);

     cudaEventRecord(start, );

     unsigned char *dev_buffer;

     unsigned int *dev_histo;

     cudaMalloc((void**)&dev_buffer, SIZE);

     cudaMemcpy(dev_buffer, buffer, SIZE, cudaMemcpyHostToDevice);

     cudaMalloc((void**)&dev_histo,  * sizeof(int));

     cudaMemset(dev_histo, ,  * sizeof(int));

     cudaDeviceProp  prop;

     cudaGetDeviceProperties(&prop, );

     int blocks = prop.multiProcessorCount;// 书:实验表明使用MPS的两倍计算效率最高

     histo_kernel << <blocks * ,  >> >(dev_buffer, SIZE, dev_histo);

     unsigned int    histo[];

     cudaMemcpy(histo, dev_histo,  * sizeof(int), cudaMemcpyDeviceToHost);

     cudaEventRecord(stop, );

     cudaEventSynchronize(stop);

     float   elapsedTime;

     cudaEventElapsedTime(&elapsedTime, start, stop);

     printf("Time to generate:  %3.1f ms\n", elapsedTime);

     long histoCount = ;

     for (i = ; i < ; i++)

         histoCount += histo[i];

     printf("Histogram Sum:  %ld\n", histoCount);

     for (i = ; i < SIZE; i++)// 验证结果

         histo[buffer[i]]--;

     for (i = ; i < ; i++)

     {

         if (histo[i] != )

             printf("Failure at hist[%d] == %d\n", i,histo[i]);

     }

     if (i == )

         printf("\n\tSucceeded!\n");

     cudaFree(dev_histo);

     cudaFree(dev_buffer);

     free(buffer);

     cudaEventDestroy(start);

     cudaEventDestroy(stop);

     getchar();

     return ;

 }
● 使用全局内存时,只要在每次线程尝试 +1 时使用原子加法即可;使用共享内存时算法分两步,线程先用原子加法往各线程块的共享内存中写入,同步以后,再用原子加法把各共享内存的结果往全局内存中写入。减缓了全局内存的写入冲突。
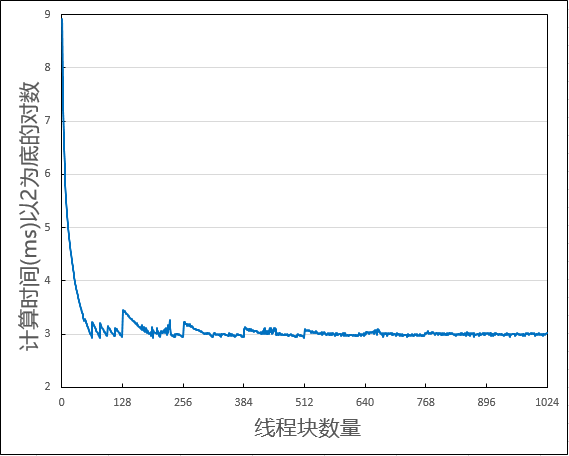
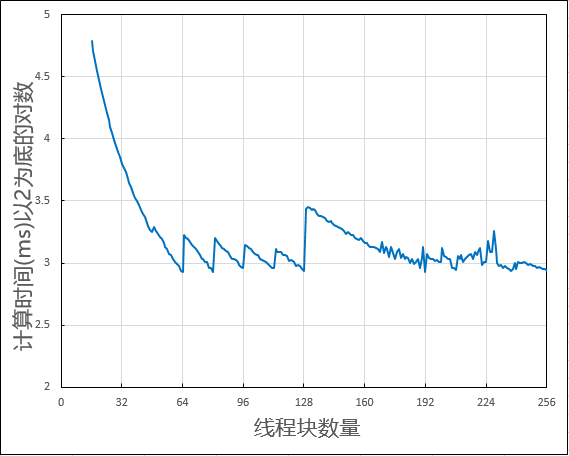
● 代码使用了两倍数量的MPS作为线程块数量,认为这样计算效率最高。在 GTX1070 上 prop.multiProcesser 为 16,程序默认使用 32 个线程块进行计算,我另用 1 到 256 个线程块依次测试,结果如下。
● big_random_block()定义于book.h中
 void* big_random_block(int size)

 {

     unsigned char *data = (unsigned char*)malloc(size);

     for (int i = ; i < size; i++)

         data[i] = rand();

     return data;

 }
《GPU高性能编程CUDA实战》第九章 原子性的更多相关文章
- [问题解决]《GPU高性能编程CUDA实战》中第4章Julia实例“显示器驱动已停止响应,并且已恢复”问题的解决方法
以下问题的出现及解决都基于"WIN7+CUDA7.5". 问题描述:当我编译运行<GPU高性能编程CUDA实战>中第4章所给Julia实例代码时,出现了显示器闪动的现象 ...
- 《GPU高性能编程CUDA实战》第十一章 多GPU系统的CUDA C
▶ 本章介绍了多设备胸膛下的 CUDA 编程,以及一些特殊存储类型对计算速度的影响 ● 显存和零拷贝内存的拷贝与计算对比 #include <stdio.h> #include " ...
- 《GPU高性能编程CUDA实战》第五章 线程并行
▶ 本章介绍了线程并行,并给出四个例子.长向量加法.波纹效果.点积和显示位图. ● 长向量加法(线程块并行 + 线程并行) #include <stdio.h> #include &quo ...
- 《GPU高性能编程CUDA实战》第四章 简单的线程块并行
▶ 本章介绍了线程块并行,并给出两个例子:长向量加法和绘制julia集. ● 长向量加法,中规中矩的GPU加法,包含申请内存和显存,赋值,显存传入,计算,显存传出,处理结果,清理内存和显存.用到了 t ...
- 《GPU高性能编程CUDA实战》第七章 纹理内存
▶ 本章介绍了纹理内存的使用,并给出了热传导的两个个例子.分别使用了一维和二维纹理单元. ● 热传导(使用一维纹理) #include <stdio.h> #include "c ...
- 《GPU高性能编程CUDA实战》第六章 常量内存
▶ 本章介绍了常量内存的使用,并给光线追踪的一个例子.介绍了结构cudaEvent_t及其在计时方面的使用. ● 章节代码,大意是有SPHERES个球分布在原点附近,其球心坐标在每个坐标轴方向上分量绝 ...
- 《GPU高性能编程CUDA实战》第三章 CUDA设备相关
▶ 这章介绍了与CUDA设备相关的参数,并给出了了若干用于查询参数的函数. ● 代码(已合并) #include <stdio.h> #include "cuda_runtime ...
- 《GPU高性能编程CUDA实战中文》中第四章的julia实验
在整个过程中出现了各种问题,我先将我调试好的真个项目打包,提供下载. /* * Copyright 1993-2010 NVIDIA Corporation. All rights reserved. ...
- 《GPU高性能编程CUDA实战》附录二 散列表
▶ 使用CPU和GPU分别实现散列表 ● CPU方法 #include <stdio.h> #include <time.h> #include "cuda_runt ...
随机推荐
- C#浮点数保留位数
C#浮点数保留位数 这里用String.Forma("{0:F}",x);来解决. 下面是试验和截图 using System; using System.Collections. ...
- IDEA中遇到One of the two will be used. Which one is undefined.
某次启动idea的时候看到控制台提示如下错误 : objc[]: Class JavaLaunchHelper is implemented .0_131.jdk/Contents/Home/bin/ ...
- 【java规则引擎】《Drools7.0.0.Final规则引擎教程》第3章 3.2 KIE概念&FACT对象
转载:https://blog.csdn.net/wo541075754/article/details/74943236 3.2.1 什么是KIE KIE(Knowledge Is Everythi ...
- 动画Completed事件里获取执行该动画的UI对象
转:http://www.cnblogs.com/xyq/p/3775732.html 昨天群里有位童鞋提出如何在动画完成事件Completed里获取到执行该动画的UI对象. WPF里动画的Compl ...
- vertx.io 与nodejs 一个简单的性能比较
vertx.io 与node 都是可以进行js运行的一个引擎,但是vertx 支持的语言相对于node 多,可以查看官网.今天下网上查询相关的信息 时来了解到vertx.io 性能比node 好,于是 ...
- 树莓派的媒体播放软件omxplayer
树莓派中的CPU性能较差,而GPU较强大.omxplayer是专门针对树莓派的GPU的播放器.( made by Edgar (gimli) Hucek from the XBMC/Kodi proj ...
- 理解git
为了真正了解git,我们从底部.底层开始,了解git核心,知其然并知其所以然. 为什么要进行版本控制呢? 因为编写文件不可能一次到位,文件总是有不同的状态需要保存下来,方便以后出错回滚. git 是目 ...
- 转jmeter --JDBC请求
做JDBC请求,首先要了解这个JDBC对象是什么,然后寻找响应的数据库连接URL和数据库驱动. 数据库URL:jdbc:sqlserver://200.99.197.190:1433;database ...
- 【数据库】Eclipse连接MySQL数据库
我的环境:MySQL:mysql-essential-5.1.51-win32 jdbc驱动:我已经上传到csdn上一个:http://download.csdn.net/detail/paulwin ...
- 关于IOS给我的启发
用了将近一年半的iOS,从4到4S,iOS5到iOS6.这里谈谈自己对iOS的一些看法,以及这款移动操作系统给我的启发.我知道这个帖子发出来可能有点“危险”.我从不发水贴,这些积分都是大家给的,不是灌 ...