
python3爬虫爬取金庸小说所有角色
# -*- coding:utf-8 -*-

import requests

from bs4 import BeautifulSoup

url = 'http://www.jinyongwang.com/data/renwu/';

def getHTML(url):

    r = requests.get(url)

    return r.content

def parseHTML(html):

    soup = BeautifulSoup(html,'html.parser')

    body = soup.body

    main = body.find('div',attrs={'class':'main'})

    booklist = main.find('div',attrs={'class':'booklist'})

    for datapice in booklist.find_all('div',attrs={'class':'datapice'}):

        for a in datapice.find_all('a'):

            print(a.get_text().replace(' ',''))

html = getHTML(url);

print(parseHTML(html))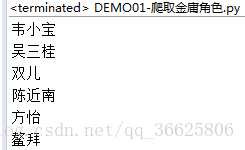
python3爬虫爬取金庸小说所有角色的更多相关文章
- 使用scrapy爬取金庸小说目录和章节url
刚接触使用scrapy的时候,如果一开始就想实现特别复杂的配置,显然是不太现实的,用一些小的例子可以帮助自己理解各个模块. 今天的目标:爬取http://www.luoxia.com/shendiao ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python3爬虫爬取网页思路及常见问题(原创)
学习爬虫有一段时间了,对遇到的一些问题进行一下总结. 爬虫流程可大致分为:请求网页(request),获取响应(response),解析(parse),保存(save). 下面分别说下这几个过程中可以 ...
- python3 爬虫---爬取糗事百科
这次爬取的网站是糗事百科,网址是:http://www.qiushibaike.com/hot/page/1 分析网址,参数''指的是页数,第二页就是'/page/2',以此类推... 一.分析网页 ...
- python3 爬虫---爬取豆瓣电影TOP250
第一次爬取的网站就是豆瓣电影 Top 250,网址是:https://movie.douban.com/top250?start=0&filter= 分析网址'?'符号后的参数,第一个参数's ...
- python3 爬虫爬取深圳公租房轮候库(深圳房网)
深圳公租房轮候库已经朝着几十万人的规模前进了,这是截至16年10月之前的数据了,贴上来大家体会下 所以17年已更新妥妥的10W+ 今天就拿这个作为爬虫的练手项目 1.环境准备: 操作系统:win10 ...
- python3爬虫-爬取新浪新闻首页所有新闻标题
准备工作:安装requests和BeautifulSoup4.打开cmd,输入如下命令 pip install requests pip install BeautifulSoup4 打开我们要爬取的 ...
- python3爬虫-爬取58同城上所有城市的租房信息
from fake_useragent import UserAgent from lxml import etree import requests, os import time, re, dat ...
- python3爬虫爬取猫眼电影TOP100(含详细爬取思路)
待爬取的网页地址为https://maoyan.com/board/4,本次以requests.BeautifulSoup css selector为路线进行爬取,最终目的是把影片排名.图片.名称.演 ...
随机推荐
- JS截取字符串方法集合
使用 substring()或者slice() 函数:split() 功能:使用一个指定的分隔符把一个字符串分割存储到数组 例子: str="jpg|bmp|gif|ico|png&qu ...
- 【XP系统下载U盘装系统】用电脑店超级U盘装XP系统详细图文教程
现在U盘装系统已经越来越流行了,不仅方便而且简单,由于U盘启动盘用的制作工具不同,其中比较流行的有老毛桃.电脑店.大白菜.一键U盘装系统等等,因此安装过程中也有不尽相同的,今天就和大家分享下利用电脑店 ...
- ubuntu 16 下安装 Ubuntu Make
第一步:下载安装包 地址:http://ftp.gnu.org/gnu/make/ 第二步:解压 先进入存放文件目录,图示: 进行解压,图示: 解压并copy到安装目录 第三步:编译 1.查看目录, ...
- 月薪20k+的测试工程师都会这项技能!
一说到测试,很多人认为就是在一直"点点点"找bug的重复性工作,这是早期手工测试给人的刻板印象,随着测试行业的发展,"会代码"越来越成为测试工程师的一个标签. ...
- 芮勇博士荣获2016年IEEE 计算机学会技术成就奖
微软亚洲研究院常务副院长 芮勇 日前,电气电子工程师学会(the Institute of Electrical and Electronics Engineers, IEEE)计算机学会(Comp ...
- Jquery Ajax Post Json
var markers = { "markers": [ { "position": "128.3657142857143", " ...
- 使用python抓取美团商家信息
抓取美团商家信息 import requests from bs4 import BeautifulSoup import json url = 'http://bj.meituan.com/' ur ...
- Blind Estimation and Detection of Space-Time Trellis Coded Transmissions over the Rayleigh Fading MIMO Channel
目录 文章来源 摘要 基本概念 粒子滤波 时间序列模型 系统模型 通信系统 经典状态空间表示 论文所提出的状态空间表示 借鉴之处 文章来源 IEEE TRANSACTIONS ON COMMUNICA ...
- 如何提高码农产量,基于java的web快速开发平台之自定义表单开发随笔
老板 :下班前一定写完? 程序猿:可以,下班前能一定给! 第二天早上上班~~~ 老板:这都第二天了,怎么没写完? 程序猿:我还没有下班呢! 哎!程序猿的痛啊 公司上线的项目有不少销售记录表,又是报价单 ...
- Mybatis笔记01-基本原理,配置文件,映射文件,以及调用过程
Mybatis基本原理 应用程序找Mybatis要数据 mybatis从数据库中找来数据 2.1 通过mybatis-config.xml 定位哪个数据库 2.2 通过Category.xml执行对应 ...