
C++ 提取网页内容系列之五 整合爬取豆瓣读书
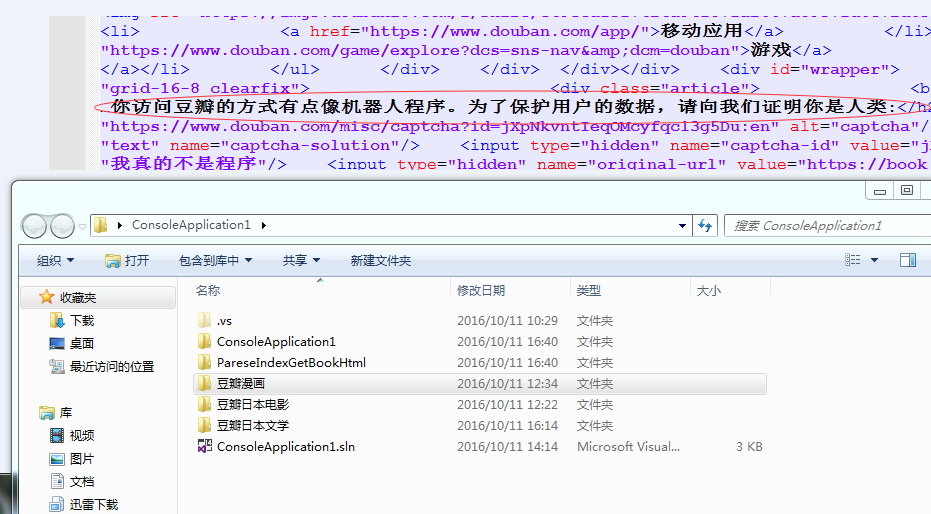
工作太忙 没有时间细化了 就说说 主要内容吧
下载和分析漫画是分开的
下载豆瓣漫画页面是使用之前的文章的代码
见http://www.cnblogs.com/itdef/p/4171179.html
http://www.cnblogs.com/itdef/p/4081963.html
注意 豆瓣网是https
下载后进行页面分析
fstream fs(szfileName);
stringstream ss; // 创建字符串流对象
ss << fs.rdbuf(); // 把文件流中的字符输入到字符串流中
fs.close();
string str = ss.str(); // 获取流中的字符串
页面不大 载入到string中 如果是UTF8 还需要进行GBK到UTF8的转换
然后使用正则 摘出每个漫画索引信息 存入vector<string>
string strRegex = "<li class=\"subject-item\">.*?</li>";
vector<string> vstr;
regex regExpress(strRegex);
smatch ms;
try {
while (regex_search(strText, ms, regExpress))
{
for (string::size_type i = 0; i < ms.size(); ++i)
{
vstr.push_back(ms.str(i));
}
strText = ms.suffix().str();
}
}
catch (exception& e)
{
cerr << e.what() << endl;
return vstr;
}
然后在对每本书的信息进行分析 解析出 书本名 简介 评分等
由于这些信息都是有固定标签 用正则反而麻烦 所以使用的字符串查找
basic_string <char>::size_type keyWordStart = s.find("title=\"");
basic_string <char>::size_type keyWordEnd = s.find("\"", keyWordStart + sizeof("title=\"")-1);
if ((keyWordStart != string::npos) && (keyWordEnd != string::npos) && (keyWordEnd > keyWordStart))
{
string strKeyWord = s.substr(keyWordStart+ sizeof("title=\"") - 1, keyWordEnd - keyWordStart- sizeof("title=\"")+1);
cout << strKeyWord << endl;
}
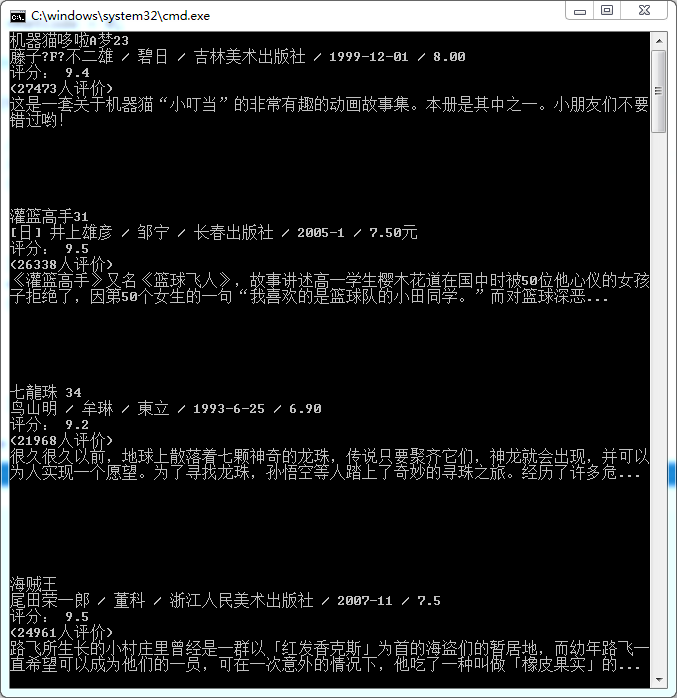
最后结果如图
C++ 提取网页内容系列之五 整合爬取豆瓣读书的更多相关文章
- python爬虫:利用正则表达式爬取豆瓣读书首页的book
1.问题描述: 爬取豆瓣读书首页的图书的名称.链接.作者.出版日期,并将爬取的数据存储到Excel表格Douban_I.xlsx中 2.思路分析: 发送请求--获取数据--解析数据--存储数据 1.目 ...
- Python爬虫使用lxml模块爬取豆瓣读书排行榜并分析
上次使用了BeautifulSoup库爬取电影排行榜,爬取相对来说有点麻烦,爬取的速度也较慢.本次使用的lxml库,我个人是最喜欢的,爬取的语法很简单,爬取速度也快. 本次爬取的豆瓣书籍排行榜的首页地 ...
- Python爬虫爬取豆瓣读书
一,准备工作. 工具:win10+Python3.6 爬取目标:爬取图中红色方框的内容. 原则:能在源码中看到的信息都能爬取出来. 信息表现方式:CSV转Excel. 二,具体步骤. 先给出具体代码吧 ...
- scrapy框架爬取豆瓣读书(1)
1.scrapy框架 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
- python实例:自动爬取豆瓣读书短评,分析短评内容
思路: 1.打开书本“更多”短评,复制链接 2.脚本分析链接,通过获取短评数,计算出页码数 3.通过页码数,循环爬取当页短评 4.短评写入到txt文本 5.读取txt文本,处理文本,输出出现频率最高的 ...
- 【转】爬取豆瓣电影top250提取电影分类进行数据分析
一.爬取网页,获取需要内容 我们今天要爬取的是豆瓣电影top250页面如下所示: 我们需要的是里面的电影分类,通过查看源代码观察可以分析出我们需要的东西.直接进入主题吧! 知道我们需要的内容在哪里了, ...
- 爬虫系列(十) 用requests和xpath爬取豆瓣电影
这篇文章我们将使用 requests 和 xpath 爬取豆瓣电影 Top250,下面先贴上最终的效果图: 1.网页分析 (1)分析 URL 规律 我们首先使用 Chrome 浏览器打开 豆瓣电影 T ...
- 爬虫系列(十一) 用requests和xpath爬取豆瓣电影评论
这篇文章,我们继续利用 requests 和 xpath 爬取豆瓣电影的短评,下面还是先贴上效果图: 1.网页分析 (1)翻页 我们还是使用 Chrome 浏览器打开豆瓣电影中某一部电影的评论进行分析 ...
- 爬虫系列1:Requests+Xpath 爬取豆瓣电影TOP
爬虫1:Requests+Xpath 爬取豆瓣电影TOP [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]: ...
随机推荐
- dependency walker检查dll依赖关系目录设置的问题
废话少说,直接上图 图中来看,似乎IESHIMS.DLL文件不存在报错,实际是因为没有加载IESHIMS.DLL所在的路径. 在我的电脑里面搜索有两个同名的dll,一个是32位的,一个是64位的. C ...
- 推导式_字典_enumerate
字典推导式_enumerate: ''' 功能: 枚举, 拿出iter的每一个元素和索引(可以设置start改变) 组队放入一个元祖中返回 参数:iterable, start(指定索引开始的位置) ...
- XML和实体类之间相互转换(序列化和反序列化)
我们需要在XML与实体类,DataTable,List之间进行转换,下面是XmlUtil类,该类来自网络并稍加修改. 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 ...
- 通过WebClient模拟post上传文件到服务器
写在前面 最近一直在研究sharepoint的文档库,在上传文件到文档库的过程中,需要模拟post请求,也查找了几种模拟方式,webclient算是比较简单的方式. 一个例子 这里写一个简单接受pos ...
- VLAN中继协议
VTP(VLAN Trunking Protocol):是VLAN中继协议,也被称为虚拟局域网干道协议.作用是十几台交换机在企业网中,配置VLAN工作量大,使用VTP协议,把一台交换机配置成VTP S ...
- composer在phpstorm中安装代码库
E:\php\PHPTutorial\WWW\kmmhtt>composer install composer 安装地址 :https://getcomposer.org/download/
- py目录
Python开发[第二篇]:初识Python Python开发[第三篇]:Python基本数据类型 Python开发[第四篇]:Python基础之函数 &&[4.1]算法递归 冒泡 ...
- PHP响应码和HTTP请求方法
HTTP请求报文由请求行(request line).请求头部(header).空行和请求数据4个部分组成,格式如下 可见请求行由请求方法字段.URL字段和HTTP协议版本字段3个字段组成,它们用空格 ...
- final关键字特点
一.final关键字修饰的类 无法被继承(即不能有子类) 二.final关键字修饰的方法不能被重写 三.final关键字修饰的变量成为常量(即不允许被修改) 开发中经常使用
- 第四篇、Python文件处理
1.文件操作 1) 文件操作流程 a. 打开文件,得到文件句柄并赋值给一个变量 b. 通过句柄对文件进行操作 c. 关闭文件 f=open('a.txt','r',encoding='utf-8') ...