
HUE配置文件hue.ini 的mapred_clusters模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货!
我的集群机器情况是 bigdatamaster(192.168.80.10)、bigdataslave1(192.168.80.11)和bigdataslave2(192.168.80.12)
然后,安装目录是在/home/hadoop/app下。
官方建议在master机器上安装Hue,我这里也不例外。安装在bigdatamaster机器上。
Hue版本:hue-3.9.0-cdh5.5.4
 需要编译才能使用(联网)

 说给大家的话:大家电脑的配置好的话,一定要安装cloudera manager。毕竟是一家人的。
同时,我也亲身经历过,会有部分组件版本出现问题安装起来要个大半天时间去排除,做好心里准备。废话不多说,因为我目前读研,自己笔记本电脑最大8G,只能玩手动来练手。
纯粹是为了给身边没高配且条件有限的学生党看的! 但我已经在实验室机器群里搭建好cloudera manager 以及 ambari都有。
大数据领域两大最主流集群管理工具Ambari和Cloudera Manger
Cloudera安装搭建部署大数据集群(图文分五大步详解)(博主强烈推荐)
Ambari安装搭建部署大数据集群(图文分五大步详解)(博主强烈推荐)
对于这个模块,其实可以跳过,毕竟有了yarn_clusters。现在都是用YARN。至于Hue官网为什么还要写出这一模块,是综合考虑把!

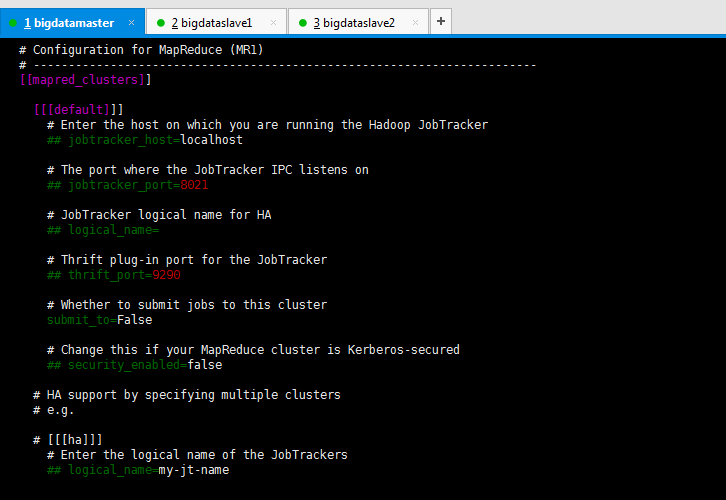
 # Configuration for MapReduce (MR1)

  # ------------------------------------------------------------------------

  [[mapred_clusters]]

    [[[default]]]

      # Enter the host on which you are running the Hadoop JobTracker

      ## jobtracker_host=localhost

      # The port where the JobTracker IPC listens on

      ## jobtracker_port=

      # JobTracker logical name for HA

      ## logical_name=

      # Thrift plug-in port for the JobTracker

      ## thrift_port=

      # Whether to submit jobs to this cluster

      submit_to=False

      # Change this if your MapReduce cluster is Kerberos-secured

      ## security_enabled=false

    # HA support by specifying multiple clusters

    # e.g.

    # [[[ha]]]

      # Enter the logical name of the JobTrackers

      ## logical_name=my-jt-name
同时,大家可以关注我的个人博客:
http://www.cnblogs.com/zlslch/ 和 http://www.cnblogs.com/lchzls/ http://www.cnblogs.com/sunnyDream/
详情请见:http://www.cnblogs.com/zlslch/p/7473861.html
人生苦短,我愿分享。本公众号将秉持活到老学到老学习无休止的交流分享开源精神,汇聚于互联网和个人学习工作的精华干货知识,一切来于互联网,反馈回互联网。
目前研究领域:大数据、机器学习、深度学习、人工智能、数据挖掘、数据分析。 语言涉及:Java、Scala、Python、Shell、Linux等 。同时还涉及平常所使用的手机、电脑和互联网上的使用技巧、问题和实用软件。 只要你一直关注和呆在群里,每天必须有收获
对应本平台的讨论和答疑QQ群:大数据和人工智能躺过的坑(总群)(161156071)
HUE配置文件hue.ini 的mapred_clusters模块详解(图文详解)(分HA集群和非HA集群)的更多相关文章
- HUE配置文件hue.ini 的hdfs_clusters模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的yarn_clusters模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的hbase模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的Spark模块详解(图文详解)(分HA集群和HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的impala模块详解(图文详解)(分HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的filebrowser模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的hive和beeswax模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的zookeeper模块详解(图文详解)(分HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
- HUE配置文件hue.ini 的pig模块详解(图文详解)(分HA集群和非HA集群)
不多说,直接上干货! 一.默认的pig配置文件 ########################################################################### ...
- HUE配置文件hue.ini 的liboozie和oozie模块详解(图文详解)(分HA集群)
不多说,直接上干货! 我的集群机器情况是 bigdatamaster(192.168.80.10).bigdataslave1(192.168.80.11)和bigdataslave2(192.168 ...
随机推荐
- Eclipse中显示line number
- day15(mysql 的多表查询,事务)
mysql之多表查询 1.合并结果集 作用:合并结果集就是把两个select语句查询的结果连接到一起! /*创建表t1*/ CREATE TABLE t1( a INT PRIMARY KEY , b ...
- (网络流 最大流 Dinic || SAP)Control -- hdu --4289
链接: http://acm.hdu.edu.cn/showproblem.php?pid=4289 http://acm.hust.edu.cn/vjudge/contest/view.action ...
- UFOV页面 使用canvas
canvas画八边形:cxt.beginPath();cxt.beginPath(); canvas内线条的粗细:cxt.lineWidth = '2'; 鼠标消失: css: html, body ...
- 【TypeScript】TypeScript 学习 5——方法
在 JavaScript 中,有两种方式定义方法. 1.命名的方法 function add(x,y){ return x+y; } 2.匿名方法 var myAdd = function(x,y) ...
- Failed to get D-Bus connection: Operation not permitted
通过centos7镜像创建了一个docker容器,并在容器中安装了一个apache服务,但是启动时发生如下报错 [root@1346963c2247 ~]# rpm -qa | grep httpdh ...
- H2内存数据库支持存储到文件
准备工作 1.下载JDK(本人下载的版本为JDK1.7).设置环境变量JAVA_HOME,设置PATH(%JAVA_HOME%\bin%). 2.下载并解压:h2-2014-07-13.zip 官网下 ...
- C++ 补遗
C++通过引用传递数组 数组形参可以声明为数组的引用.如果形参是数组的引用,编译器不会将数组实参转化为指针,而是传递数组的引用本身. 在这种情况下,数组大小成为形参和实参类型的一部分(实参长度与形参长 ...
- Hibernate与Jpa的关系
JPA全称Java Persistence API.JPA通过JDK 5.0注解或XML描述对象-关系表的映射关系,并将运行期的实体对象持久化到数据库中. JPA的总体思想和现有Hibernate.T ...
- jenkins调用本地搭建sendmail邮件服务器发送邮件
应用jenkins发送邮件的邮件服务器 SMTP server 可以是本地的,也可以是远程,远程的就不多说了,在此说一下如何在jenkins本地服务器上搭建邮件服务器,并用jenkins发送邮件,详细 ...