
beautifulsoup 基本语法
案例一:
#coding=utf-8
import json
import requests
from bs4 import BeautifulSoup
url = 'http://www.itest.info/courses' # 定义被抓取页面的url
soup = BeautifulSoup(requests.get(url).text, 'html.parser')# 获取被抓取页面的html代码,并使用html.parser来实例化BeautifulSoup,属于固定套路
for course in soup.find_all('h4'):# 遍历页面上所有的h4标签
print course.text.encode('utf-8')# 打印出h4标签的text字符 如: 测试开发--试验班
print course # 打印出h4的text字符加标签 如:<h4>测试开发--试验班</h4>
案例二:
图例:
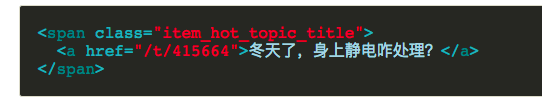
url = 'https://www.v2ex.com/'
soup = BeautifulSoup(requests.get(url).text, 'html.parser')
for span in soup.find_all('span', class_='item_hot_topic_title'):#查找span标签 且样式为class_='item_hot_topic_title',注意是class_,不是class,因为class是python的关键字,所以后面要加个尾巴,防止冲突
print span.find('a').text.encode('utf-8')#获取里面的a标签展示,假如span标签里面有很多a标签,可以 for i in span.find_all('a', href='/t/415664')继续筛选
print span.find('a')['href'].encode('utf-8') #获取href属性,在bs4里,我们可以通过[attribute_name]的方式来获取元素的属性
beautifulsoup 基本语法的更多相关文章
- python网络爬虫之解析网页的BeautifulSoup(爬取电影图片)[三]
目录 前言 一.BeautifulSoup的基本语法 二.爬取网页图片 扩展学习 后记 前言 本章同样是解析一个网页的结构信息 在上章内容中(python网络爬虫之解析网页的正则表达式(爬取4k动漫图 ...
- 数据解析模块BeautifulSoup简单使用
一.准备环境: 1.准备测试页面test.html <html> <head> <title> The Dormouse's story </title> ...
- python爬虫神器PyQuery的使用方法
你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有了一些 ...
- Python开发简单爬虫 - 慕课网
课程链接:Python开发简单爬虫 环境搭建: Eclipse+PyDev配置搭建Python开发环境 Python入门基础教程 用Eclipse编写Python程序 课程目录 第1章 课程介绍 ...
- Python开发简单爬虫(一)
一 .简单爬虫架构: 爬虫调度端:启动爬虫,停止爬虫,监视爬虫运行情况 URL管理器:对将要爬取的和已经爬取过的URL进行管理:可取出带爬取的URL,将其传送给“网页下载器” 网页下载器:将URL指定 ...
- 芝麻HTTP: Python爬虫利器之PyQuery的用法
前言 你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有 ...
- Python开发爬虫之理论篇
爬虫简介 爬虫:一段自动抓取互联网信息的程序. 什么意思呢? 互联网是由各种各样的网页组成.每一个网页对应一个URL,而URL的页面上又有很多指向其他页面的URL.这种URL之间相互的指向关系就形成了 ...
- Python爬虫利器六之PyQuery的用法
前言 你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有 ...
- python爬虫---从零开始(五)pyQuery库
什么是pyQuery: 强大又灵活的网页解析库.如果你觉得正则写起来太麻烦(我不会写正则),如果你觉得BeautifulSoup的语法太难记,如果你熟悉JQuery的语法,那么PyQuery就是你最佳 ...
随机推荐
- SqlBulkCopy 批量导入数据 转换表字段类型
在使用SqlBulkCopy导入数据时,要有一个跟数据库里面同样的DataTable 要赋值表名 要求每个列跟数据库中列同名,并且列的类型要赋值跟数据库中列的类型对应的NET类型 要求数据库中为Nul ...
- Java Spring-IOC和DI
2017-11-06 16:30:25 IOC:控制反转,将对象的创建权交由Spring管理.IOC底层原理:工厂类+反射+配置文件,创建对象交由工厂类完成. DI(Dependency Inject ...
- Python的第一次作业
题目1 : 描述:通过趣味的打怪来学习random随机函数. 代码: from random import * import types choc=0 hs=[100] numer=[randint( ...
- canvas绘制进度条(wepy)
<template> <canvas canvas-id="canvas" style="width:{{width+10}}px;height:{{w ...
- ps怎么替换颜色
1.图像--->>调整--->>替换颜色
- 041——VUE中组件之pros数据的多种验证机制实例详解
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- 008——php字符串中的处理函数(七)
<?php /** *字符串处理函数(六)get_magic_quotes_runtime set_magic_quotes_runtime strip_tags *get_magic_quot ...
- Chrome浏览器插件开发-关于案例
前言 关于案例 下一章 版本更新提示案例 一.前言 上章我们提到过开发一个插件所需要的步骤: Chrome浏览器插件开发-淘宝自动登录 并且还介绍了如何在页面上面注入脚本代码,并且成功的完成用户名和密 ...
- Terminal shortcuts
<backspace> 删除 <ctrl+l> 清空屏幕, 相当于clear <ctrl+e> 光标跳至命令结尾 <ctrl+a> 光标跳至命令开始 & ...
- Pale Moon 苍月浏览器 24.0.1 发布
火狐浏览器知名修改版—苍月浏览器Pale Moon今天发布24.0.1版本,该版本基于Firefox 最近更新的24.0.1正式版. 下载地址: 32位下载:http://relmirror.pale ...