
大数据-HBase HA集群搭建
1、下载对应版本的Hbase,在我们搭建的集群环境中选用的是hbase-1.4.6
将下载完成的hbase压缩包放到对应的目录下,此处我们的目录为/opt/workspace/
2、对已经有的压缩包进行解压缩
[root@master1 workspace]#tar -zxvf hbase-1.4.-bin.tar.gz
3、为了方便可以将文件重命名,此处我们不需要重命名
4、修改配置文件、/etc/profile,添加下面代码
# HBase Config

export HBASE_HOME=/opt/workspace/hbase-1.4.

export PATH=.:${JAVA_HOME}/bin:${SCALA_HOME}/bin:$HADOOP_HOME/sbin:$HADOOP_HOME/bin:${HIVE_HOME}/bin:${SPARK_HOME}/bin:${HBASE_HOME}/bin:${ZK_HOME}/bin:$PATH
[root@master1 workspace]# source /etc/profile
5、修改配置文件hbase-env.sh,在文件中添加如下,其中HBASE_MANAGES_ZK=false 是不启用HBase自带的Zookeeper集群。
export JAVA_HOME=/opt/workspace/jdk1.

export HADOOP_HOME=/opt/workspace/hadoop-2.9.

export HBASE_HOME=/opt/workspace/hbase-1.4.

export HBASE_CLASSPATH=$HADOOP_HOME/etc/hadoop

export HBASE_PID_DIR=/root/hbase/pids

export HBASE_MANAGES_ZK=false

export HBASE_LOG_DIR=${HBASE_HOME}/logs
6、修改配置文件hbase-site.xml,配置如下:
<?xml version="1.0"?>

<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<!--

/**

 *

 * Licensed to the Apache Software Foundation (ASF) under one

 * or more contributor license agreements.  See the NOTICE file

 * distributed with this work for additional information

 * regarding copyright ownership.  The ASF licenses this file

 * to you under the Apache License, Version 2.0 (the

 * "License"); you may not use this file except in compliance

 * with the License.  You may obtain a copy of the License at

 *

 *     http://www.apache.org/licenses/LICENSE-2.0

 *

 * Unless required by applicable law or agreed to in writing, software

 * distributed under the License is distributed on an "AS IS" BASIS,

 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.

 * See the License for the specific language governing permissions and

 * limitations under the License.

 */

-->

<configuration>

        <property>

             <name>hbase.rootdir</name>

             <value>hdfs://hadoop-test/hbase</value>

             <description>The directory shared byregion servers.</description>

        </property>

         <!--port of hbase-->

        <property>

             <name>hbase.zookeeper.property.clientPort</name>

             <value></value>

        </property>

        <!--timeout time-->

        <property>

             <name>zookeeper.session.timeout</name>

             <value></value>

        </property>

        <!--pretend errors caused by time don't synchronize in servers-->

        <property>

            <name>hbase.master.maxclockskew</name>

            <value></value>

        </property>

        <!--cluser host-->

        <property>

             <name>hbase.zookeeper.quorum</name>

             <value>master1,master2,slave1,slave2,slave3</value>

        </property>

        <!--path of tmp-->

        <property>

             <name>hbase.tmp.dir</name>

             <value>/opt/hbase_tmp/tmp</value>

        </property>

        <!-- true means of distributed-->

        <property>

             <name>hbase.cluster.distributed</name>

             <value>true</value>

        </property>

          <!--master-->

          <property>

                <name>hbase.master</name>

                <value></value>

          </property>

          <property>

                <name>hbase.zookeeper.property.dataDir</name>

                <value>/opt/workspace/zookeeper/data</value>

        </property>

        <property>

                <name>hbase.regionserver.restart.on.zk.expire</name>

                <value>true</value>

        </property>

        <property>

               <name>hbase.master.info.port</name>

               <value></value>

         </property>

        <property>

              <name>dfs.support.append</name>

              <value>true</value>

        </property>

</configuration>
其中hbase.rootdir配置的是hdfs地,用来持久化Hbase,ip:port要和hadoop/core-site.xml中的fs.defaultFS保持一致。hbase.cluster.distributed :Hbase的运行模式。false是单机模式,true是分布式模式
7、修改regionservers,指定hbase的主从
slave1

slave2

slave3
8、将该环境配置发送到其余4台服务器
9、启动hbase集群
[root@master1 hbase-1.4.]# cd bin

[root@master1 bin]# start-hbase.sh
报错如下:
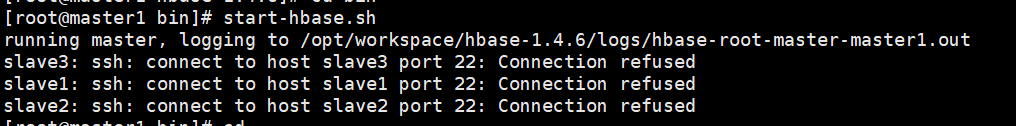
解决:
在hbase-env.sh文件中添加
export HBASE_SSH_OPTS="-p 61333"
重新启动,成功。
[root@master1 hbase-1.4.]# cd bin

[root@master1 bin]# start-hbase.sh
master1节点进程如下:

slave1、slave2、slave3节点进程如下:

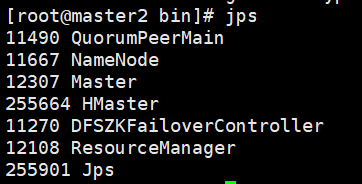
10、启动备用节点的HMaster
[root@master2 hbase-1.4.]# cd bin

[root@master2 bin]# hbase-daemon.sh start master
启动成功,进程如下:
大数据-HBase HA集群搭建的更多相关文章
- 大数据-hadoop HA集群搭建
一.安装hadoop.HA及配置journalnode 实现namenode HA 实现resourcemanager HA namenode节点之间通过journalnode同步元数据 首先下载需要 ...
- 大数据-spark HA集群搭建
一.安装scala 我们安装的是scala-2.11.8 5台机器全部安装 下载需要的安装包,放到特定的目录下/opt/workspace/并进行解压 1.解压缩 [root@master1 ~]# ...
- 大数据学习——HADOOP集群搭建
4.1 HADOOP集群搭建 4.1.1集群简介 HADOOP集群具体来说包含两个集群:HDFS集群和YARN集群,两者逻辑上分离,但物理上常在一起 HDFS集群: 负责海量数据的存储,集群中的角色主 ...
- 大数据中Hadoop集群搭建与配置
前提环境是之前搭建的4台Linux虚拟机,详情参见 Linux集群搭建 该环境对应4台服务器,192.168.1.60.61.62.63,其中60为主机,其余为从机 软件版本选择: Java:JDK1 ...
- 大数据平台Hadoop集群搭建
一.概念 Hadoop是由java语言编写的,在分布式服务器集群上存储海量数据并运行分布式分析应用的开源框架,其核心部件是HDFS与MapReduce.HDFS是一个分布式文件系统,类似mogilef ...
- 大数据:spark集群搭建
创建spark用户组,组ID1000 groupadd -g 1000 spark 在spark用户组下创建用户ID 2000的spark用户 获取视频中文档资料及完整视频的伙伴请加QQ群:9479 ...
- 大数据学习——Storm集群搭建
安装storm之前要安装zookeeper 一.安装storm步骤 1.下载安装包 2.解压安装包 .tar.gz storm 3.修改配置文件 mv /root/apps/storm/conf/st ...
- 大数据中Linux集群搭建与配置
因测试需要,一共安装4台linux系统,在windows上用vm搭建. 对应4个IP为192.168.1.60.61.62.63,这里记录其中一台的搭建过程,其余的可以直接复制虚拟机,并修改相关配置即 ...
- 大数据学习——hadoop集群搭建2.X
1.准备Linux环境 1.0先将虚拟机的网络模式选为NAT 1.1修改主机名 vi /etc/sysconfig/network NETWORKING=yes HOSTNAME=itcast ### ...
随机推荐
- Java线程死锁查看分析方法
如何查看是否有Java线程死锁?下面介绍两种方法. 一.Jconsole Jconsole是JDK自带的图形化界面工具,使用JDK给我们的的工具JConsole,可以通过打开cmd然后输 ...
- 服务器上如何再另外添加一个E盘
我的电脑按右键,选择管理..然后在左边选择磁盘管理,然后对着C盘或者D盘按右键,选择压缩卷,等一下下,就会出现个框框让你选择压缩多少,然后多了一个可用空间,再把它分成一个分区就OK拉 步骤:对可用空间 ...
- Android 密匙库导出
导出debug 签名----------------------------- C:\Documents and Settings\Administrator>keytool -list -v ...
- Modelsim10.2c使用教程(一个完整工程的仿真)
之前玩过Altera的板子,不不, 现在应该叫intel PSG.在QuartusII13.0上老喜欢用modelsim_ae做仿真,小工程用起来也方便,但是我做IIC配置摄像头的时序仿真时,就显得有 ...
- spark配置文件和执行部分代码
export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER-Dspark.deploy.zookeeper.ur ...
- FMX.Platform.TApplicationEvent
FMX.Platform.TApplicationEvent http://docwiki.embarcadero.com/Libraries/Seattle/en/FMX.Platform.TApp ...
- Android-开关机的广播
在上一篇博客Android-sdcard广播的接收处理,中介绍了,如何订阅接收者,去接收系统发送的Sdcard状态改变广播,而这篇博客是订阅接收者,去接收开机/关机的广播 Android操作系统在开机 ...
- linux squid
iptables -F iptables -F -t nat 网关 iptables -t nat -A POSTROUTING -s 10.1.0.0/16 -o eth0 -j MASQUERAD ...
- Snapshot--使用Snapshot来还原数据库
在数据库升级时,为防止升级失败造成的影响,我们通常需要: 1.准备回滚脚本,用于失败后回滚 2.在升级前备份数据库,用于失败后恢复 但回滚脚本需要花费很长时间准备,而备份恢复会导致数据库长时间不可用, ...
- CSS文字大小单位PX、EM的区别
◆px像素(Pixel)是相对长度单位,像素px是相对于显示器屏幕分辨率而言的.(引自CSS2.0手册)◆em是相对长度单位,相对于当前对象内文本的字体尺寸.如当前对行内文本的字体尺寸未被人为设置,则 ...