
大数据中Linux集群搭建与配置
因测试需要,一共安装4台linux系统,在windows上用vm搭建。
对应4个IP为192.168.1.60、61、62、63,这里记录其中一台的搭建过程,其余的可以直接复制虚拟机,并修改相关配置即可。
软件版本选择:
虚拟机:VMware Workstation 12 Pro 版本:12.5.9 build-7535481
Linux:CentOS-7-x86_64-DVD-1804
FTP工具:FileZilla-3.37.4
安装CentOS虚拟机
首先安装虚拟机,成功后重启电脑
新建虚拟机, 配置直接用推荐的经典
选择CentOS的IOS光盘映像
剩下用默认设置,20G硬盘,1G内存,1核CPU
等待加载虚拟机,安装Linxu
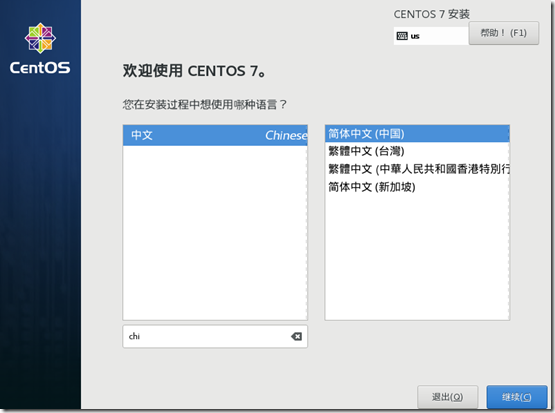
语言选择中文
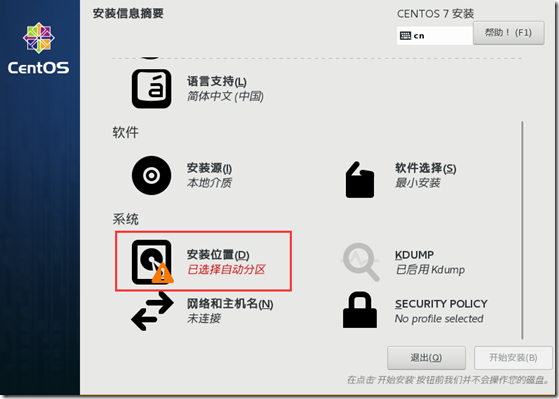
系统安装位置需要进入一次,可以自己分区,不过这里是测试,默认一个区,点击完成
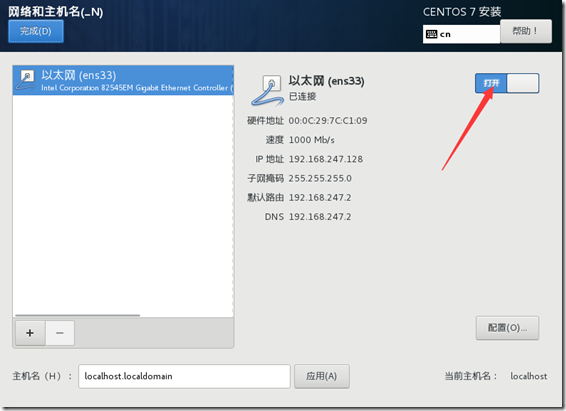
打开自动获取IP
可以在软件选择中指定默认要安装的内容,不过这里因测试,且知道具体安装了什么软件,我这里选择最小安装
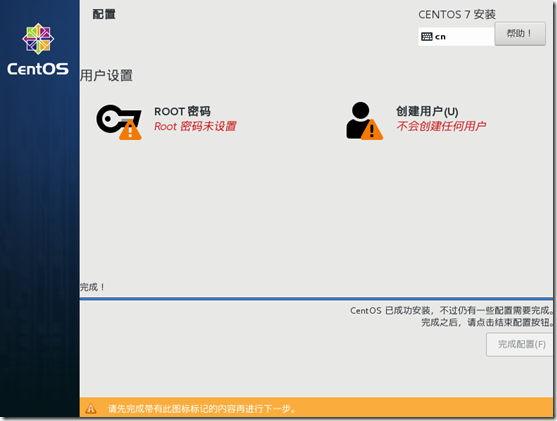
设置root账号的密码,输入完毕点击两次完成键,完成配置开始安装,安装完毕重置
配置Linux环境
输入用户名root,输入密码,登录系统
vm上右键虚拟机,设置,修改网络适配器从NAT模式改为桥接模式
安装网络工具,用于配置IP,若报错无法访问,可能是windows服务没启动,启用VMware DHCP Service,VMware NAT Service两个服务
yum install net-tools -y
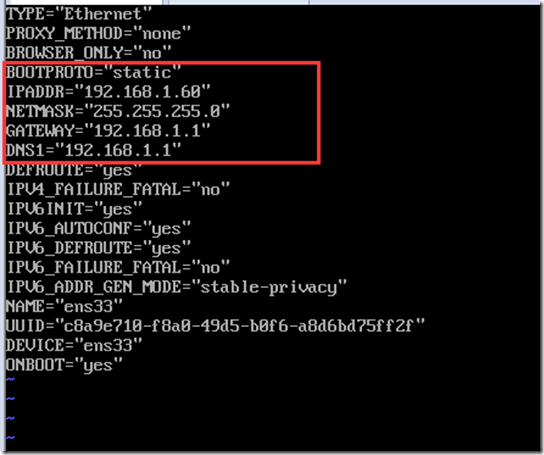
配置静态IP,最后ens33根据各自具体网卡名字来设置
vi /etc/sysconfig/network-scripts/ifcfg-ens33
按i切换到INSERT模式,修改配置文件如下,将BOOTPROTO的值从dhcp改为static,并且增加ip配置,修改完毕按esc,输入:wq保存退出
启用配置,重启网络服务
systemctl restart network
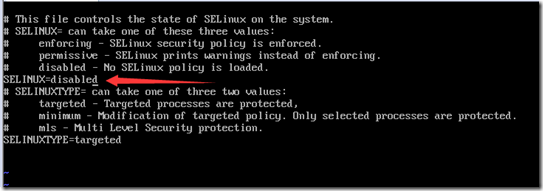
关闭selinux,打开selinux配置文件
vi /etc/selinux/config
修改SELINUX的值为disabled
关闭防火墙
systemctl stop firewalld

systemctl disable firewalld
安装vsftp用于上传各种文件
yum install vsftpd –y
启用ftp并添加ftp用户
systemctl enable vsftpd

systemctl start vsftpd

useradd ftpuser -s /sbin/nologin

passwd ftpuser
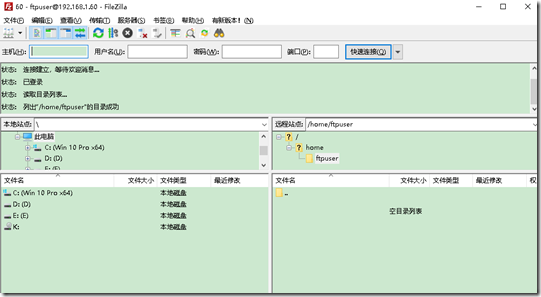
用FileZilla连接,使用普通FTP连接,输入刚创建的ftp用户名密码
配置ssh免密登录
ssh-keygen -t rsa -P ""
cd ~/.ssh

cat id_rsa.pub >> authorized_keys

chmod 0600 authorized_keys

ssh localhost #首次需输入yes,退出登录logoutlogout至此Linux基础环境搭建完毕。
大数据中Linux集群搭建与配置的更多相关文章
- 大数据中Hadoop集群搭建与配置
前提环境是之前搭建的4台Linux虚拟机,详情参见 Linux集群搭建 该环境对应4台服务器,192.168.1.60.61.62.63,其中60为主机,其余为从机 软件版本选择: Java:JDK1 ...
- 大数据中HBase集群搭建与配置
hbase是分布式列式存储数据库,前提条件是需要搭建hadoop集群,需要Zookeeper集群提供znode锁机制,hadoop集群已经搭建,参考 Hadoop集群搭建 ,该文主要介绍Zookeep ...
- 大数据学习——HADOOP集群搭建
4.1 HADOOP集群搭建 4.1.1集群简介 HADOOP集群具体来说包含两个集群:HDFS集群和YARN集群,两者逻辑上分离,但物理上常在一起 HDFS集群: 负责海量数据的存储,集群中的角色主 ...
- 大数据平台Hadoop集群搭建
一.概念 Hadoop是由java语言编写的,在分布式服务器集群上存储海量数据并运行分布式分析应用的开源框架,其核心部件是HDFS与MapReduce.HDFS是一个分布式文件系统,类似mogilef ...
- 大数据-HBase HA集群搭建
1.下载对应版本的Hbase,在我们搭建的集群环境中选用的是hbase-1.4.6 将下载完成的hbase压缩包放到对应的目录下,此处我们的目录为/opt/workspace/ 2.对已经有的压缩包进 ...
- 大数据:spark集群搭建
创建spark用户组,组ID1000 groupadd -g 1000 spark 在spark用户组下创建用户ID 2000的spark用户 获取视频中文档资料及完整视频的伙伴请加QQ群:9479 ...
- 大数据学习——Storm集群搭建
安装storm之前要安装zookeeper 一.安装storm步骤 1.下载安装包 2.解压安装包 .tar.gz storm 3.修改配置文件 mv /root/apps/storm/conf/st ...
- 大数据学习——hadoop集群搭建2.X
1.准备Linux环境 1.0先将虚拟机的网络模式选为NAT 1.1修改主机名 vi /etc/sysconfig/network NETWORKING=yes HOSTNAME=itcast ### ...
- 大数据-spark HA集群搭建
一.安装scala 我们安装的是scala-2.11.8 5台机器全部安装 下载需要的安装包,放到特定的目录下/opt/workspace/并进行解压 1.解压缩 [root@master1 ~]# ...
随机推荐
- (1)构造方法和方法重载 (2)this关键字 (3)方法的传参和递归调用
1.构造方法和方法重载如: Person p = new Person(); - 声明Person类型的引用p指向Person类型的对象 p.show(); - 调用名字为show()的成员方法 1. ...
- Fix for: Permission denied to access property 'toString'
Originally posted by rwolffgang here. Hi guys,when developing a game that runs in an iframe (Faceboo ...
- python第二十课——math模块中常用的函数
属性: e:自然数 pi:圆周率 函数: ceil():向上取整 floor():向下取整 sqrt():开平方根 radians():角度转弧度 degrees():弧度转角度 import mat ...
- jupyter notebook设置主题背景,字体和扩展插件
windows上安装Anaconda (IPython notebook) Anaconda是一个包与环境的管理器,一个Python发行版,以及一个超过1000多个开源包的集合.它是免费和易于安装的, ...
- 随手练——Uva-11584 划分成回文串(区间DP)
思路:dp[i]代表到第i位的最小值,枚举它的前几位,求出最小值. 转移方程:dp[ i ] = min(dp[ i ], dp[ j - 1 ] + 1 ) ; 本来觉得,代码加深部分可以提前bre ...
- 2、JVM--Java内存区域与内存溢出异常
Java与C++之间有一堵由内存动态分配和垃圾收集技术所围成的“高墙”,墙外面的人想进去,墙里面的人却想出来. 2.1.概述 对于从事C.C++程序开发的开发人员来说,在内存管理领域,他们既是拥有最高 ...
- [luogu1080] 国王游戏
题面 这是一个比较经典(害人不浅)的题目啊, 很早就听说过这个题目的大名, 今日得见, 果然非凡题所可以比拟的啊, 行了, 瞎扯就先扯到这里, 题目大意应该是很好解释的, 我就不解释了, 要使得最 ...
- 使用 git push 出现error setting certificate verify locations问题记录
昨天重新装了个系统,使用时出现了error setting certificate verify locations. 出现错误仔细看错误提示,这可是解决问题的关键信息. 将错误的信息复制到搜索引擎中 ...
- 豆瓣电影top250爬取并保存在MongoDB里
首先回顾一下MongoDB的基本操作: 数据库,集合,文档 db,show dbs,use 数据库名,drop 数据库 db.集合名.insert({}) db.集合名.update({条件},{$s ...
- centos6.5升级内核到3.0
因为是使用centos6.5安装的docker,而docker需要内核3.0以上的支持,所以必须升级内核 1. 导入public key rpm --import https://www.elrepo ...