
利用Python进行数据分析 第5章 pandas入门(1)
pandas库,含有使数据清洗和分析工作变得更快更简单的数据结构和操作工具。pandas是基于NumPy数组构建。
pandas常结合数值计算工具NumPy和SciPy、分析库statsmodels和scikitlearn,和可视化库matplotlib等工具一同使用。
5.1 pandas数据结构介绍
pandas的主要数据结构:Series和DataFrame
(1)Series
Series是一种类似于一维数组的对象,由一组数据(各种NumPy数据类型)以及一组与之相关的数据标签(即索引)组成:
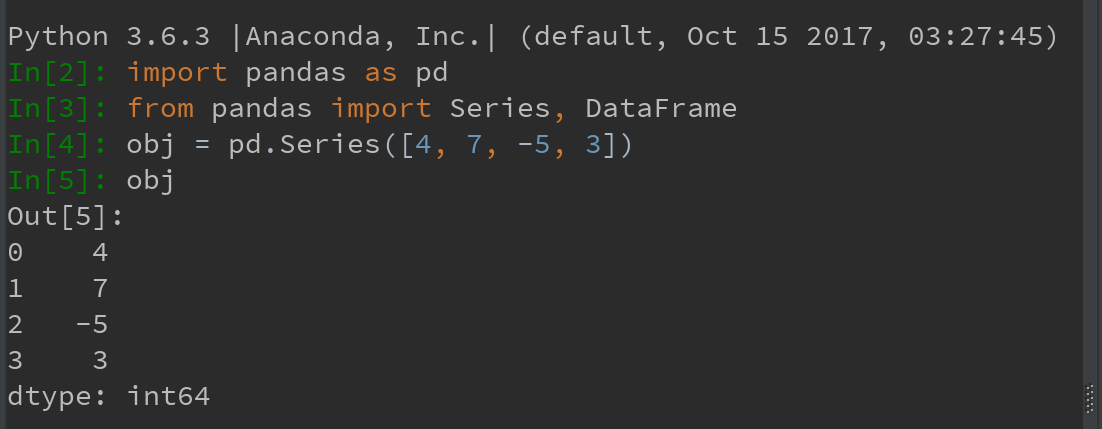
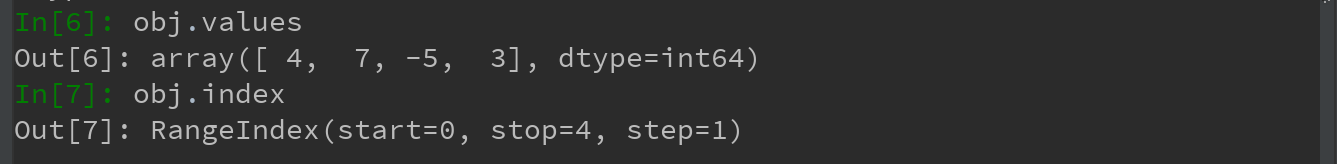
可通过Series的values和index属性获取其数组表示形式和索引对象:
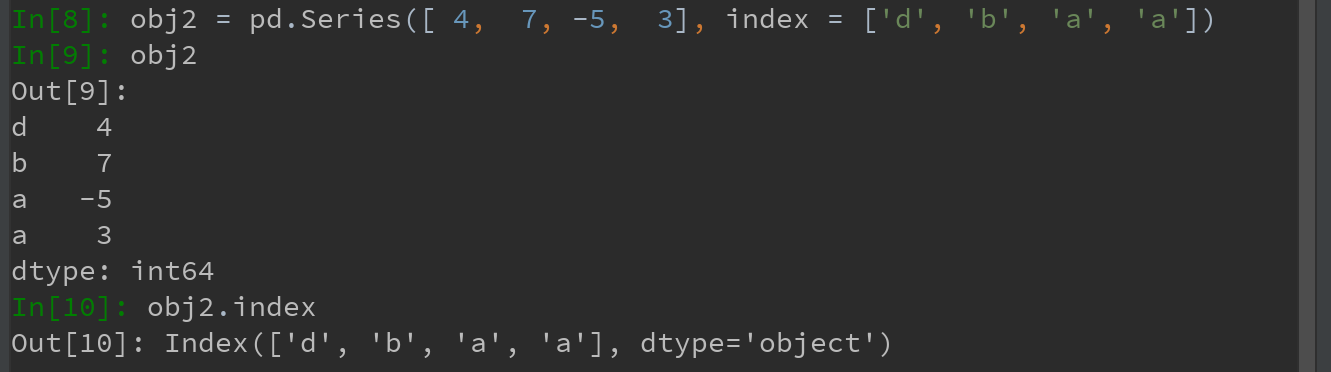
可创建自定义的索引(Series的索引可以通过赋值的方式就地修改):
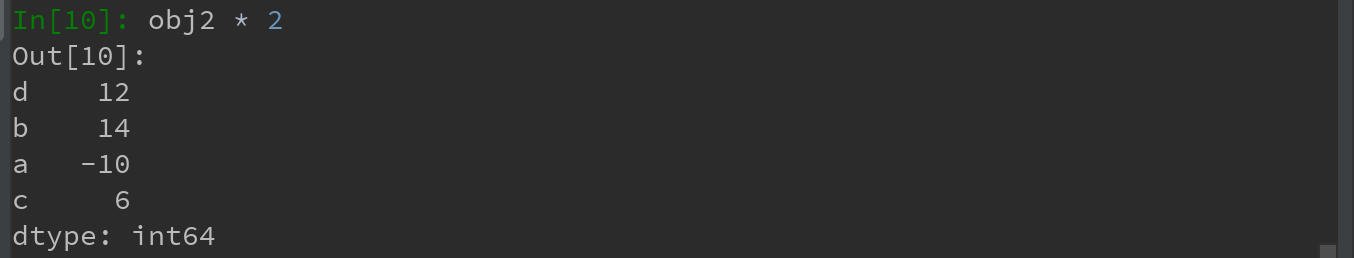
1)与普通NumPy数组相比,可通过索引的方式选取Series中的单个或一组值:

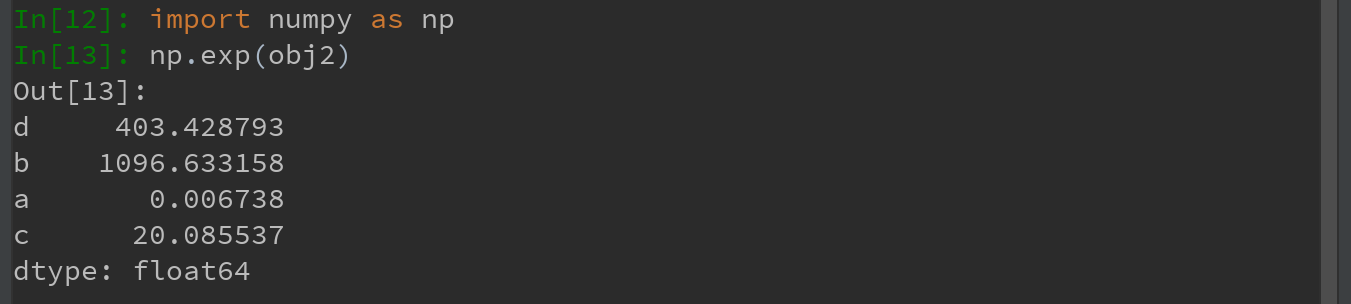
3)还可将Series看成是一个定长的有序字典,因为它是索引值到数据值的一个映射(故它可用在许多原本需要字典参数的函数中):
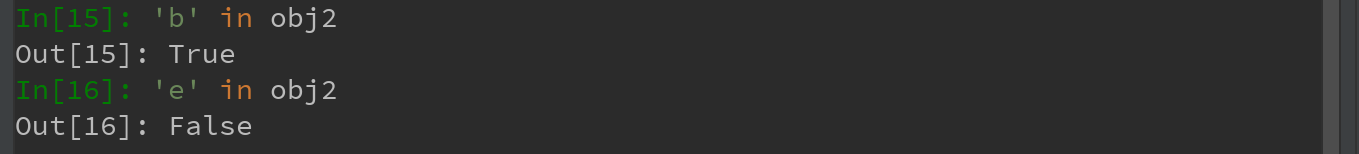
4)若数据被存放在一个Python字典中,也可以直接通过这个字典来创建Series:
如果只传入一个字典,则结果Series中的索引就是原字典的键(有序排列)。
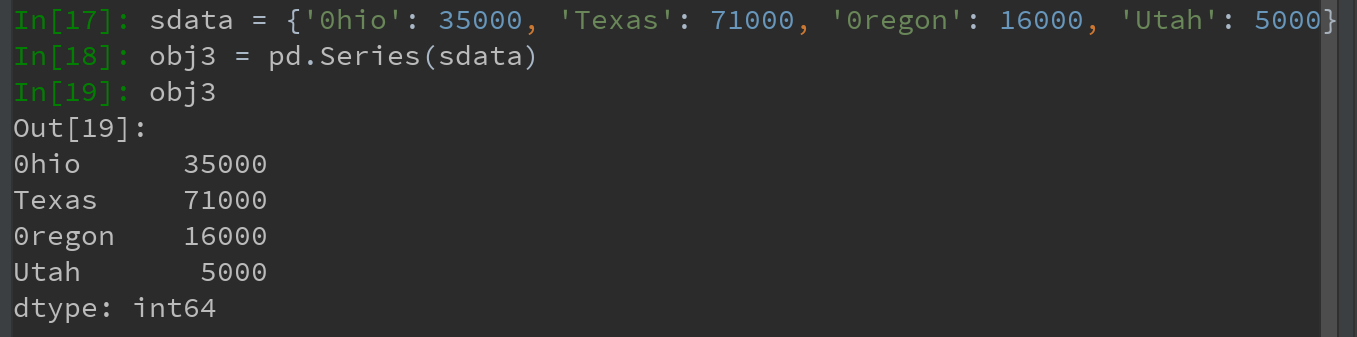
5)可传入排好序的字典的键以改变顺序:
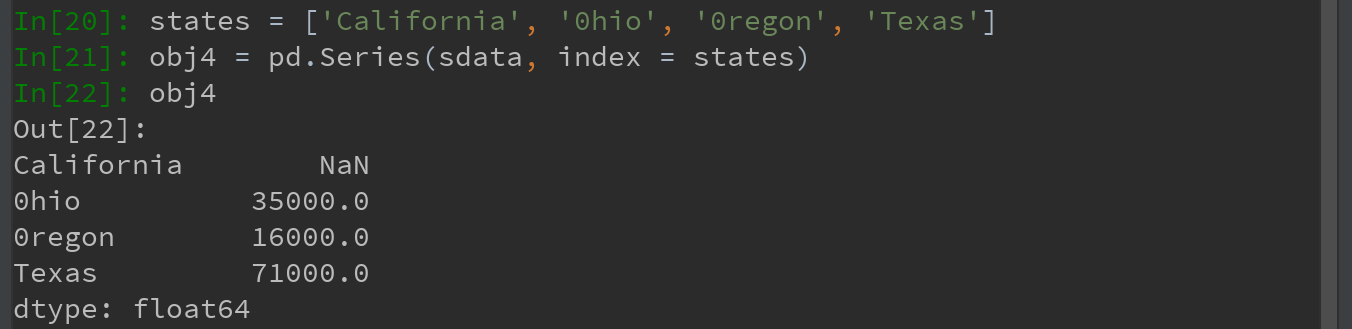
注意:California为新增的州,在sdata中找不到值,故结果为NaN(“非数字”, Not a Number);原sdata中的Utah不在states中,故被从结果中剔除。
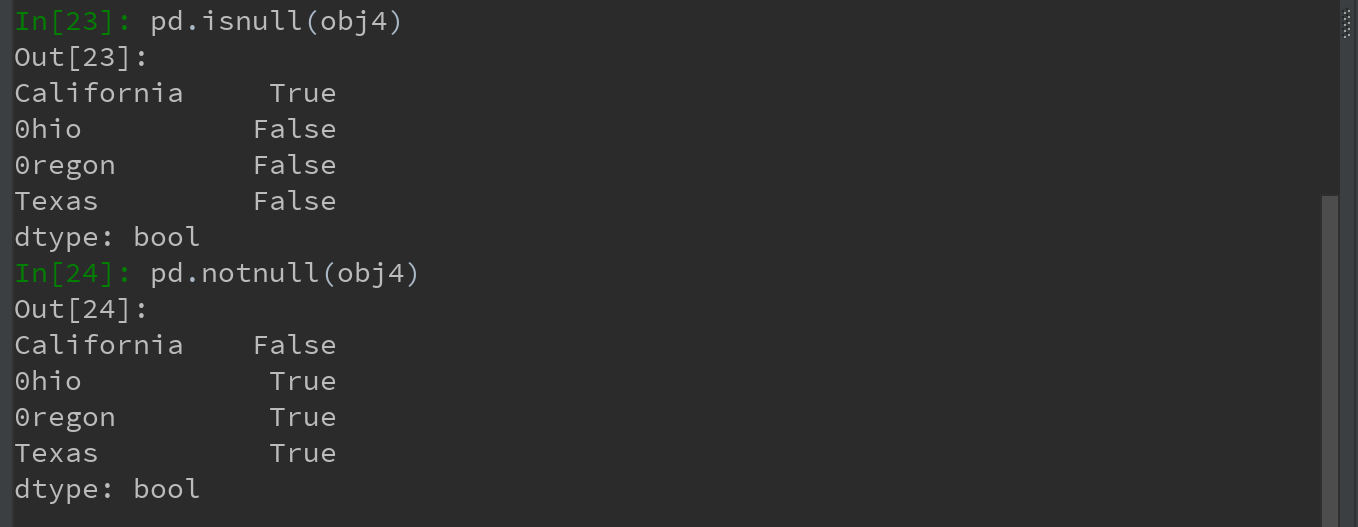
6)pandas用isnull和notnull函数检测缺失数据(Series也有类似的实例方法 .isnull() ):
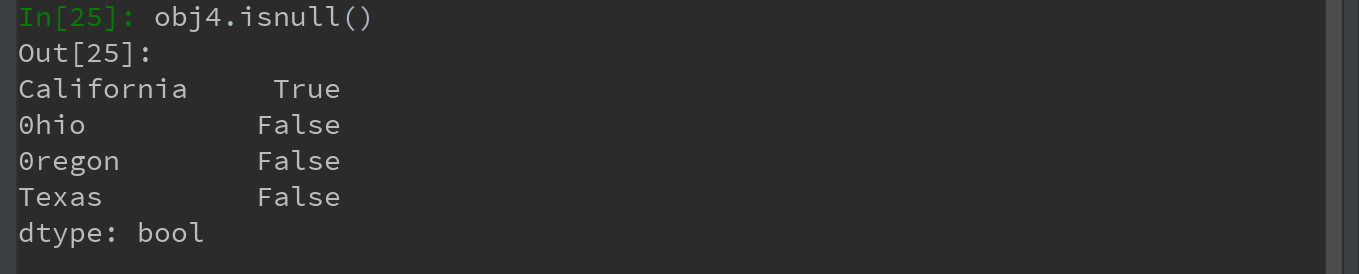
Series类似的实例方法 .isnull() :
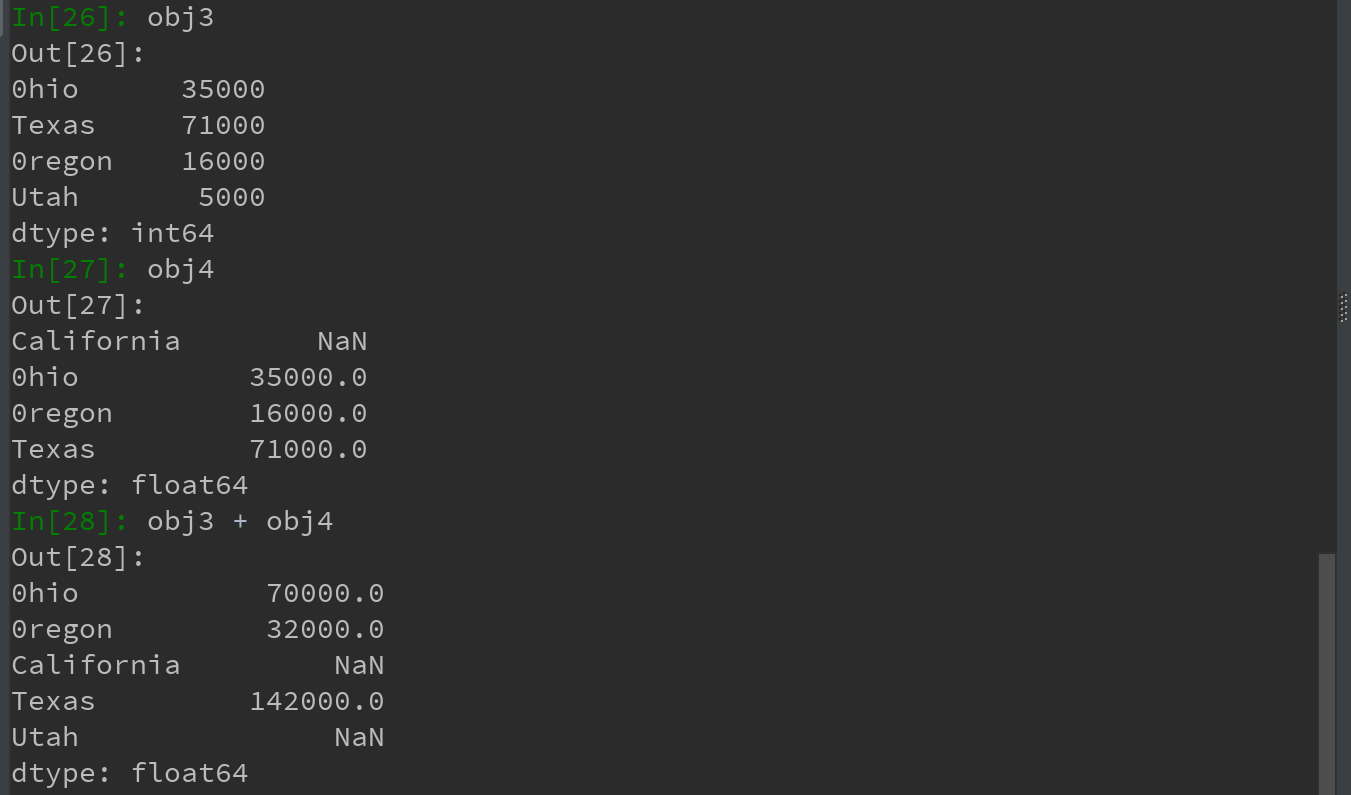
*** 7)Series最重要的一个功能:根据运算的索引标签自动对齐数据!(类似数据库的join操作)
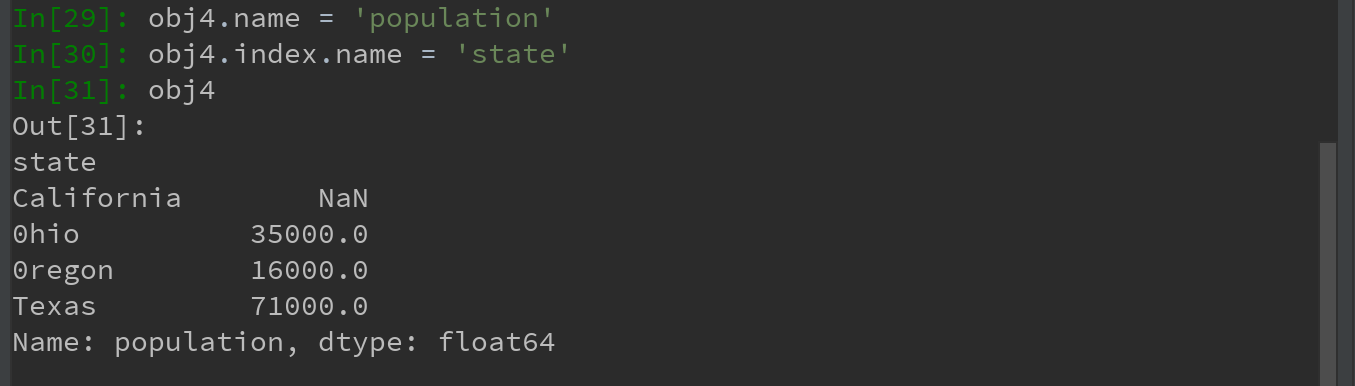
8)Series对象本身及其索引都有一个name属性,该属性跟pandas其他的关键功能关系非常密切:
(2)DataFrame
DataFrame是一个表格型的数据结构,含有一组有序的列,每列可以是不同的值类型(数值、字符串、布尔值等)。
DataFrame既又行索引也有列索引,可以被看做由Series组成的字典(共用同一个索引)。
1.1 )最常用的DataFrame创建方式
直接传入一个由等长列表或NumPy数组组成的字典:
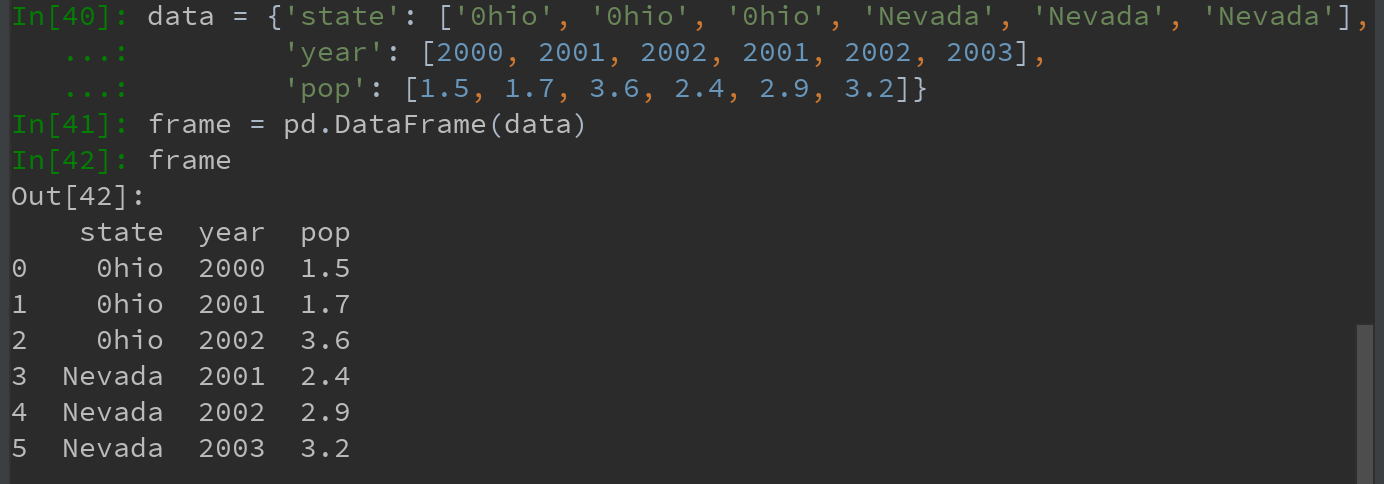
注:结果DataFrame会自动加上索引(跟Series一样),且全部列会被有序排列
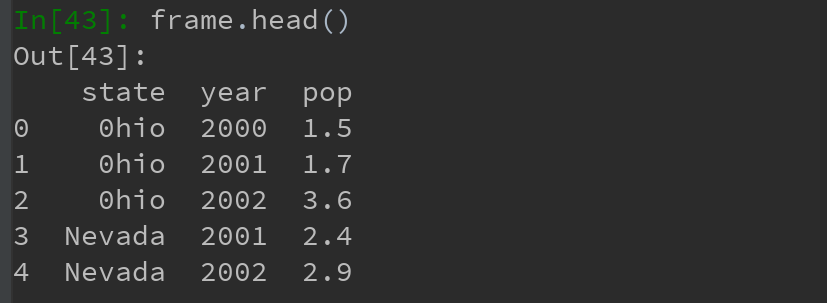
.head() 方法可用于选取前五行:
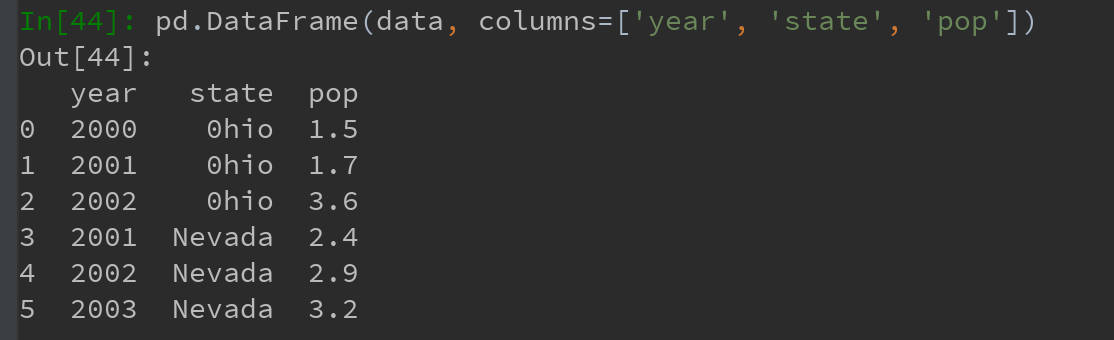
DataFrame可通过指定列序列,对所有列按照指定顺序进行排列:
如果传入的列在数据中找不到,就会在结果中产生缺失值:

1.2 )另一种常见的DataFrame数据创建形式是嵌套字典
用嵌套字典传给DataFrame,pandas会被解释为:外层字典的键作为列,内层键作为行索引

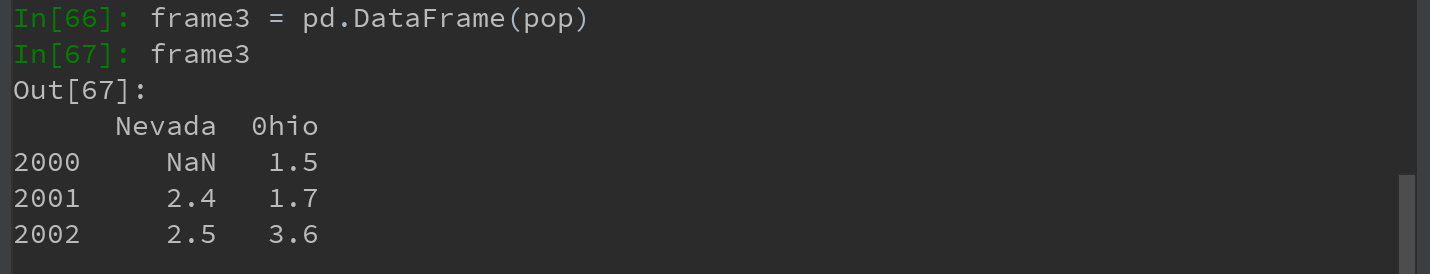
内层字典的键会被合并、排序以形成最终的索引。如果明确指定了索引,则会按指定顺序进行排列:
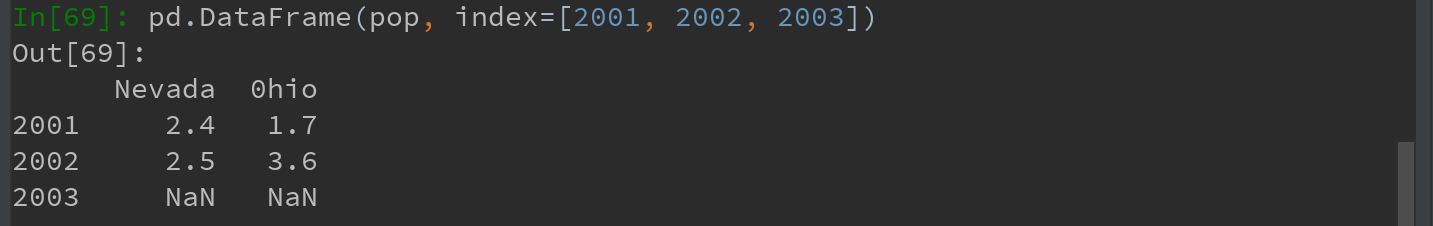
1.3 )由Series组成的字典差不多一样的用法
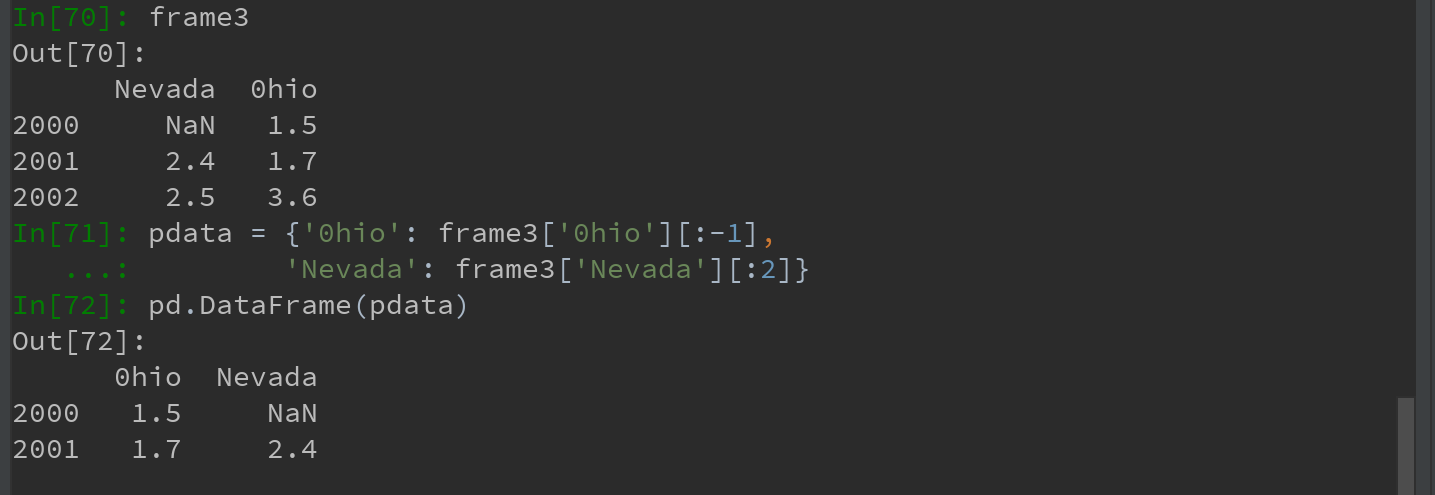
2)将DataFrame的列获取为一个Series
通过类似字典标记的方式:
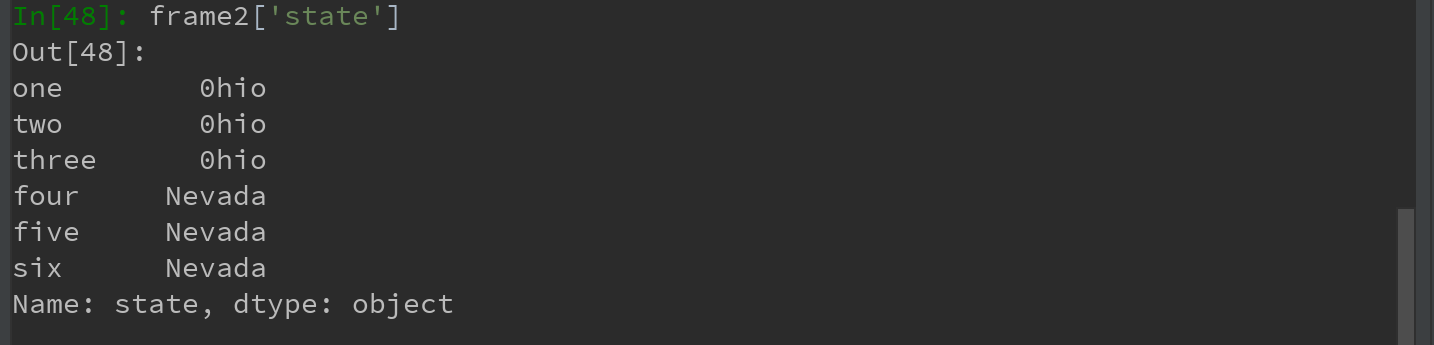
属性访问的方式:
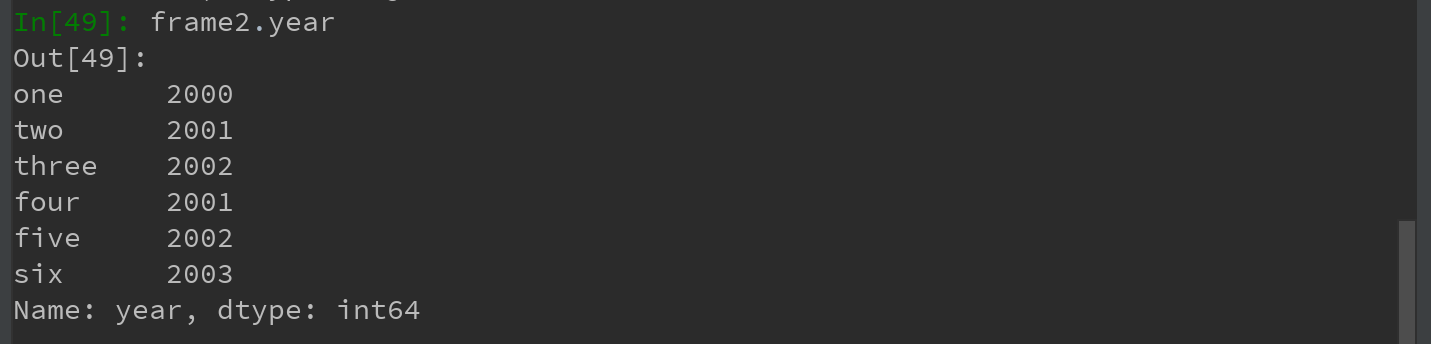
注:返回的Series拥有原DataFrame相同的索引
3)通过位置或名称的方式获取行的Series
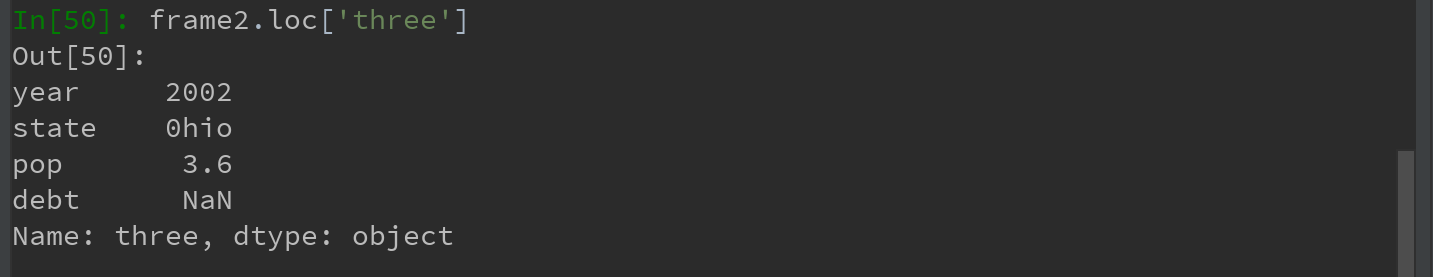
Ps:loc属性详解:???
4)通过赋值的方式,可以对列进行修改
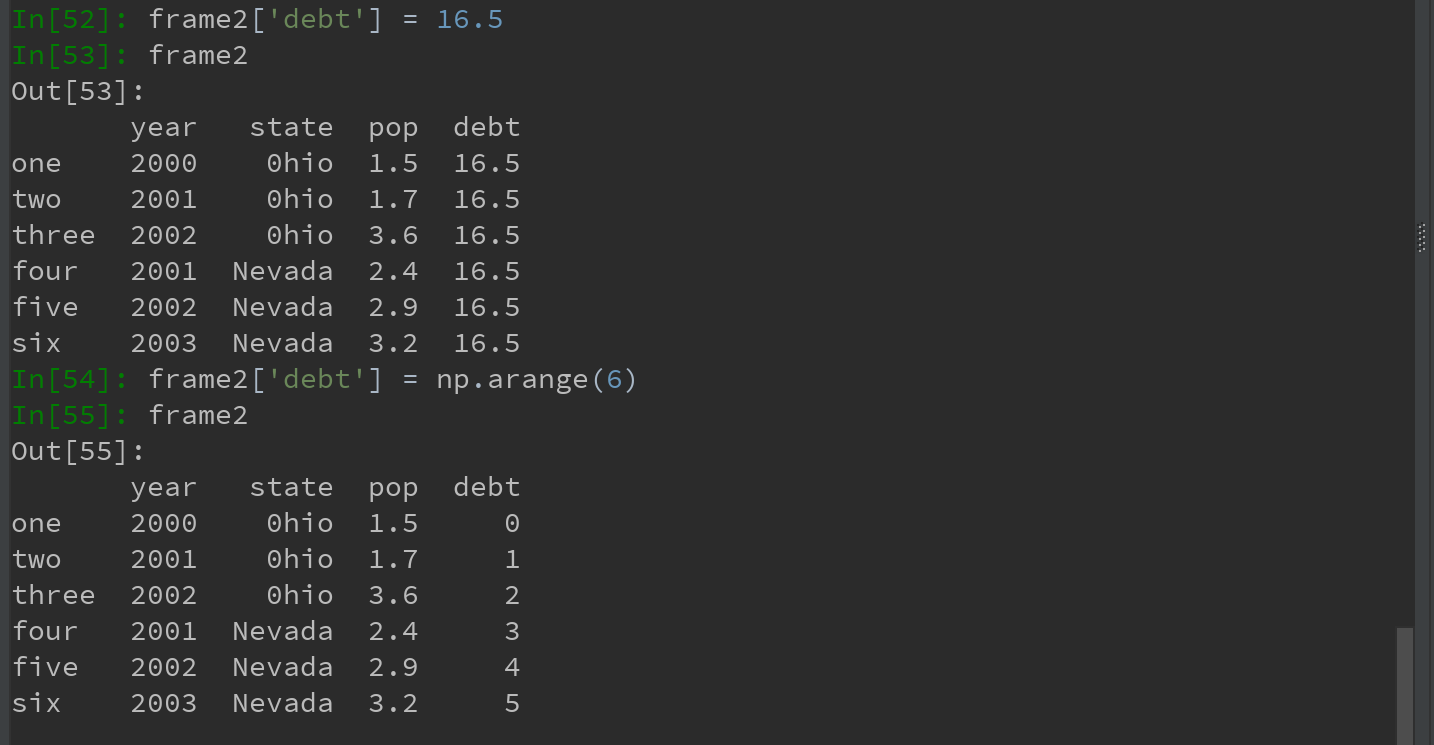
Ps:将列表或数组赋值给某个列时,其长度必须跟DataFrame的长度相匹配。
a)如果赋值的时一个Series,则会精确匹配DataFrame的索引,所有空位都将被填上缺失值:
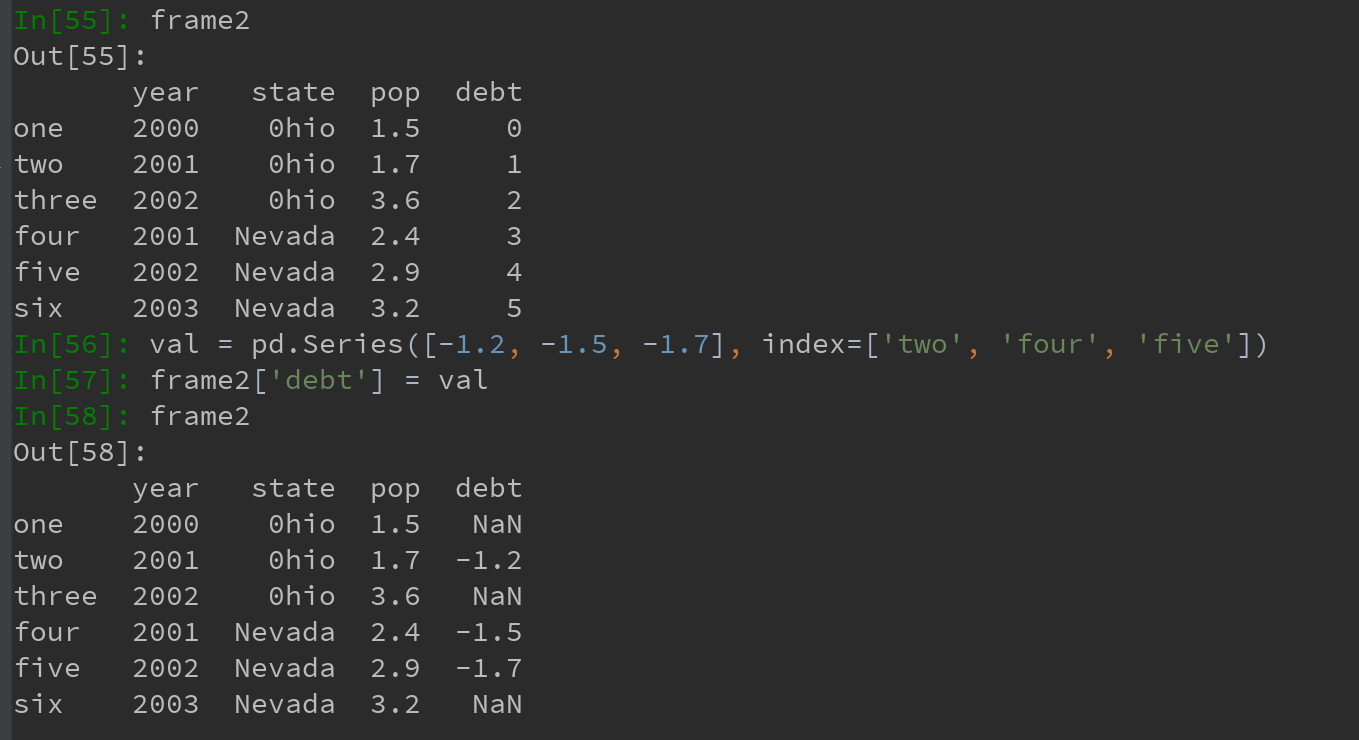
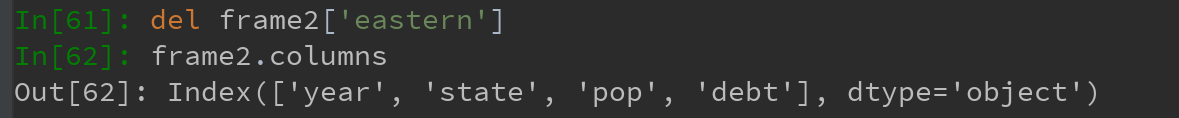
b)为不存在的列赋值,会创建一个新列。关键字del用于删除列
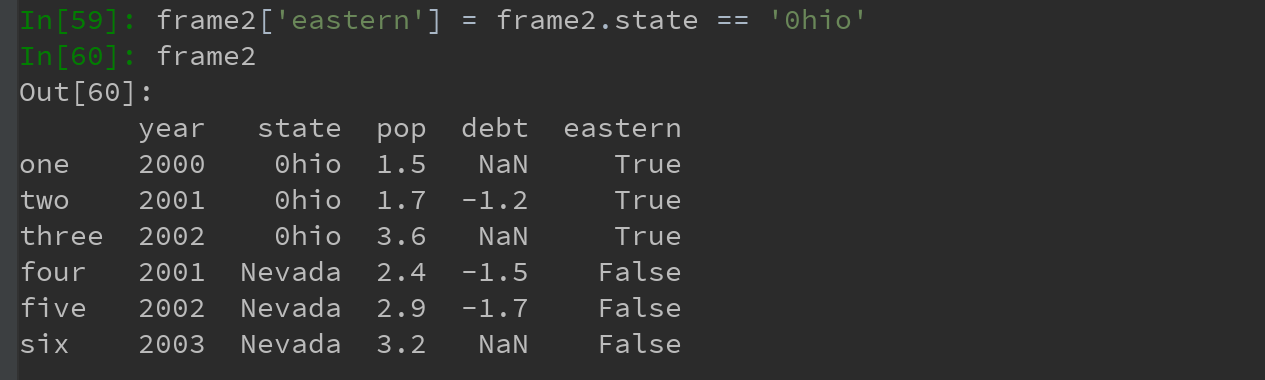
关键字del用于删除列
5)对DataFrame进行转置(交换行和列)
可使用类似NumPy数组的方法 .T:

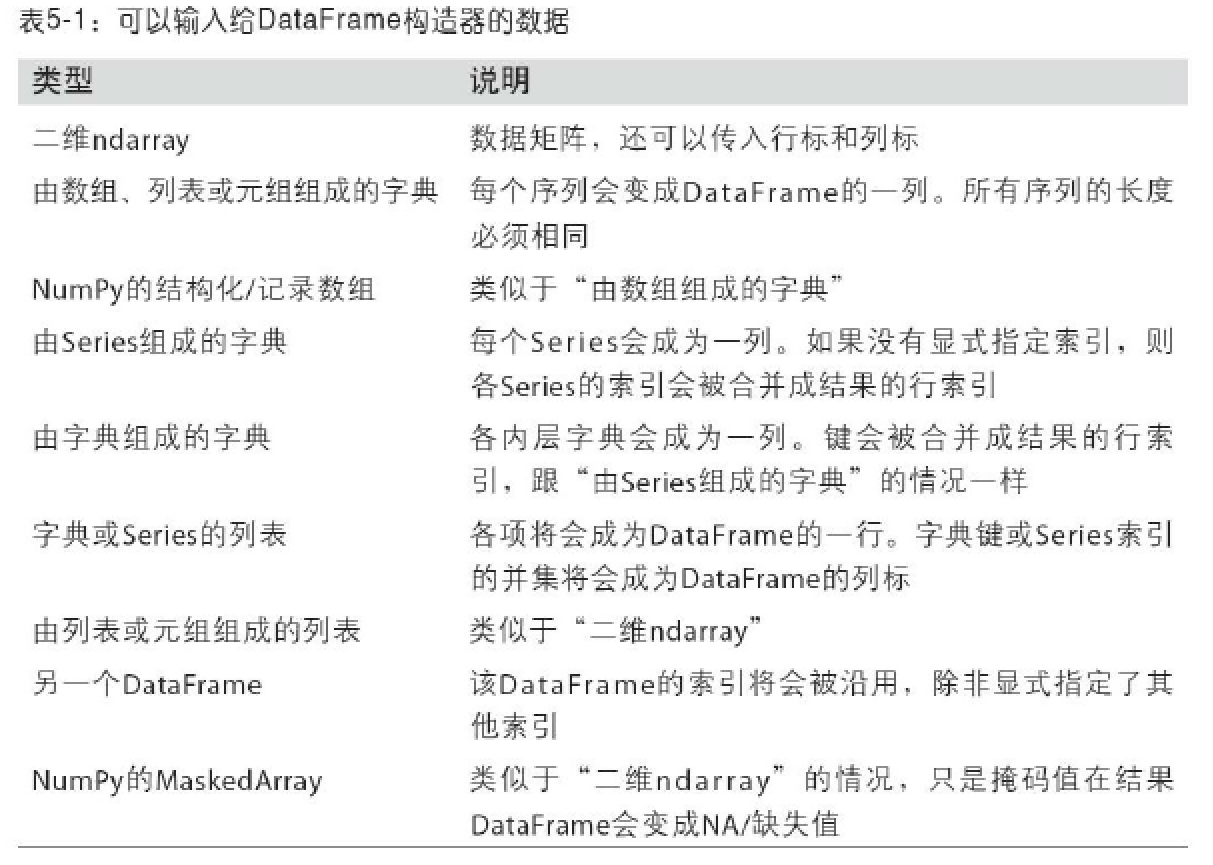
6)DataFrame构造函数所能接受的各种数据
7)设置DataFrame的index和columns的name属性

8)DataFrame的values属性
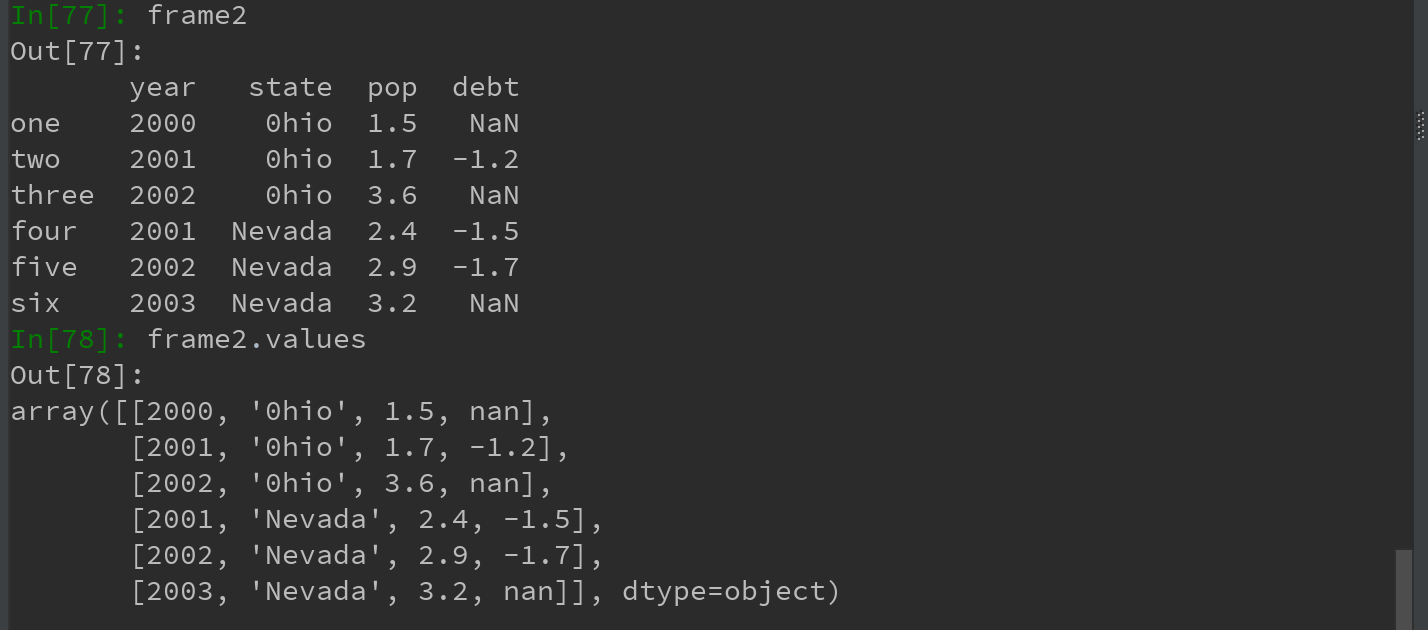
跟Series一样values属性也会以二维nadarray的形式返回DataFrame中的数据:
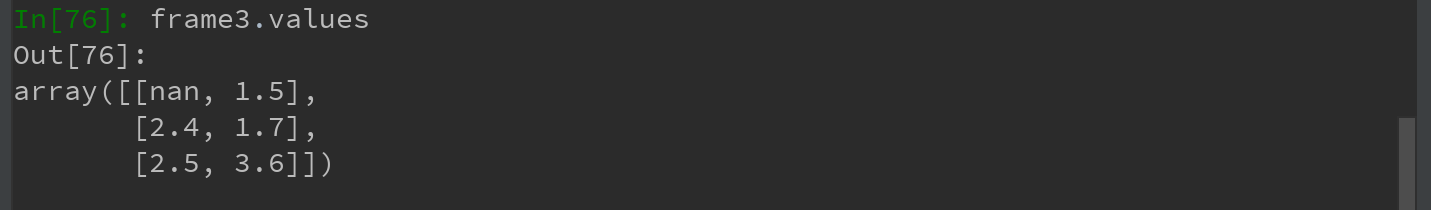
注:如果DataFrame各列的数据类型不同,则值数组的dtype就会选用能兼容所有列的数据类型:
(3)索引对象
pandas的索引对象负责管理轴标签和其他元数据(比如轴名称等)。
构建Series和DataFrame时,所用到的任何数组或其他序列的标签都会被转换成一个Index:
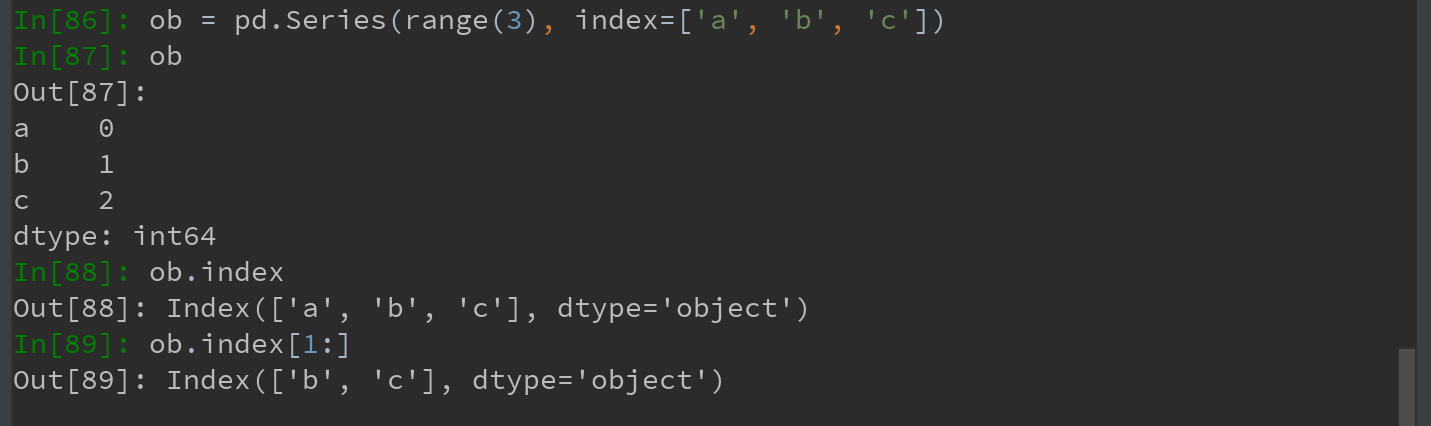
Index对象是不可变的,无法对其进行修改。不可变,可使Index对象在多个数据结构之间安全共享: 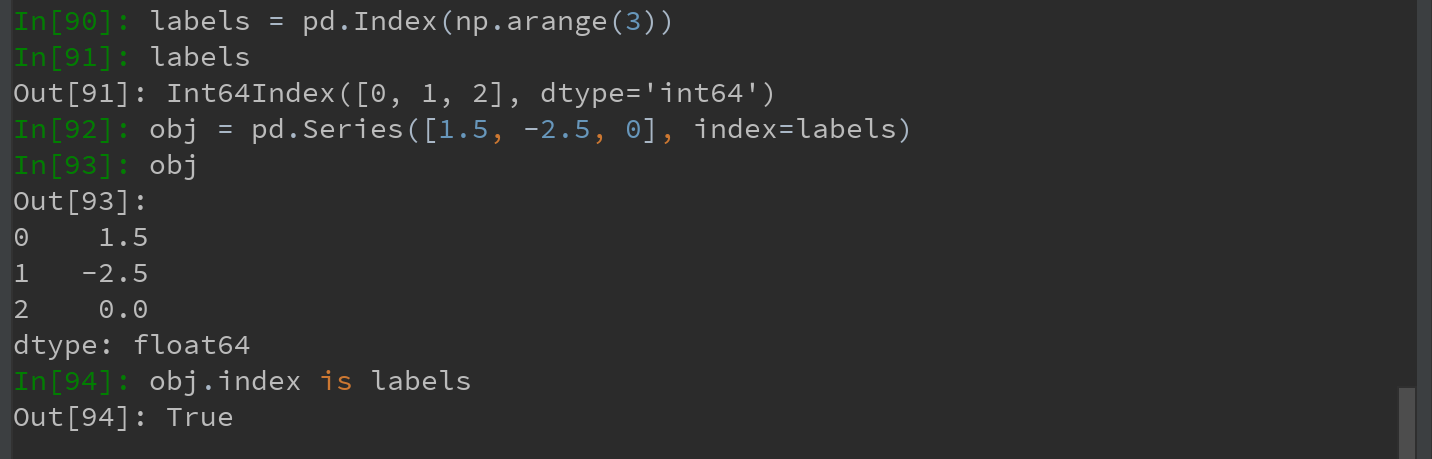
与Python的集合不同,pandas的Index可以包含重复的标签。
Index的方法和属性:

利用Python进行数据分析 第5章 pandas入门(1)的更多相关文章
- 利用Python进行数据分析 第5章 pandas入门(2)
5.2 基本功能 (1)重新索引 - 方法reindex 方法reindex是pandas对象地一个重要方法,其作用是:创建一个新对象,它地数据符合新地索引. 如,对下面的Series数据按新索引进行 ...
- 利用Python进行数据分析 第4章 IPython的安装与使用简述
本篇开始,结合前面所学的Python基础,开始进行实战学习.学习书目为<利用Python进行数据分析>韦斯-麦金尼 著. 之前跳过本书的前述基础部分(因为跟之前所学的<Python基 ...
- 利用Python进行数据分析 第7章 数据清洗和准备(2)
7.3 字符串操作 pandas加强了Python的字符串和文本处理功能,使得能够对整组数据应用字符串表达式和正则表达式,且能够处理烦人的缺失数据. 7.3.1 字符串对象方法 对于许多字符串处理和脚 ...
- 利用Python进行数据分析 第6章 数据加载、存储与文件格式(2)
6.2 二进制数据格式 实现数据的高效二进制格式存储最简单的办法之一,是使用Python内置的pickle序列化. pandas对象都有一个用于将数据以pickle格式保存到磁盘上的to_pickle ...
- 利用Python进行数据分析 第4章 NumPy基础-数组与向量化计算(3)
4.2 通用函数:快速的元素级数组函数 通用函数(即ufunc)是一种对ndarray中的数据执行元素级运算的函数. 1)一元(unary)ufunc,如,sqrt和exp函数 2)二元(unary) ...
- 利用Python进行数据分析 第8章 数据规整:聚合、合并和重塑.md
学习时间:2019/11/03 周日晚上23点半开始,计划1110学完 学习目标:Page218-249,共32页:目标6天学完(按每页20min.每天1小时/每天3页,需10天) 实际反馈:实际XX ...
- 利用Python进行数据分析 第7章 数据清洗和准备(1)
学习时间:2019/10/25 周五晚上22点半开始. 学习目标:Page188-Page217,共30页,目标6天学完,每天5页,预期1029学完. 实际反馈:集中学习1.5小时,学习6页:集中学习 ...
- < 利用Python进行数据分析 - 第2版 > 第五章 pandas入门 读书笔记
<利用Python进行数据分析·第2版>第五章 pandas入门--基础对象.操作.规则 python引用.浅拷贝.深拷贝 / 视图.副本 视图=引用 副本=浅拷贝/深拷贝 浅拷贝/深拷贝 ...
- 《利用python进行数据分析》读书笔记 --第一、二章 准备与例子
http://www.cnblogs.com/batteryhp/p/4868348.html 第一章 准备工作 今天开始码这本书--<利用python进行数据分析>.R和python都得 ...
随机推荐
- JDK8 API文档
API 文档 java SE 8 API 文档 jdk-8-apidocs 在线版 java SE 目录 java SE 6 API文档 Java Platform Standard Edition ...
- Windows使用telnet验证服务端口是否通
使用telnet指令时,Windows需要开启Telnet服务. telnet不通的情况: a.端口对应的服务没启动,或者启动了服务端口不是对应的测试端口. b.端口受限不能访问. 以下内容转自:ht ...
- SQLServer 拼接列
想把表里modified_by和source这两列拼接成一行
- ubuntu下安装ftp服务
1. 安装vsftpd $ sudo apt-get install vsftpd 2. 创建一个用户user-ftp用于ftp服务 $ sudo adduser user-ftp 3.创建一个文件/ ...
- ArrayAdapter和ListView
利用ArrayAdapter向ListView中添加数据 <?xml version="1.0" encoding="utf-8"?> <Li ...
- 基于spark logicplan的表血缘关系解析实现
随着公司平台用户数量与表数量的不断增多,各种表之间的数据流向也变得更加复杂,特别是某个任务中会对源表读取并进行一系列复杂的变换后又生成新的数据表,因此需要一套表血缘关系解析机制能清晰地解析出每个任务所 ...
- pytorch 不使用转置卷积来实现上采样
上采样(upsampling)一般包括2种方式: Resize,如双线性插值直接缩放,类似于图像缩放,概念可见最邻近插值算法和双线性插值算法——图像缩放 Deconvolution,也叫Transpo ...
- 【Mac】解决外接显示器时无法用键盘调节音量
背景:mac book pro 外接一台显示器 可以有音量,音量较小, 外接两台显示器时候直接显示如下了 解决办法: 操作步骤: 从 GitHub 下载 SoundFlower 扩展,并安装.(首次 ...
- Locust-参数化批量注册(还没试,目测试可以的)
前言 实现场景:所有并发虚拟用户共享同一份测试数据,并且保证虚拟用户使用的数据不重复.例如,模拟10用户并发注册账号,总共有100个手机号,要求注册账号不重复,注册完毕后结束测试 准备数据 虚拟用户 ...
- div定位relative和absolute测试2
之前的博文:div定位relative和absolute测试1.中,body包含了蓝色和红色div,蓝色的相对定位,相对于body向下偏移了10px位置,红色绝对定位,相对浏览器偏移了10px位置. ...