
大数据学习——采集文件到HDFS
采集需求:比如业务系统使用log4j生成的日志,日志内容不断增加,需要把追加到日志文件中的数据实时采集到hdfs
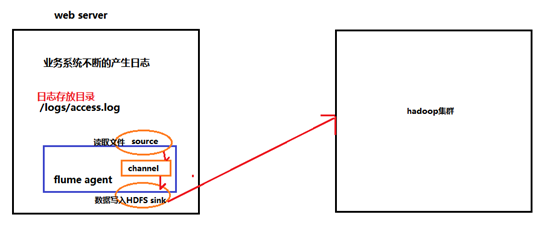
根据需求,首先定义以下3大要素
l 采集源,即source——监控文件内容更新 : exec ‘tail -F file’
l 下沉目标,即sink——HDFS文件系统 : hdfs sink
l Source和sink之间的传递通道——channel,可用file channel 也可以用 内存channel
vi exec-hdfs-sink.conf
agent1.sources = source1

agent1.sinks = sink1

agent1.channels = channel1

# Describe/configure tail -F source1

agent1.sources.source1.type = exec

agent1.sources.source1.command = tail -F /root/logs/access_log

agent1.sources.source1.channels = channel1

#configure host for source

agent1.sources.source1.interceptors = i1 i2

agent1.sources.source1.interceptors.i1.type = host

agent1.sources.source1.interceptors.i1.hostHeader = hostname

#agent1.sources.source1.interceptors.i1.useIP=true 表示使用ip地址或者主机名

agent1.sources.source1.interceptors.i1.useIP=false

agent1.sources.source1.interceptors.i2.type = timestamp

# Describe sink1

agent1.sinks.sink1.type = hdfs

#a1.sinks.k1.channel = c1

agent1.sinks.sink1.hdfs.path=hdfs://mini1:9000/file/%{hostname}/%y-%m-%d/%H-%M

agent1.sinks.sink1.hdfs.filePrefix = access_log

agent1.sinks.sink1.hdfs.batchSize= 100

agent1.sinks.sink1.hdfs.fileType = DataStream

agent1.sinks.sink1.hdfs.writeFormat =Text

agent1.sinks.sink1.hdfs.rollSize = 10240

agent1.sinks.sink1.hdfs.rollCount = 1000
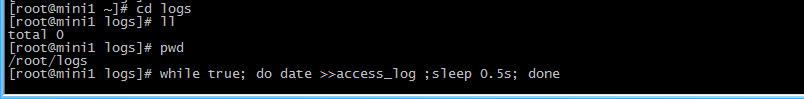
模拟数据
mkdir logs
cd logs
while true; do date >>access_log ;sleep 0.5s; done
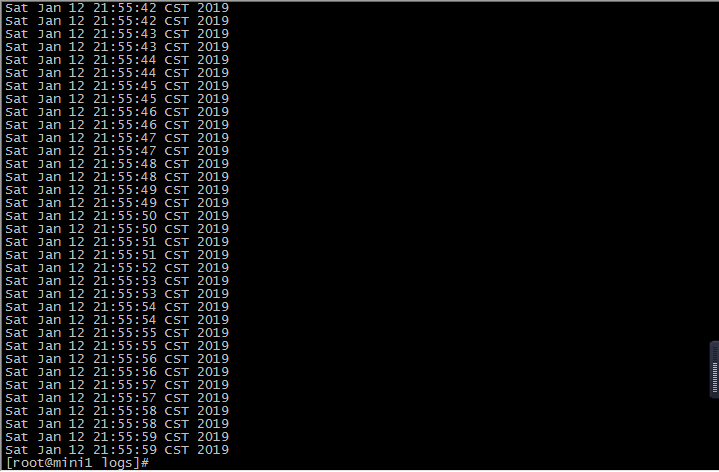
启动
bin/flume-ng agent -c conf -f conf/exec-hdfs-sink.conf -n agent1 -Dflume.root.logger=INFO,console
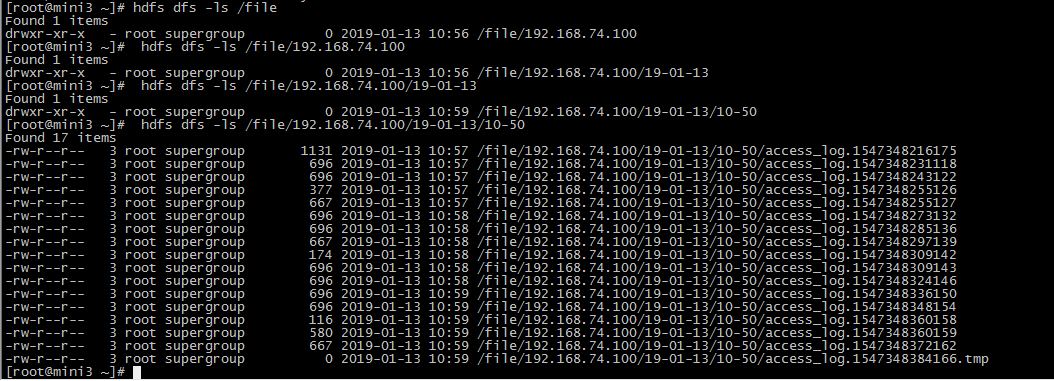
查看结果
大数据学习——采集文件到HDFS的更多相关文章
- 大数据学习——采集目录到HDFS
采集需求:某服务器的某特定目录下,会不断产生新的文件,每当有新文件出现,就需要把文件采集到HDFS中去 根据需求,首先定义以下3大要素 l 采集源,即source——监控文件目录 : spoold ...
- 大数据学习(一)-------- HDFS
需要精通java开发,有一定linux基础. 1.简介 大数据就是对海量数据进行数据挖掘. 已经有了很多框架方便使用,常用的有hadoop,storm,spark,flink等,辅助框架hive,ka ...
- 大数据学习之旅1——HDFS版本演化
最近开始学习大数据,发现大数据有很多很多组件,我现在负责的是HDFS(Hadoop分布式储存系统)的学习,整理了一下HDFS的版本情况.因为HDFS是Hadoop的重要组成部分,所以有关HDFS的版本 ...
- 大数据学习(02)——HDFS入门
Hadoop模块 提到大数据,Hadoop是一个绕不开的话题,我们来看看Hadoop本身包含哪些模块. Common是基础模块,这个是必须用的.剩下常用的就是HDFS和YARN. MapReduce现 ...
- 大数据学习第二章、HDFS相关概念
1.HDFS核心概念: 块 (1)为了分摊磁盘读写开销也就是大量数据间分摊磁盘寻址开销 (2)HDFS块比普通的文件块大很多,HDFS默认块大小为64MB,普通的只有几千kb 原因:1.支持面向大规模 ...
- 大数据学习(03)——HDFS的高可用
高可用架构图 先上一张搜索来的图. 如上图,HDFS的高可用其实就是NameNode的高可用. 上一篇里,SecondaryNameNode是NameNode单节点部署才会有的角色,它只帮助NameN ...
- 大数据学习(2)HDFS文件管理
命令行管理HDFS [root@server1 bin]# hadoop fs Usage: hadoop fs [generic options] [-appendToFile <locals ...
- 大数据学习笔记——Hadoop编程实战之HDFS
HDFS基本API的应用(包含IDEA的基本设置) 在上一篇博客中,本人详细地整理了如何从0搭建一个HA模式下的分布式Hadoop平台,那么,在上一篇的基础上,我们终于可以进行编程实操了,同样,在编程 ...
- 大数据学习系列之四 ----- Hadoop+Hive环境搭建图文详解(单机)
引言 在大数据学习系列之一 ----- Hadoop环境搭建(单机) 成功的搭建了Hadoop的环境,在大数据学习系列之二 ----- HBase环境搭建(单机)成功搭建了HBase的环境以及相关使用 ...
随机推荐
- 1-10super和this关键字
什么是super? super代表的是当前子类对象中的父类型特征. 什么时候使用super? 子类和父类中都有某个数据,例如,子类和父类中都有name这个属性.如果要再子类中访问父类中的name属性, ...
- (027)[技术资料]业余制作Windows图标
这几天一直在纠结一件事,想给软件制作一个简单的图标,以前(2014-10-4 11:00)制作的是下面这个,多重ICO,最大尺寸256,无压缩(windows允许图标尺寸在大于256时按PNG方式进行 ...
- PoolManager插件(转载)
http://www.xuanyusong.com/archives/2974 前几天我在博客里面分享了为什么Unity实例化很慢的原因,并且也分享了一个缓存池的工具.有朋友给我留言说PoolMana ...
- poj2112Optimal Milking(二分+最大流)
链接 floyd求出牛到机器的最短距离,二分距离,小于当前距离的边容量设为1,求出满容量下的最短距离. EK算法 #include <iostream> #include<cstdi ...
- LN : leetcode 416 Partition Equal Subset Sum
lc 416 Partition Equal Subset Sum 416 Partition Equal Subset Sum Given a non-empty array containing ...
- jdbc获取数据具体过程
下面是个最简单的使用jdbc取得数据的应用.在例子之后我将分成4步,分别是①取得连接,②创建PreparedStatement,③设置参数,④执行查询,来分步分析这个过程.除了设置参数那一步之外,其他 ...
- ML-学习提纲1
http://www.sohu.com/a/130379077_468714 本文用一系列「思维导图」由浅入深的总结了「统计学」领域的基础知识,是对之前系列文章做的一次完整的梳理,也是我至今为止所有与 ...
- C++#pragma pack指令
微软官方文档说#pragma pack 指令的作用是为结构.联合和类成员指定 pack 对齐.的主要作用就是改变编译器的内存对齐方式,这个指令在网络报文的处理中有着重要的作用,#pragma pack ...
- SVM-支持向量机 学习 1
参考 https://zhuanlan.zhihu.com/p/42334376 https://blog.csdn.net/liugan528/article/details/79448379 ht ...
- slides 在线ppt && React && Angular
现在主流前端框架 有3个 Vue React Angular 如果有时间就都学习,理解一下他们的差异性~ 在线ppt的一个网站 这个是npm讲解的,不错 https://slides.com/seld ...