
简易数据分析 12 | Web Scraper 翻页——抓取分页器翻页的网页
这是简易数据分析系列的第 12 篇文章。
前面几篇文章我们介绍了 Web Scraper 应对各种翻页的解决方法,比如说修改网页链接加载数据、点击“更多按钮“加载数据和下拉自动加载数据。今天我们说说一种更常见的翻页类型——分页器。
本来想解释一下啥叫分页器,翻了一堆定义觉得很繁琐,大家也不是第一年上网了,看张图就知道了。我找了个功能最全的例子,支持数字页码调整,上一页下一页和指定页数跳转。

今天我们就学学,Web Scraper 怎么对付这种类型的网页翻页。
其实我们在本教程的第一个例子,抓取豆瓣电影 TOP 排行榜中,豆瓣的这个电影榜单就是用分页器分割数据的:

但当时我们是找网页链接规律抓取的,没有利用分页器去抓取。因为当一个网页的链接变化规律时,控制链接参数抓取是实现成本最低的;如果这个网页进可以翻页,但是链接的变化不是规律的,就得去会一会这个分页器了。
说这些理论有些枯燥,我们举个翻页链接不规律的例子。
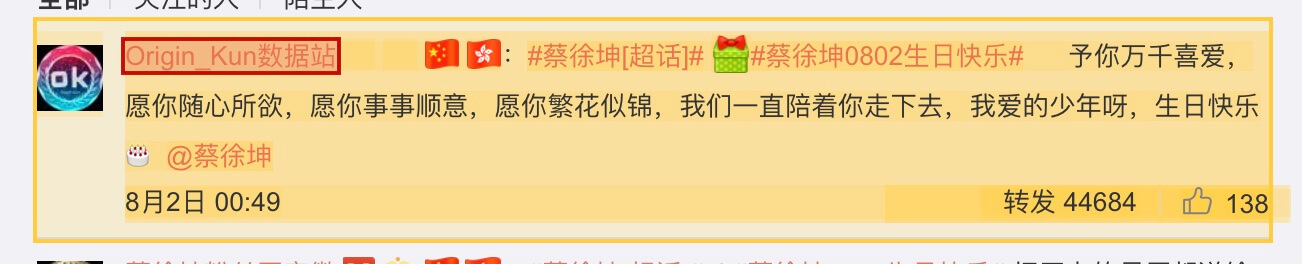
8 月 2 日是蔡徐坤的生日,为了表达庆祝,在微博上粉丝们给坤坤刷了 300W 的转发量,微博的转发数据正好是用分页器分割的,我们就分析一下微博的转发信息页面,看看这类数据怎么用 Web Scraper 抓取。
这条微博的直达链接是:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost
看了他那么多的视频,为了表达感激,我们可以点进去出为坤坤加一份阅读量。
首先我们看看第 1 页转发的链接,长这个样子:
第 2 页长这个样子,注意到多了个 #_rnd1568563840036 参数:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost#_rnd1568563840036
第 3 页参数为 #_rnd1568563861839
https://weibo.com/1776448504/I0gyT8aeQ?type=repost#_rnd1568563861839
第 4 页参数为 #_rnd1568563882276:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost#_rnd1568563882276
多看几个链接你就可以发现,这个转发网页的网址毫无规律可言,所以只能通过分页器去翻页加载数据。下面就开始我们的实战教学环节。
1.创建 SiteMap
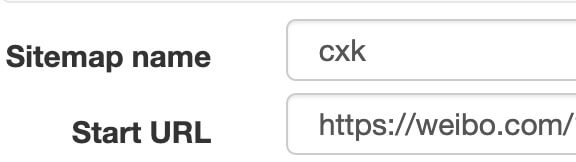
我们首先创建一个 SiteMap,这次取名为 cxk,起始链接为 https://weibo.com/1776448504/I0gyT8aeQ?type=repost。
2.创建容器的 selector
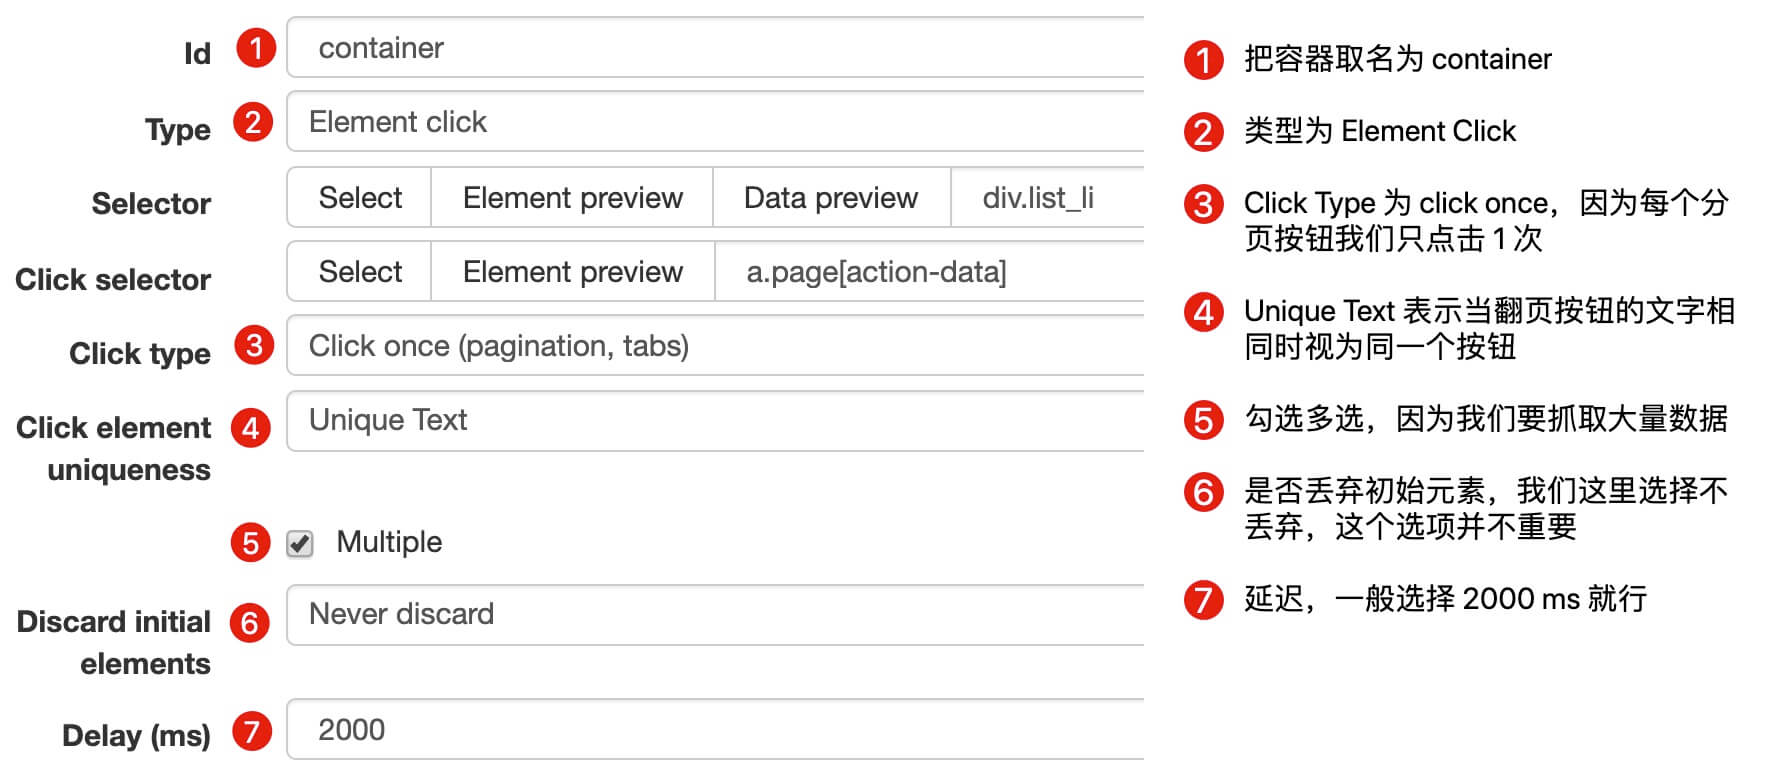
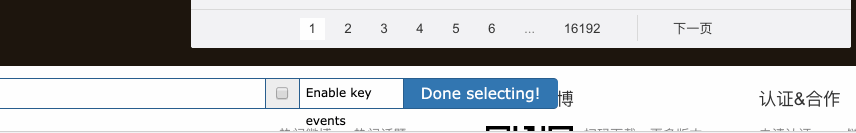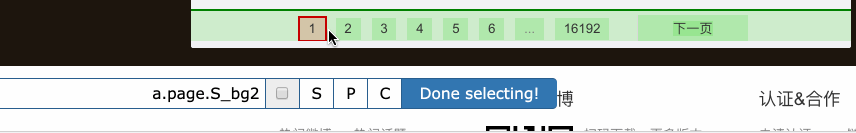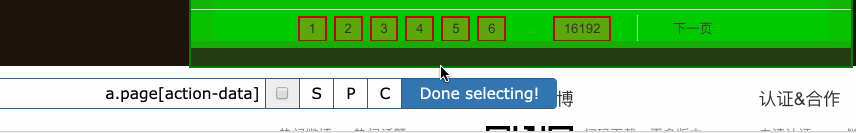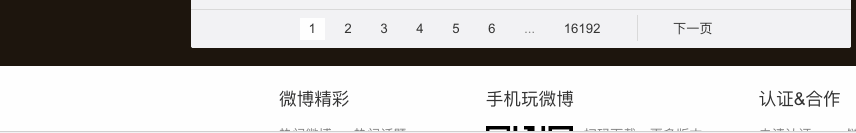
因为我们要点击分页器,外面的容器的类型我们选为 Element Click,具体的参数解释可以看下图,我们之前在简易数据分析 08详细解释过一次,这里就不多言了。
container 的预览是下图的样子:
分页器选择的过程可以参看下图:
3.创建子选择器
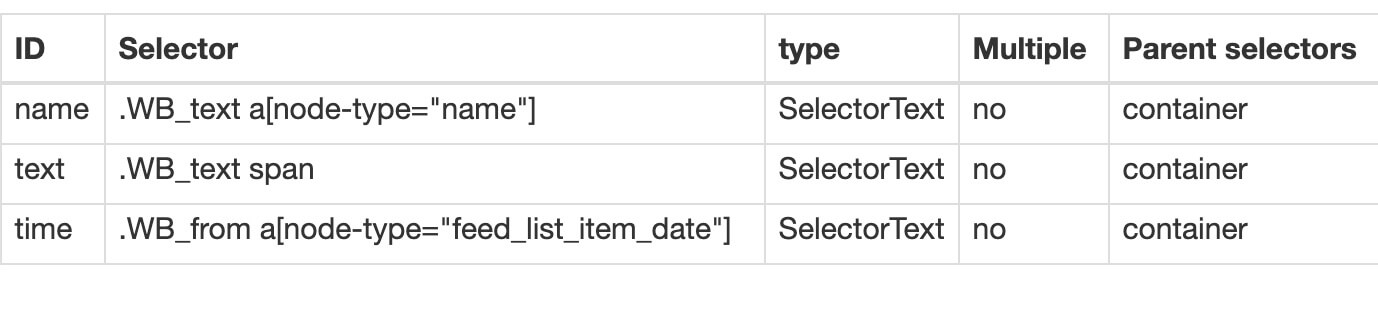
这几个子选择器都比较简单,类型都是文字选择器,我们选择了评论用户名,评论内容和评论时间三种类型的内容。
4.抓取数据
按照 Sitemap cxk -> Scrape 的操作路径就可以抓取数据了。
5.一些问题
如果你看了我上面的教程立马去爬数据,可能遇到的第一个问题就是,300w 的数据,难道我全部爬下来吗?
听上去也不太现实,毕竟 Web Scraper 针对的数据量都是相对比较小的,几万数据都算多的了,数据再大你就得考虑爬取时间是否太长,数据如何存储,如何应对网址的反爬虫系统(比如说冷不丁的跳出一个验证码,这个 Web Scraper 是无能为力的)。
考虑到这个问题,前面的自动控制抓取数量的教程你又看过的话,可能想着用 :nth-of-type(-n+N) 控制抓取 N 条数据。如果你尝试了,就会发现这个方法根本没用。
失效的原因其实涉及到一点点网页的知识了,感兴趣的话可以看看下面的解释,不感兴趣可以直接看最后的结论。
像我前面介绍的点击更多加载型网页和下拉加载型网页,他们新加载的数据,是在当前页面追加的,你一直下拉,数据一直加载,同时网页的滚动条会越来越短,这意味着所有的数据都在同一个页面。
当我们用 :nth-of-type(-n+N) 控制加载数量时,其实相当于在这个网页设立一个计数器,当数据一直累加到我们想要的数量时,就会停止抓取。
但是对于使用翻页器的网页,每次的翻页相当于刷新当前网页,这样每次都会设立一个计数器。
比如说你想抓取 1000 条数据,但是第 1 页网页只有 20 条数据,抓到最后一条了,还差 980 条;然后一翻页,又设立一个新的计数器,抓完第 2 页的最后一条数据,还差 980,一翻页计数器就重置,又变成 1000 了......所以这个控制数量的方法就失效了。
所以结论就是,如果翻页器类型的网页想提前结束抓取,只有断网的这种方法。当然,如果你有更好的方案,可以在评论里回复我,我们可以互相讨论一下。
6.总结
分页器是一种很常见的网页分页方法,我们可以通过 Web Scraper 中的 Element click 处理这种类型的网页,并通过断网的方法结束抓取。
7.推荐阅读
简易数据分析 05 | Web Scraper 翻页——控制链接批量抓取数据
简易数据分析 08 | Web Scraper 翻页——点击「更多按钮」翻页
简易数据分析 10 | Web Scraper 翻页——抓取「滚动加载」类型网页
简易数据分析 09 | Web Scraper 自动控制抓取数量 & Web Scraper 父子选择器
简易数据分析 12 | Web Scraper 翻页——抓取分页器翻页的网页的更多相关文章
- 简易数据分析 04 | Web Scraper 初尝--抓取豆瓣高分电影
这是简易数据分析系列的第 4 篇文章. 今天我们开始数据抓取的第一课,完成我们的第一个爬虫.因为是刚刚开始,操作我会讲的非常详细,可能会有些啰嗦,希望各位不要嫌弃啊:) 有人之前可能学过一些爬虫知识, ...
- 简易数据分析 08 | Web Scraper 翻页——点击「更多按钮」翻页
这是简易数据分析系列的第 8 篇文章. 我们在Web Scraper 翻页--控制链接批量抓取数据一文中,介绍了控制网页链接批量抓取数据的办法. 但是你在预览一些网站时,会发现随着网页的下拉,你需要点 ...
- 简易数据分析 07 | Web Scraper 抓取多条内容
这是简易数据分析系列的第 7 篇文章. 在第 4 篇文章里,我讲解了如何抓取单个网页里的单类信息: 在第 5 篇文章里,我讲解了如何抓取多个网页里的单类信息: 今天我们要讲的是,如何抓取多个网页里的多 ...
- 简易数据分析 13 | Web Scraper 抓取二级页面
这是简易数据分析系列的第 13 篇文章. 不知不觉,web scraper 系列教程我已经写了 10 篇了,这 10 篇内容,基本上覆盖了 Web Scraper 大部分功能.今天的内容算这个系列的最 ...
- 简易数据分析 10 | Web Scraper 翻页——抓取「滚动加载」类型网页
这是简易数据分析系列的第 10 篇文章. 友情提示:这一篇文章的内容较多,信息量比较大,希望大家学习的时候多看几遍. 我们在刷朋友圈刷微博的时候,总会强调一个『刷』字,因为看动态的时候,当把内容拉到屏 ...
- 简易数据分析 09 | Web Scraper 自动控制抓取数量 & Web Scraper 父子选择器
这是简易数据分析系列的第 9 篇文章. 今天我们说说 Web Scraper 的一些小功能:自动控制 Web Scraper 抓取数量和 Web Scraper 的父子选择器. 如何只抓取前 100 ...
- 简易数据分析 11 | Web Scraper 抓取表格数据
这是简易数据分析系列的第 11 篇文章. 今天我们讲讲如何抓取网页表格里的数据.首先我们分析一下,网页里的经典表格是怎么构成的. First Name 所在的行比较特殊,是一个表格的表头,表示信息分类 ...
- Web Scraper 高级用法——抓取属性信息 | 简易数据分析 16
这是简易数据分析系列的第 16 篇文章. 这期课程我们讲一个用的较少的 Web Scraper 功能--抓取属性信息. 网页在展示信息的时候,除了我们看到的内容,其实还有很多隐藏的信息.我们拿豆瓣电影 ...
- 简易数据分析 15 | Web Scraper 高级用法——CSS 选择器的使用
这是简易数据分析系列的第 15 篇文章. 年末事情比较忙,很久不更新了,后台一直有读者催更,我看了一些读者给我的私信,发现一些通用的问题,所以单独写篇文章,介绍一些 Web Scraper 的进阶用法 ...
随机推荐
- 对平底锅和垃圾的O奖论文的整理和学习[2](2018-02-08发布于知乎)
其实这篇论文看了一段时间,愣是没看出来这个模型怎么建立的.虽然看不懂,但是有一些部分还是很喜欢. 首先是摘要: 摘要分为八段 第一段:背景引入,太空垃圾的问题日益严重. 第二段:本文工作,包括基本的i ...
- scrapy xpath用法
一.实验环境 1.Windows7x64_SP1 2.anaconda3 + python3.7.3(anaconda集成,不需单独安装) 3.scrapy1.6.0 二.用法举例 1.开启scrap ...
- LCA最近公共祖先---倍增法笔记
先暂时把模板写出来,A几道题再来补充 此模板也是洛谷上的一道模板题 P3379 [模板]最近公共祖先(LCA) #pragma GCC optimize(2) //o2优化 #include < ...
- 性能测试学习第五天-----Jmeter测试脚本&基础元件使用
JMeter简介:一个100%的纯Java桌面应用,由Apache组织的开放源代码项目,它是功能和性能测试的工具.具有高可扩展性.支持Web(HTTP/HTTPS).SOAP.FTP.JAVA等多种协 ...
- 通过 Channel 实现 Goroutine Pool
最近用到了 Go 从 Excel 导数据到服务器内部 用的是 http 请求 但是发现一个问题 从文件读取之后 新开 Goroutine 会无限制新增 导致全部卡在初始化请求 于是乎就卡死了 问题模拟 ...
- NDK Cmake
CMake与NDK搭配使用时,可以配置的部分变量: 1. `ANDROID_PLATFORM`:指定Android的目标版本,对应`$NDK/platforms/`目录下的版本.通常情况下是`defa ...
- 深入浅出TypeScript(1)
前言 在学习TypeScript过程中,我也是遇到了很多的阻力,因为并未有太多深入挖掘的场景,之前做IONIC的时候,也只是用TS,现如今,这一个系列也是记录自己学习和收获,同时希望自己的这系列教程对 ...
- 使用 Docker Compose 快速构建 TiDB 集群
本文档介绍如何在单机上通过 Docker Compose 快速一键部署一套 TiDB 测试集群.Docker Compose 可以通过一个 YAML 文件定义多个容器的应用服务,然后一键启动或停止. ...
- 配置Office Excel运行Python宏脚本
基本环境 名称 版本 操作系统 Windows 10 x64 Office 2016 安装Python 1.下载Python安装包 登录https://www.python.org/downloads ...
- Delphi - 通过WinAPI WinExec直接调用系统工具
看如下代码: WinExec('mspaint.exe', SW_SHOWNORMAL); // SW_SHOWNORMAL = 1 系统画图 WinExec('write.exe', SW_SHOW ...