
pyspider爬虫框架webui简介-爬取阿里招聘信息
命令行输入pyspider开启pyspider

浏览器打开http://localhost:5000/
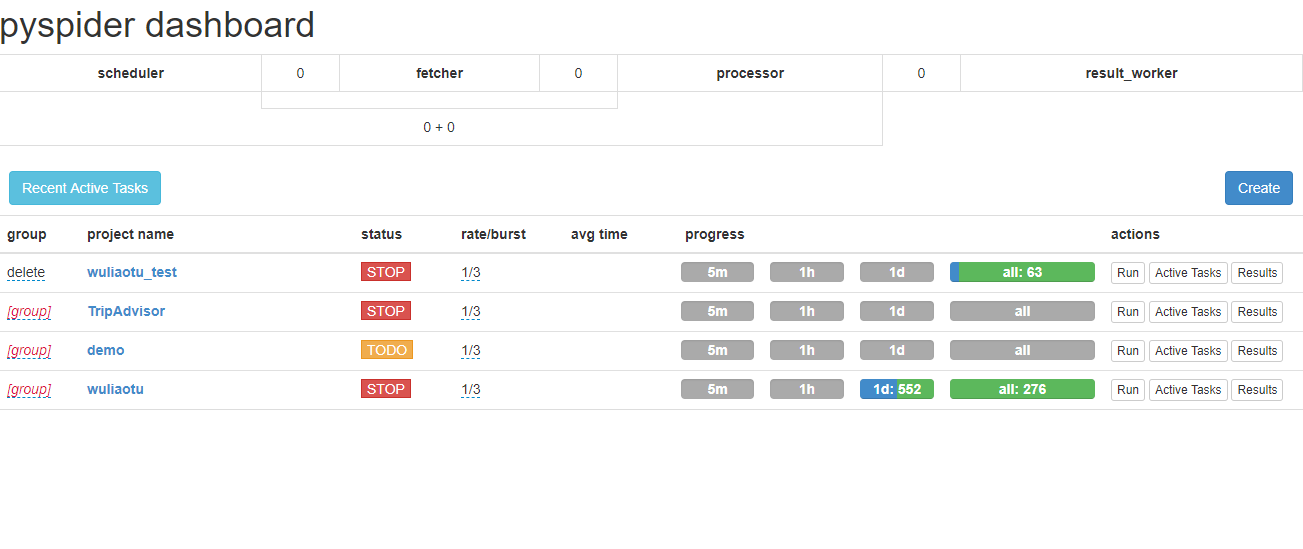
group表示组名,几个项目可以同一个组名,方便管理,当组名修改为delete时,项目会在一天后自动删除。
status表示项目的状态,TODO工作环境,STOP停用状态,DEBUG调试状态,RUNNING运行状态。当设置为RUNNING状态时,点击右边actions的Run按钮,程序就会跑起来。actions中的Results按钮点击之后,查看程序爬取的结果,如图:
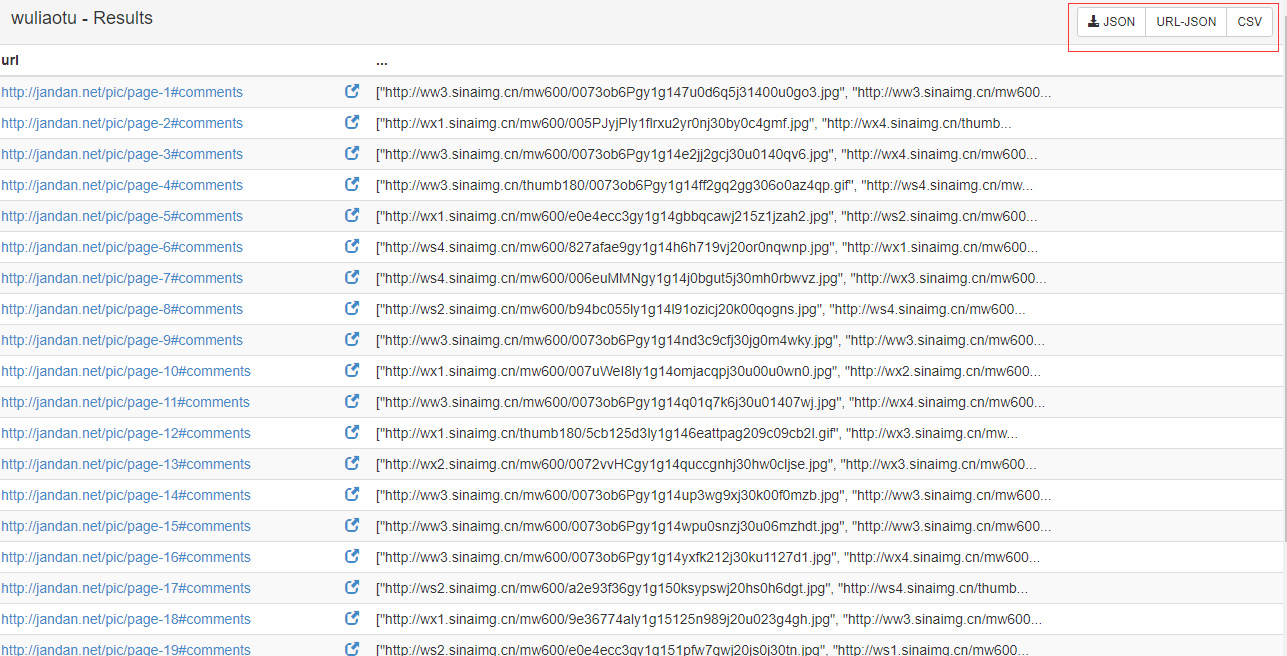
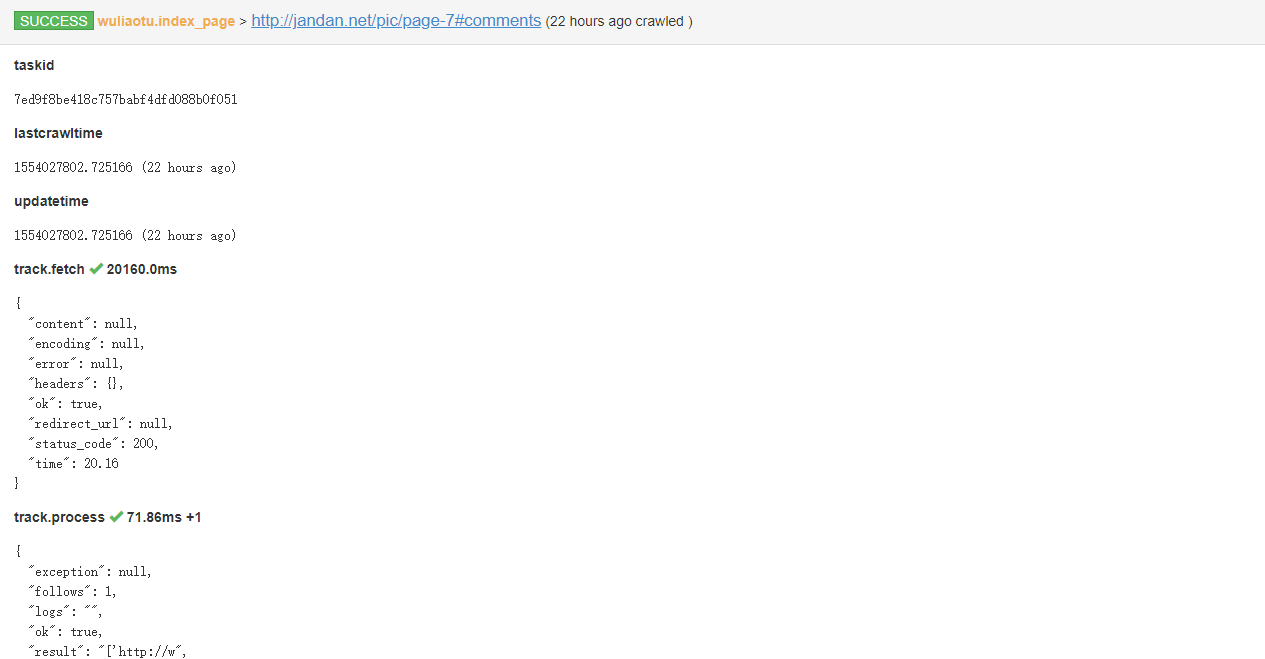
点击右上角,可以以不同格式查看爬取信息,点击url可以查看每个url爬取的任务ID,结果等信息。如图:
点击项目名,进入代码界面:

看代码,
#!/usr/bin/env python
# -*- encoding: utf-8 -*-
# Created on 2019-03-24 13:51:31
# Project: demo
from pyspider.libs.base_handler import *
import datetime
class Handler(BaseHandler):
crawl_config = {
}
def __init__(self):
'''用户自定义,初始化变量'''
## 当前页码
self.page=1
## 通过观察网站,发现职位信息列表一共480页
self.totalpage=480
## 开始要爬取的网址
self.baseUrl="https://job.alibaba.com/zhaopin/positionList.htm#page/"
## every装饰器,每隔24*60分钟爬取一次,执行一次函数
@every(minutes=24 * 60)
def on_start(self):
while(self.page<=self.totalpage):
## validate_cert=False表示不验证证书,fetch_type='js'表示爬取js加载类型数据信息
self.crawl(self.baseUrl + str(self.page), callback=self.index_page,validate_cert=False,fetch_type='js')
self.page += 1
## age表示生命周期为10天
@config(age=10 * 24 * 60 * 60)
## 所有的返回信息都保存在response中
def index_page(self, response):
## 同pyquery解析爬到的网页源码,.items()返回爬取列表中所有结点数据
for each in response.doc('td > span > a').items():
## callback是回调函数,在执行完当前函数所有代码后再调用回调函数
self.crawl(each.attr.href, callback=self.detail_page,validate_cert=False)
## priority表示优先级,越大优先级越高,最大9999
@config(priority=2)
def detail_page(self, response):
## 获取当前抓取时间
now_data=datetime.datetime.now()
return {
"acquistion_time":now_data.__str__(),
"url": response.url,
"title": response.doc('title').text(),
"detail-content":response.doc('.detail-content').text()
}
然后看左边编辑器,
每次编辑好右边代码后点击右上角SAVE按钮保存,然后点击RUN,运行程序

follows表示当前执行回调函数on_start执行之后,有多少此回调index_page函数,传入参数self。点击follows,出现每一个index_page函数传入的self中的链接,对应链接右边的向右箭头,执行该index_page函数。

点击第一个index_page函数右边箭头之后,点击web按钮,显示index_page传入链接的网页如图,点击html按钮,是web网页对应的源码,点击follows如图,显示执行index_page回调函数后的结果,即列表页信息。
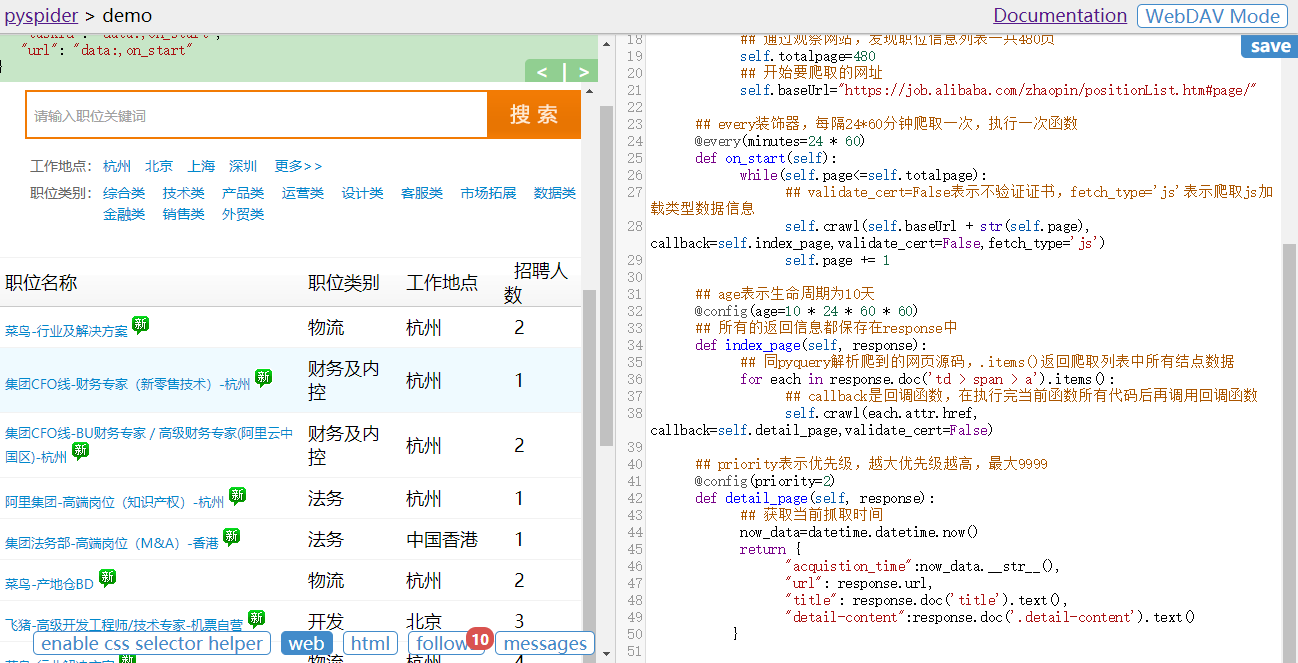
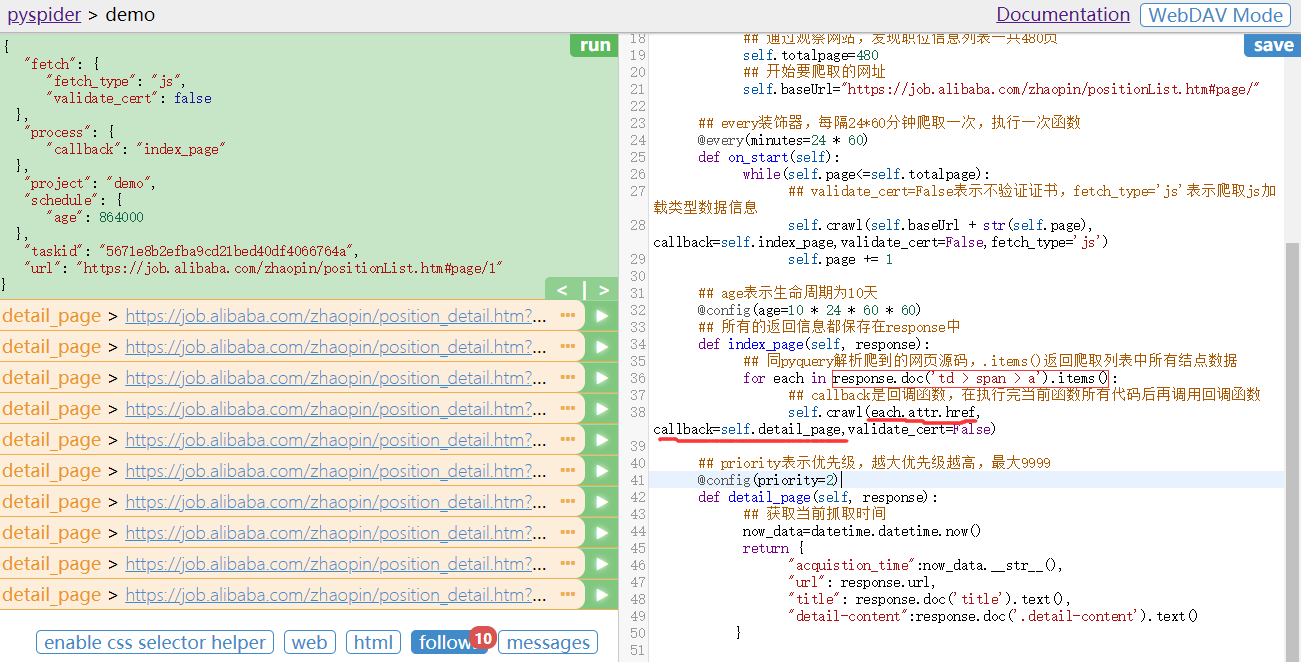
然后,在点击web按钮后,点击enable css selector helper按钮,选中web网页中对应职位标题,单击选中,然后点击左边窗体右上角的箭头,就会将对应选择结点的CSS选择器自动生成到右边代码编辑区鼠标定位处。

继续回来,点击follows,然后点击detail_page回调函数右边的箭头执行每个detail_page回调函数,则爬取了detail_page返回的内容,即详情页信息,每个职位的详细信息。

messages按钮表示右边代码中return的信息,及控制台提示信息、报错信息等。
pyspider爬虫框架webui简介-爬取阿里招聘信息的更多相关文章
- 爬虫框架之Scrapy——爬取某招聘信息网站
案例1:爬取内容存储为一个文件 1.建立项目 C:\pythonStudy\ScrapyProject>scrapy startproject tenCent New Scrapy projec ...
- 【图文详解】scrapy爬虫与动态页面——爬取拉勾网职位信息(2)
上次挖了一个坑,今天终于填上了,还记得之前我们做的拉勾爬虫吗?那时我们实现了一页的爬取,今天让我们再接再厉,实现多页爬取,顺便实现职位和公司的关键词搜索功能. 之前的内容就不再介绍了,不熟悉的请一定要 ...
- 爬取拉勾网招聘信息并使用xlwt存入Excel
xlwt 1.3.0 xlwt 文档 xlrd 1.1.0 python操作excel之xlrd 1.Python模块介绍 - xlwt ,什么是xlwt? Python语言中,写入Excel文件的扩 ...
- Python爬虫框架Scrapy获得定向打击批量招聘信息
爬虫,就是一个在网上到处或定向抓取数据的程序,当然,这样的说法不够专业,更专业的描写叙述就是.抓取特定站点网页的HTML数据.只是因为一个站点的网页非常多,而我们又不可能事先知道全部网页的URL地址, ...
- Python爬取拉勾网招聘信息并写入Excel
这个是我想爬取的链接:http://www.lagou.com/zhaopin/Python/?labelWords=label 页面显示如下: 在Chrome浏览器中审查元素,找到对应的链接: 然后 ...
- Java爬虫框架WebMagic入门——爬取列表类网站文章
初学爬虫,WebMagic作为一个Java开发的爬虫框架很容易上手,下面就通过一个简单的小例子来看一下. WebMagic框架简介 WebMagic框架包含四个组件,PageProcessor.Sch ...
- 爬虫框架Scrapy入门——爬取acg12某页面
1.安装1.1自行安装python3环境1.2ide使用pycharm1.3安装scrapy框架2.入门案例2.1新建项目工程2.2配置settings文件2.3新建爬虫app新建app将start_ ...
- python-scrapy爬虫框架爬取拉勾网招聘信息
本文实例为爬取拉勾网上的python相关的职位信息, 这些信息在职位详情页上, 如职位名, 薪资, 公司名等等. 分析思路 分析查询结果页 在拉勾网搜索框中搜索'python'关键字, 在浏览器地址栏 ...
- Scrapy框架——CrawlSpider爬取某招聘信息网站
CrawlSpider Scrapy框架中分两类爬虫,Spider类和CrawlSpider类. 它是Spider的派生类,Spider类的设计原则是只爬取start_url列表中的网页, 而Craw ...
随机推荐
- 记Android开发中的一些另类使用
1.使用recyclerview,直接添加下列依赖就可以使用recyclerview,版本号与appcompat-v7版本号相同 compile 'com.android.support:design ...
- Win10系统给文件夹添加备注
在Win10系统中,相信大多用户都没有看到过文件或者是文件夹上有备注信息.下面给大家分享下在Win10系统中给文件夹或文件添加备注的方法.在添加备注之前,首先我们要在需要显示备注的文件夹中显示&quo ...
- 零基础学Python--------第2章 Python语言基础
第2章 Python语言基础 2.1 Python语法特点 2.11注释 在Python中,通常包括3种类型的注释,分别是单行注释.多行注释和中文编码声明注释. 1.单行注释 在Python中,使用 ...
- SVN系列操作(二)&svn不显示图标的解决方法
接着上一篇文章,我们继续来操作一下SVN: 有同学反馈,我在本地上看到不SVN的图标,先解决一下这个问题. svn不显示图标的解决方法: 1.WIN+R,输入regedit,打开注册表 2.找到HKE ...
- 智能化CRM客户关系管理系统介绍一
智能化CRM客户关系管理系统介绍一 CRM客户关系管理的定义是:企业为提高核心竞争力,利用相应的信息技术以及互联网技术来协调企业与顾客间在销售.营销和服务上的交互,从而提升其管理方式,向客户提供创新式 ...
- ASP.NET MVC从空项目开始定制项目
在上一篇net core的文章中已经讲过如何从零开始搭建WebSocket. 今天聊聊ASP.NET的文件结构,如何用自己的目录结构组织项目里的文件. 如果用Visual Studio(VS)向导或d ...
- Linux 环境下 Git 安装与基本配置
索引: 目录索引 参看代码 GitHub: git.txt 一.Linux (DeepinOS) 环境 1.安装 sudo apt-get update sudo apt-get install gi ...
- Git命令备忘
最近在用Git,查了点相关资料,逻辑依然不太明了,先整理一部分备忘,以后补充 一.本地Git与Github/码云的关联 1. 设置本地用户名,邮箱 git config --global user.n ...
- Linux分页机制之分页机制的实现详解--Linux内存管理(八)
1 linux的分页机制 1.1 四级分页机制 前面我们提到Linux内核仅使用了较少的分段机制,但是却对分页机制的依赖性很强,其使用一种适合32位和64位结构的通用分页模型,该模型使用四级分页机制, ...
- php $$可变变量理解
//在变量前面加上两个$$,如$$name,这表示可变变量,可以动态的设置和使用,先设置一个普通变量,一个可变变量会获取了一个普通变量的值作为这个可变变量的变量名 $a = 'b'; $b = 'c' ...