
python爬虫之pyquery学习
相关内容:
- pyquery的介绍
- pyquery的使用
- 安装模块
- 导入模块
- 解析对象初始化
- css选择器
- 在选定元素之后的元素再选取
- 元素的文本、属性等内容的获取
- pyquery执行DOM操作、css操作
- Dom操作
- CSS操作
- 一个利用pyquery爬取豆瓣新书的例子
首发时间:2018-03-09 21:26
pyquery的介绍
- pyquery允许对xml、html文档进行jQuery查询。
- pyquery使用lxml进行快速xml和html操作。
- pyquery是python中的jquery
PyQuery的使用:
1.安装模块:
pip3 install pyquery
2.导入模块:
from pyquery import PyQuery as pq
3.解析对象初始化:
【使用PyQuery初始化解析对象,PyQuery是一个类,直接将要解析的对象作为参数传入即可】
- 解析对象为字符串时字符串初始化 :默认情况下是字符串,如果字符串是一个带http\https前缀的,将会认为是一个url
textParse = pq(html)
- 解析对象为网页时url初始化: 建议使用关键字参数url=
# urlParse = pq('http://www.baidu.com') #1

urlParse = pq(url='http://www.baidu.com') #2 - 解析对象为文件时文件初始化:建议使用关键字参数filename=
fileParse = pq(filename="L:\demo.html")
- 解析完毕后,就可以使用相关函数或变量来进行筛选,可以使用css等来筛选,
4.CSS选择器:
- 利用标签获取:
result = textParse('h2').text() - 利用类选择器:
result3=textParse(".p1").text() - 利用id选择:
result4=textParse("#user").attr("type") - 分组选择:
result5=textParse("p,div").text() - 后代选择器:
result6=textParse("div a").attr.href - 属性选择器:
result7=textParse("[class='p1']").text() - CSS3伪类选择器:
result8=textParse("p:last").text()
(更多的,可以参考css)
5.在选定元素之后的元素再选取:
- find():找出指定子元素 ,find可以有参数,该参数可以是任何 jQuery 选择器的语法,
- filter():对结果进行过滤,找出指定元素 ,filter可以有参数,该参数可以是任何 jQuery 选择器的语法,
- children():获取所有子元素,可以有参数,该参数可以是任何 jQuery 选择器的语法,
- parent():获取父元素,可以有参数,该参数可以是任何 jQuery 选择器的语法,
- parents():获取祖先元素,可以有参数,该参数可以是任何 jQuery 选择器的语法,
- siblings():获取兄弟元素,可以有参数,该参数可以是任何 jQuery 选择器的语法,
from pyquery import PyQuery as pq

html="""

<html>

<head>

</head>

<body>

<h2>This is a heading</h2>

<p class="p1">This is a paragraph.</p>

<p class="p2">This is another paragraph.</p>

<div>

123

<a id="a1" href="http://www.baidu.com">hello</a>

</div>

<input type="Button" >

<input id="user" type="text" >

</body>

"""

###初始化

textParse = pq(html)

# urlParse = pq('http://www.baidu.com') #1

# urlParse = pq(url='http://www.baidu.com') #2

# fileParse = pq(filename="L:\demo.html")

##获取

result = textParse('h2').text()

print(result)

result2= textParse('div').html()

print(result2)

result3=textParse(".p1").text()

print(result3)

result4=textParse("#user").attr("type")

print(result4)

result5=textParse("p,div").text()

print(result5)

result6=textParse("div a").attr.href

print(result6)

result7=textParse("[class='p1']").text()

print(result7)

result8=textParse("p:last").text()

print(result8)

result9=textParse("div").find("a").text()

print(result9)

result12=textParse("p").filter(".p1").text()

print(result12)

result10=textParse("div").children()

print(result10)

result11=textParse("a").parent()

print(result11)
6.元素的文本、属性等内容的获取:
attr(attribute):获取属性
result2=textParse("a").attr("href")
attr.xxxx:获取属性xxxx
result21=textParse("a").attr.href

result22=textParse("a").attr.class_
text():获取文本,子元素中也仅仅返回文本
result1=textParse("a").text()
html():获取html,功能与text类似,但返回html标签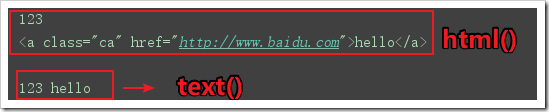
result3=textParse("div").html()
补充1:
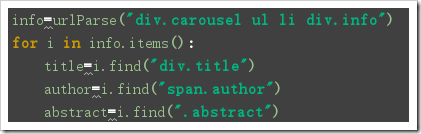
元素的迭代:如果返回的结果是多个元素,如果想迭代出每个元素,可以使用items():
补充2:pyquery是jquery的python化,语法基本都是相通的,想了解更多,可以参考jquery。
pyquery执行DOM操作、css操作:
DOM操作:
add_class():增加class
remove_class():移除class
remove():删除指定元素
from pyquery import PyQuery as pq

html="""

<html>

<head>

</head>

<body>

<h2>This is a heading</h2>

<p id="p1" class="p1">This is a paragraph.</p>

<p class="p2">This is another paragraph.</p>

<div style="color:blue">

123

<a class="ca" href="http://www.baidu.com">hello</a>

</div>

<input type="Button" >

<input id="user" type="text" >

</body>

"""

textParse=pq(html)

textParse('a').add_class("c1")

print(textParse('a').attr("class"))

textParse('a').remove_class("c1")

print(textParse('a').attr("class"))

print(textParse('div').html())

textParse('div').remove("a")

print(textParse('div').html())
css操作:
- attr():设置属性
- 设置格式:attr("属性名","属性值")
- css():设置css
- 设置格式1:css("css样式","样式值")
- 格式2:css({"样式1":"样式值","样式2":"样式值"})
from pyquery import PyQuery as pq

html="""

<html>

<head>

</head>

<body>

<h2>This is a heading</h2>

<p id="p1" class="p1">This is a paragraph.</p>

<p class="p2">This is another paragraph.</p>

<div style="color:blue">

123

<a class="ca" href="http://www.baidu.com">hello</a>

</div>

<input type="Button" >

<input id="user" type="text" >

</body>

"""

textParse=pq(html)

textParse('a').attr("name","hehe")

print(textParse('a').attr("name"))

textParse('a').css("color","white")

textParse('a').css({"background-color":"black","postion":"fixed"})

print(textParse('a').attr("style"))
这些操作什么时候会被用到:
【有时候可能会将数据样式处理一下再存储下来,就需要用到,比如我获取下来的数据样式我不满意,可以自定义成我自己的格式】
【有时候需要逐层清理再筛选出指定结果,比如<div>123<a></a></div>中,如果仅仅想要获取123就可以先删除<a>再获取】
一个利用pyquery爬取豆瓣新书的例子:
先使用审查元素,定位目标元素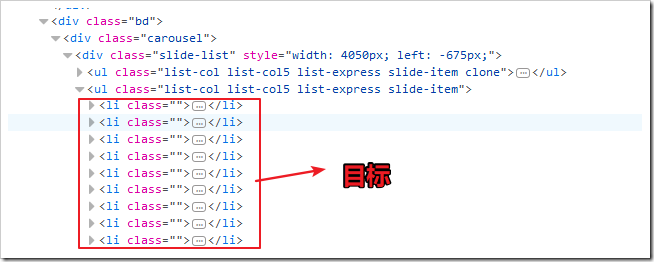
确认爬取信息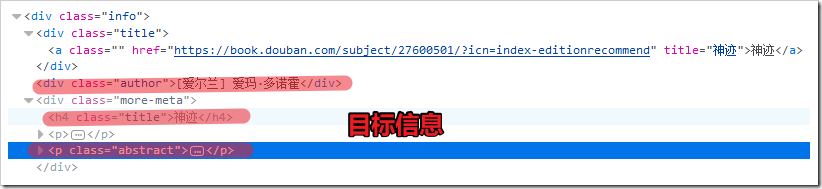
要注意的是,豆瓣新书是有一些分在后面页的,实际上目标应该是li的上一级ul: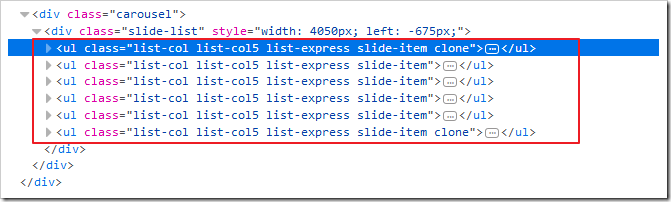
使用PyQuery筛选出结果:
from pyquery import PyQuery as pq

urlParse=pq(url="https://book.douban.com/")

info=urlParse("div.carousel ul li div.info")

file=open("demo.txt","w",encoding="utf8")

for i in info.items():

    title=i.find("div.title")

    author=i.find("span.author")

    abstract=i.find(".abstract")

    file.write("标题:"+title.text()+"\n")

    file.write("作者:"+author.text()+"\n")

    file.write("概要:"+abstract.text()+"\n")

    file.write("-----------------\n")

    print("\n")

file.close()
python爬虫之pyquery学习的更多相关文章
- Python爬虫之PyQuery使用(六)
Python爬虫之PyQuery使用 PyQuery简介 pyquery能够通过选择器精确定位 DOM 树中的目标并进行操作.pyquery相当于jQuery的python实现,可以用于解析HTML网 ...
- 专业的“python爬虫工程师”需要学习哪些知识?
学到哪种程度 暂且把目标定位初级爬虫工程师,简单列一下吧: (必要部分) 熟悉多线程编程.网络编程.HTTP协议相关 开发过完整爬虫项目(最好有全站爬虫经验,这个下面会说到) 反爬相关,cookie. ...
- python爬虫之Scrapy学习
在爬虫的路上,学习scrapy是一个必不可少的环节.也许有好多朋友此时此刻也正在接触并学习scrapy,那么很好,我们一起学习.开始接触scrapy的朋友可能会有些疑惑,毕竟是一个框架,上来不知从何学 ...
- python爬虫神器PyQuery的使用方法
你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有了一些 ...
- Python 爬虫如何入门学习?
"入门"是良好的动机,但是可能作用缓慢.如果你手里或者脑子里有一个项目,那么实践起来你会被目标驱动,而不会像学习模块一样慢慢学习. 另外如果说知识体系里的每一个知识点是图里的点,依 ...
- python爬虫之PyQuery的基本使用
PyQuery库也是一个非常强大又灵活的网页解析库,如果你有前端开发经验的,都应该接触过jQuery,那么PyQuery就是你非常绝佳的选择,PyQuery 是 Python 仿照 jQuery 的严 ...
- python爬虫解析库学习
一.xpath库使用: 1.基本规则: 2.将文件转为HTML对象: html = etree.parse('./test.html', etree.HTMLParser()) result = et ...
- 【Python爬虫】PyQuery解析库
PyQuery解析库 阅读目录 初始化 基本CSS选择器 查找元素 遍历 获取信息 DOM操作 伪类选择器 PyQuery 是 Python 仿照 jQuery 的严格实现.语法与 jQuery 几乎 ...
- Python爬虫之pyquery库的基本使用
# 字符串初始化 html = ''' <div> <ul> <li class = "item-0">first item</li> ...
随机推荐
- javaScript 节流与防抖
首先 我们要知道 节流与防抖可以干什么. 优化网络请求性能——节流 优化页面请求性能——防抖 举两个简单的小例子: 节流: 例如 有些购物页面,会有一些让你抢购的活动,到点的时候,需要你快速的点某个按 ...
- C# GroupBy分组的问题和解决
起因 今天在公司做一个需求的时候,写的是面条代码,一个方法直接从头写到尾,其中用到了GroupBy,且GroupBy的KeySelector是多个属性而不是单个属性. 但是公司最近推行Clean Co ...
- LeetCode:94_Binary Tree Inorder Traversal | 二叉树中序遍历 | Medium
题目:Binary Tree Inorder Traversal 二叉树的中序遍历,和前序.中序一样的处理方式,代码见下: struct TreeNode { int val; TreeNode* l ...
- LeetCode: 150_Evaluate Reverse Polish Notation | 分析逆波兰式 | Medium
题目: Evaluate Reverse Polish Notation Evaluatethe value of an arithmetic expression in Reverse Polish ...
- vueAdmin ui基础包
这个版本的vueAdmin ui是针对官网版本进行修改而成,主要修改了后端接口修改,登录等等,一个通用的前端工程基础包,即开即用,省去了前期繁琐配置 Demo Build Setup # Clone ...
- 3-5 Vue中的样式绑定
Vue中的样式绑定: 本案例,简单设计一个<div>的点击绑定事件来改变div的样式效果 方法一:[class] ①(class和对象的绑定) //如上,运用class和一个对象的形式来解 ...
- DDD实战进阶第一波(三):开发一般业务的大健康行业直销系统(搭建支持DDD的轻量级框架二)
了解了DDD的好处与基本的核心组件后,我们先不急着进入支持DDD思想的轻量级框架开发,也不急于直销系统需求分析和具体代码实现,我们还少一块, 那就是经典DDD的架构,只有了解了经典DDD的架构,你才能 ...
- Java连接Mysql数据库警告: Establishing SSL connection without server's identity verification is not recommended. According to MySQL 5.5.45+, 5.6.26+ and 5.7.6+ requirements SSL connection must be established
详细错误: Establishing SSL connection without server's identity verification is not recommended. Accordi ...
- aliyun阿里云Maven仓库配置
maven仓库用过的人都知道,国内有多么的悲催.还好有比较好用的镜像可以使用,尽快记录下来.速度提升100倍. http://maven.aliyun.com/nexus/#view-reposito ...
- Eureka安全认证
Eureka 服务加入安全认证只需要在之前的服务中增加三处步骤即可: 1.在Eureka Server中加入spring-boot-starter-security依赖 <dependencie ...