
Python学习笔记之爬取网页保存到本地文件
爬虫的操作步骤: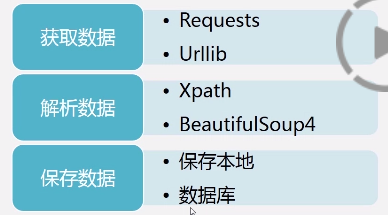
爬虫三步走
- 爬虫第一步:使用requests获得数据: (request库需要提前安装,通过pip方式,参考之前的博文)
1.导入requests
2.使用requests.get获取网页源码 import requests
r = requests.get('https://book.douban.com/subject/1084336/comments/').text
- 爬虫第二步:使用BeautifulSoup4解析数据: (BeautifulSoup4库需要提前安装,通过pip方式,参考之前的博文)
1.导入bs4
2.解析网页数据
3.寻找数据
4.for循环打印
from bs4 import BeautifulSoup
soup = BeautifulSoup(r,'lxml')
pattern = soup.find_all('p','comment-content')
for item in pattern:
print(item.string)
- 爬虫第三步:使用pandas保存数据: (pandas库需要提前安装,通过pip方式,参考之前的博文)
1.导入pandas
2.新建list对象
3.使用to_csv写入
import pandas
comments = []
for item in pattern:
comments.append(item.string)
df = pandas.DataFrame(comments)
df.to_csv('comments.csv')
完整的爬虫(值得注意的是关于BeautifulSoup和pandas两个包,都需要事先在电脑上安装,可以使用pip命令方式安装,具体方法可查看之前的博文命令 pip install beautifulsoup & pip install pandas)
import requests

r = requests.get('https://book.douban.com/subject/1084336/comments/').text from bs4 import BeautifulSoup
soup = BeautifulSoup(r,'lxml')
pattern = soup.find_all('p','comment-content')
for item in pattern:
print(item.string) import pandas
comments = []
for item in pattern:
comments.append(item.string)
df = pandas.DataFrame(comments)
df.to_csv('comments.csv')#当然这里可以指定文件路径,如 D:/PythonWorkSpace/TestData/comments.csv
代码运行结果:(注意的是,运行结果为csv,可能你用Excel打开之后会出现乱码,那是因为csv格式不对,怎么解决呢?
你可以将csv文件用Notepad++打开,编码Encoding选择 Encode in UTF-8-BOM)

如果是多页的话,为了防止保存到CSV 文件中的数据被上一页覆盖,可以这样用:
mode='a', header = False
df.to_csv('D:/Python....csv', mode='a', header = False)
Python学习笔记之爬取网页保存到本地文件的更多相关文章
- 吴裕雄--天生自然python学习笔记:爬取我国 1990 年到 2017年 GDP 数据并绘图显示
绘制图形所需的数据源通常是不固定的,比如,有时我们会需要从网页抓取, 也可能需从文件或数据库中获取. 利用抓取网页数据技术,把我国 1990 年到 2016 年的 GDP 数据抓取出来 ,再利用 Ma ...
- 【python爬虫】对喜马拉雅上一个专辑的音频进行爬取并保存到本地
>>>内容基本框架: 1.爬虫目的 2.爬取过程 3.代码实现 4.爬取结果 >>>实验环境: python3.6版本,pycharm,电脑可上网. [一 爬虫目 ...
- 【知识积累】使用Httpclient实现网页的爬取并保存至本地
程序功能实现了爬取网页页面并且将结果保存到本地,通过以爬取页面出发,做一个小的爬虫,分析出有利于自己的信息,做定制化的处理. 其中需要的http*的jar文件,可以在网上自行下载 import jav ...
- 【Python】python3 正则爬取网页输出中文乱码解决
爬取网页时候print输出的时候有中文输出乱码 例如: \\xe4\\xb8\\xad\\xe5\\x8d\\x8e\\xe4\\xb9\\xa6\\xe5\\xb1\\x80 #爬取https:// ...
- Python学习笔记(15)- os\os.path 操作文件
程序1 编写一个程序,统计当前目录下每个文件类型的文件数,程序实现如图: import os def countfile(path): dict1 = {} # 定义一个字典 all_files = ...
- python学习--第二天 爬取王者荣耀英雄皮肤
今天目的是爬取所有英雄皮肤 在爬取所有之前,先完成一张皮肤的爬取 打开anacond调出编译器Jupyter Notebook 打开王者荣耀官网 下拉找到位于网页右边的英雄/皮肤 点击[+更多] 进入 ...
- Python入门,以及简单爬取网页文本内容
最近痴迷于Python的逻辑控制,还有爬虫的一方面,原本的目标是拷贝老师上课时U盘的数据.后来发现基础知识掌握的并不是很牢固.便去借了一本Python基础和两本爬虫框架的书.便开始了自己的入坑之旅 言 ...
- python爬虫笔记之爬取足球比赛赛程
目标:爬取某网站比赛赛程,动态网页,则需找到对应ajax请求(具体可参考:https://blog.csdn.net/you_are_my_dream/article/details/53399949 ...
- python使用requests库爬取网页的小实例:爬取京东网页
爬取京东网页的全代码: #爬取京东页面的全代码 import requests url="https://item.jd.com/2967929.html" try: r=requ ...
随机推荐
- [JSOI2007]文本生成器(AC自动机,DP)
题目链接: 洛谷 LOJ BZOJ 题目大意:给定 $n$ 个只含大写字母的串(称为可读串),问有多少种只含大写字母的长为 $m$ 的串,包含至少一个可读串. $1\le n\le 60,1\le \ ...
- 2019.2.28&2019.3.1 考试
因为没A/改几道题,就一起写了 题目在LOJ上都能找到 2019.2.28 100+20+12 前两个小时一直在睡觉+想题也没思路,我太菜了 T1 洗衣服 分开处理出洗衣服和烘干的时间,然后一边正着排 ...
- webService与分布式与微服务与SOA的关系
SOA:是面向服务体系架构. webservice是SOA的一种实现技术.webservice基于两种协议:soap和rest协议.现在常用的是rest协议. web service (web 服务) ...
- debian8.4 ibus中文输入法
安装IBus: # apt-get install ibus ibus-sunpinyin ibus-table-wubi 导入输入法: 在Activities->Applications-&g ...
- python XML梳理
导入ElementTree模块 import xml.etree.ElementTree as ET 为了创建一个element实例,使用Element 构造函数或者SubElement()工厂函数. ...
- 【转载】ssh(安全外壳协议)
http://baike.baidu.com/subview/16184/5909252.htm?fr=aladdin
- 封装JSON数据转自定义HTML方法parseHTML
开发过程中经常使用字符串拼接,这样做工作效率低,可维护性和易读性也比较差,且对于后台程序员对html不熟悉,经常出错. 如下面例子json转字符串: var json = [{ href:'http: ...
- 20155206 2016-2017-2 《Java程序设计》第6周学习总结
20155206 2016-2017-2 <Java程序设计>第6周学习总结 教材学习内容总结 串流设计 流(Stream)是对「输入输出」的抽象,注意「输入输出」是相对程序而言的. Ja ...
- dialog 菜单实例
dislog 菜单实例 while : do clear menu=`dialog --title system custom` [ $? -eq ] && echo "$m ...
- bzoj 1432 数学(找规律)
我们可以发现所有的情况(除n=1时),都可以找到两个交叉的直线,就是第一层的那 两个线段所在的直线如图中左 那么我们以这个为准,两边对称着加直线,会得到右图,每一层是折线,且每 加一对儿就多两条线段, ...