
python3爬虫爬取煎蛋网妹纸图片(下篇)2018.6.25有效
分析完了真实图片链接地址,下面要做的就是写代码去实现了。想直接看源代码的可以点击这里
大致思路是:获取一个页面的的html---->使用正则表达式提取出图片hash值并进行base64解码--->将解码得到的结果进行拼接替换,得到原始图片地址--->对图片地址进行请求,对返回的content进行保存--->扩展到多个页面的爬取
首先请求一个页面,我们以http://jandan.net/ooxx/page-47#comments也就是首页为例(网站会不时变动,下次可能就不是这个page值了)
def get_page_html(url):

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36'

    }

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            return response.text

        return None

    except Exception as e:

        print(e)
然后使用正则表达式提取图片hash值
def get_real_img(html):

    pattern = re.compile('<span class="img-hash">(.*?)</span>')

    imgs_hash = re.findall(pattern, html)

    for img_hash in imgs_hash:

        yield base64_decode(img_hash)
使用base64解码
def base64_decode(img_hash):

    img_hash = base64.b64decode(img_hash)

    return img_hash
对图片进行请求
def get_img_content(url):

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.139 Safari/537.36'

    }

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            save_img(url, response.content)

        return None

    except Exception as e:

        print(e)
对图片进行保存
def save_img(url, content):

    root = 'E://jandan/'

    path = root + url.split('/')[-1]

    if not os.path.exists(root):

        os.mkdir(root)

    if not os.path.exists(path):

        with open(path, 'wb') as f:

            f.write(content)

            print('保存成功', url)
定义一个主函数,这里我传入了一个参数i,也就是页面号。另外加了一个睡眠,在每一次对页面进行请求获取内容前停留一段时间,防止频繁爬取被封ip。
def main(i):

    start_url = 'http://jandan.net/ooxx/page-{}#comments'.format(i)

    time.sleep(random.random() * random.randint(1, 10))

    html = get_page_html(start_url)

    for result in get_real_img(html):

        url_split = result.decode('utf-8').split('/')

        real_img_url = 'http://{}/{}/{}'.format(url_split[-3], 'large', url_split[-1])

        get_img_content(real_img_url)
最后写一个程序入口:
if __name__ == '__main__':

    start_page = 1

    end_page = 47

    pool = Pool()

    pool.map(main, [i for i in range(start_page, end_page + 1)])
最后的最后我们看一下成果:
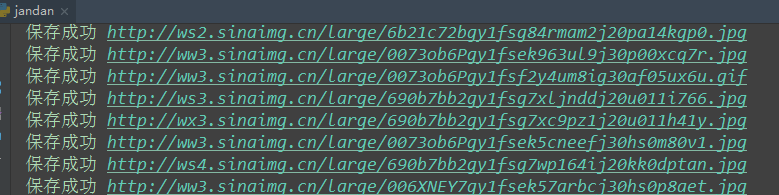

好了,关于煎蛋的话题就到这里。完整代码可以点击查看
python3爬虫爬取煎蛋网妹纸图片(下篇)2018.6.25有效的更多相关文章
- python3爬虫爬取煎蛋网妹纸图片(上篇)
其实之前实现过这个功能,是使用selenium模拟浏览器页面点击来完成的,但是效率实际上相对来说较低.本次以解密参数来完成爬取的过程. 首先打开煎蛋网http://jandan.net/ooxx,查看 ...
- python3爬虫.4.下载煎蛋网妹子图
开始我学习爬虫的目标 ----> 煎蛋网 通过设置User-Agent获取网页,发现本该是图片链接的地方被一个js函数代替了 于是全局搜索到该函数 function jandan_load_im ...
- python爬虫–爬取煎蛋网妹子图片
前几天刚学了python网络编程,书里没什么实践项目,只好到网上找点东西做. 一直对爬虫很好奇,所以不妨从爬虫先入手吧. Python版本:3.6 这是我看的教程:Python - Jack -Cui ...
- Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片. 用到的包: urllib.request os 分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地.过程简单清晰明了 直接上源代 ...
- python爬虫爬取煎蛋网妹子图片
import urllib.request import os def url_open(url): req = urllib.request.Request(url) req.add_header( ...
- Python Scrapy 爬取煎蛋网妹子图实例(一)
前面介绍了爬虫框架的一个实例,那个比较简单,这里在介绍一个实例 爬取 煎蛋网 妹子图,遗憾的是 上周煎蛋网还有妹子图了,但是这周妹子图变成了 随手拍, 不过没关系,我们爬图的目的是为了加强实战应用,管 ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
- 爬虫实例——爬取煎蛋网OOXX频道(反反爬虫——伪装成浏览器)
煎蛋网在反爬虫方面做了不少工作,无法通过正常的方式爬取,比如用下面这段代码爬取无法得到我们想要的源代码. import requests url = 'http://jandan.net/ooxx' ...
- scrapy从安装到爬取煎蛋网图片
下载地址:https://www.lfd.uci.edu/~gohlke/pythonlibs/pip install wheelpip install lxmlpip install pyopens ...
随机推荐
- Div+Css制作圆
Div+Css制作四分之一圆主要是使用Css3.0中的border-radius这个圆角隐藏属性.利用这一属性,我们可以画圆,画半圆,四分之三圆,四分之一圆等.以后我会更新…… 如何使用border- ...
- [Leetcode] Best time to buy and sell stock ii 买卖股票的最佳时机
Say you have an array for which the i th element is the price of a given stock on day i. Design an a ...
- P1641 [SCOI2010]生成字符串
P1641 [SCOI2010]生成字符串 题目描述 lxhgww最近接到了一个生成字符串的任务,任务需要他把n个1和m个0组成字符串,但是任务还要求在组成的字符串中,在任意的前k个字符中,1的个数不 ...
- 用PHP迭代器来实现一个斐波纳契数列
斐波纳契数列通常做法是用递归实现,当然还有其它的方法.这里现学现卖,用PHP的迭代器来实现一个斐波纳契数列,几乎没有什么难度,只是把类里的next()方法重写了一次.注释已经写到代码中,也是相当好理解 ...
- Spring源码解析-AOP简单分析
AOP称为面向切面编程,在程序开发中主要用来解决一些系统层面上的问题,比如日志,事务,权限等等,不需要去修改业务相关的代码. 对于这部分内容,同样采用一个简单的例子和源码来说明. 接口 public ...
- P2765 魔术球问题(网络流24题)
题目描述 «问题描述: 假设有n根柱子,现要按下述规则在这n根柱子中依次放入编号为1,2,3,...的球. (1)每次只能在某根柱子的最上面放球. (2)在同一根柱子中,任何2个相邻球的编号之和为完全 ...
- OpenCV+Java环境搭建
1.官网地址http://opencv.org/ 1.首先下载OpenCV2.4.6,下载的时候,选择windows版的.然后安装 2.其实安装的过程就是解压的过程,并没有什么安装向导之类的,安装完成 ...
- shell之流程控制
一.if语句.while.for循环各种小例题 1.用户验证 [root@bogon ~]# cat buer.sh #!/bin/bash #user='buer' #password='1234. ...
- csrf_execmp
参考;https://www.cnblogs.com/zhaof/p/6281482.html 全局: 中间件 django.middleware.csrf.CsrfViewMiddleware 局部 ...
- python3 闭包函数,装饰器
闭包函数: 1.定义在函数内部的函数 2.包含对外部作用域而非全局作用域的引用特点: 1.自带作用域 2.延迟计算(取到内存地址,加括号执行) def 外部函数(func): def 内部函数(*ar ...