
大数据系列之kafka-java实现
Java源码GitBub地址: https://github.com/fzmeng/kafka-demo
关于kafka安装步骤可见文章 http://www.cnblogs.com/cnmenglang/p/6520166.html
在上篇文章中使用shell 命令处理了kafka的消息生产与消息消费。下面介绍Java语言对kafka的消息生产与消息消费的处理。
1.代码结构如图
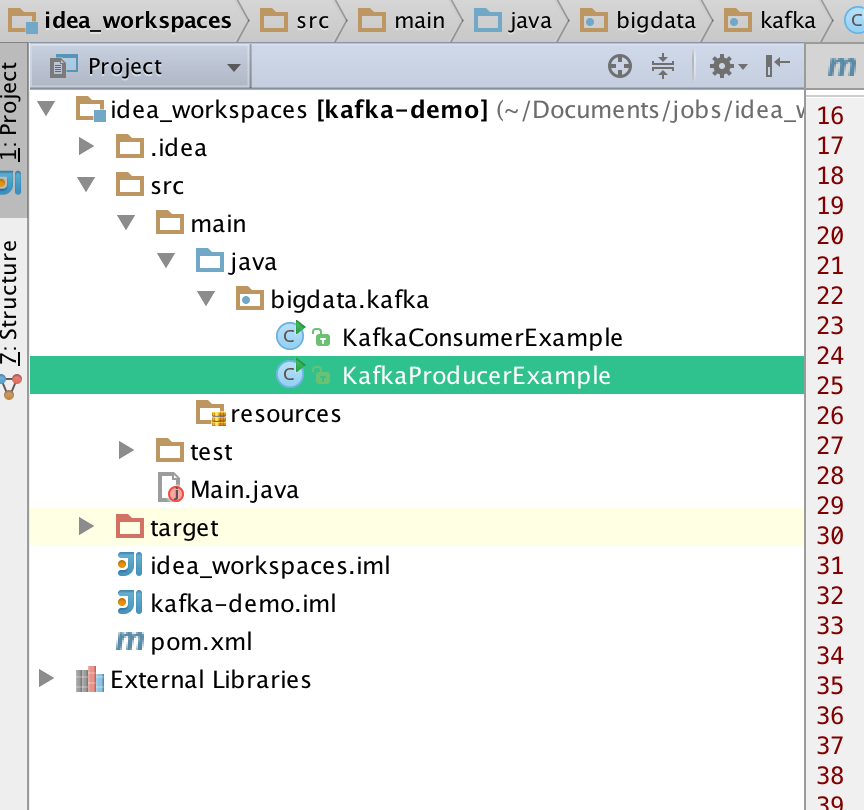
2.pom.xml
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0"

         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.</modelVersion>

    <groupId>mfz.kafka</groupId>

    <artifactId>kafka-demo</artifactId>

    <version>1.0-SNAPSHOT</version>

    <properties>

        <kafka.version>0.10.2.0</kafka.version>

    </properties>

    <dependencies>

    <dependency>

        <groupId>org.apache.kafka</groupId>

        <artifactId>kafka-clients</artifactId>

        <version>${kafka.version}</version>

    </dependency>

    <!-- https://mvnrepository.com/artifact/org.apache.kafka/kafka_2.11 -->

    <dependency>

        <groupId>org.apache.kafka</groupId>

        <artifactId>kafka_2.</artifactId>

        <version>${kafka.version}</version>

    </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <artifactId>maven-assembly-plugin</artifactId>

                <version>2.3</version>

                <configuration>

                    <classifier>dist</classifier>

                    <appendAssemblyId>true</appendAssemblyId>

                    <descriptorRefs>

                        <descriptor>jar-with-dependencies</descriptor>

                    </descriptorRefs>

                </configuration>

                <executions>

                    <execution>

                        <id>make-assembly</id>

                        <phase>package</phase>

                        <goals>

                            <goal>single</goal>

                        </goals>

                    </execution>

                </executions>

            </plugin>

        </plugins>

    </build>

</project>
2 . 生产者 KafKaProducerExample.java
package bigdata.kafka;

import org.apache.kafka.clients.producer.KafkaProducer;

import org.apache.kafka.clients.producer.Producer;

import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;

/**

 * @author mengfanzhu

 * @Package bigdata.kafka

 * @Description: kafka生产者

 * @date 17/3/8 17:20

 */

public class KafkaProducerExample {

    public void produceMessage()

    {

        Properties props = getConfig();

        Producer<String, String> producer = new KafkaProducer<String, String>(props);

        String topic="slavetest",key,value;

        for (int i = 0; i < 1000; i++) {

            key = "key"+i;

            value="value"+i;

            System.out.println("TOPIC: slavetest;发送KEY:"+key+";Value:"+value);

            producer.send(new ProducerRecord<String, String>(topic, key,value));

            try {

                Thread.sleep(1000);

            }

            catch (InterruptedException e) {

                e.printStackTrace();

            }

        }

        producer.close();

    }

    // config

    public Properties getConfig()

    {

        Properties props = new Properties();

        props.put("bootstrap.servers", "10.211.55.3:9092");

        props.put("acks", "all");

        props.put("retries", 0);

        props.put("batch.size", 16384);

        props.put("linger.ms", 1);

        props.put("buffer.memory", 33554432);

        props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer");

        return props;

    }

    public static void main(String[] args)

    {

        KafkaProducerExample example = new KafkaProducerExample();

        example.produceMessage();

    }

}
3.消费者 KafkaConsumerExample.java
package bigdata.kafka;

import org.apache.kafka.clients.consumer.ConsumerRecord;

import org.apache.kafka.clients.consumer.ConsumerRecords;

import org.apache.kafka.clients.consumer.KafkaConsumer;

import org.apache.kafka.common.errors.WakeupException;

import java.util.ArrayList;

import java.util.Arrays;

import java.util.List;

import java.util.Properties;

import java.util.concurrent.ExecutorService;

import java.util.concurrent.Executors;

import java.util.concurrent.TimeUnit;

import java.util.concurrent.atomic.AtomicBoolean;

/**

 * @author mengfanzhu

 * @Package bigdata.kafka

 * @Description: kafka 消费者

 * @date 17/3/8 17:21

 */

public class KafkaConsumerExample {

    //config

    public static Properties getConfig()

    {

        Properties props = new Properties();

        props.put("bootstrap.servers", "10.211.55.3:9092");

        props.put("group.id", "testGroup");

        props.put("enable.auto.commit", "true");

        props.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        props.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");

        return props;

    }

    public void consumeMessage()

    {

        // launch 3 threads to consume

        int numConsumers = 1;

        final String topic = "slavetest";

        final ExecutorService executor = Executors.newFixedThreadPool(numConsumers);

        final List<KafkaConsumerRunner> consumers = new ArrayList<KafkaConsumerRunner>();

        for (int i = 0; i < numConsumers; i++) {

            KafkaConsumerRunner consumer = new KafkaConsumerRunner(topic);

            consumers.add(consumer);

            executor.submit(consumer);

        }

        Runtime.getRuntime().addShutdownHook(new Thread()

        {

            @Override

            public void run()

            {

                for (KafkaConsumerRunner consumer : consumers) {

                    consumer.shutdown();

                }

                executor.shutdown();

                try {

                    executor.awaitTermination(5000, TimeUnit.MILLISECONDS);

                }

                catch (InterruptedException e) {

                    e.printStackTrace();

                }

            }

        });

    }

    // Thread to consume kafka data

    public static class KafkaConsumerRunner

            implements Runnable

    {

        private final AtomicBoolean closed = new AtomicBoolean(false);

        private final KafkaConsumer<String, String> consumer;

        private final String topic;

        public KafkaConsumerRunner(String topic)

        {

            Properties props = getConfig();

            consumer = new KafkaConsumer<String, String>(props);

            this.topic = topic;

        }

        public void handleRecord(ConsumerRecord record)

        {

            System.out.println("name: " + Thread.currentThread().getName() + " ; topic: " + record.topic() + " ; offset" + record.offset() + " ; key: " + record.key() + " ; value: " + record.value());

        }

        public void run()

        {

            try {

                // subscribe 订阅`topic

                consumer.subscribe(Arrays.asList(topic));

                while (!closed.get()) {

                    //read data

                    ConsumerRecords<String, String> records = consumer.poll(10000);

                    // Handle new records

                    for (ConsumerRecord<String, String> record : records) {

                        handleRecord(record);

                    }

                }

            }

            catch (WakeupException e) {

                // Ignore exception if closing

                e.printStackTrace();

                if (!closed.get()) {

                    throw e;

                }

            }

            finally {

                consumer.close();

            }

        }

        // Shutdown hook which can be called from a separate thread

        public void shutdown()

        {

            closed.set(true);

            consumer.wakeup();

        }

    }

    public static void main(String[] args)

    {

        KafkaConsumerExample example = new KafkaConsumerExample();

        example.consumeMessage();

    }

}
4.运行效果

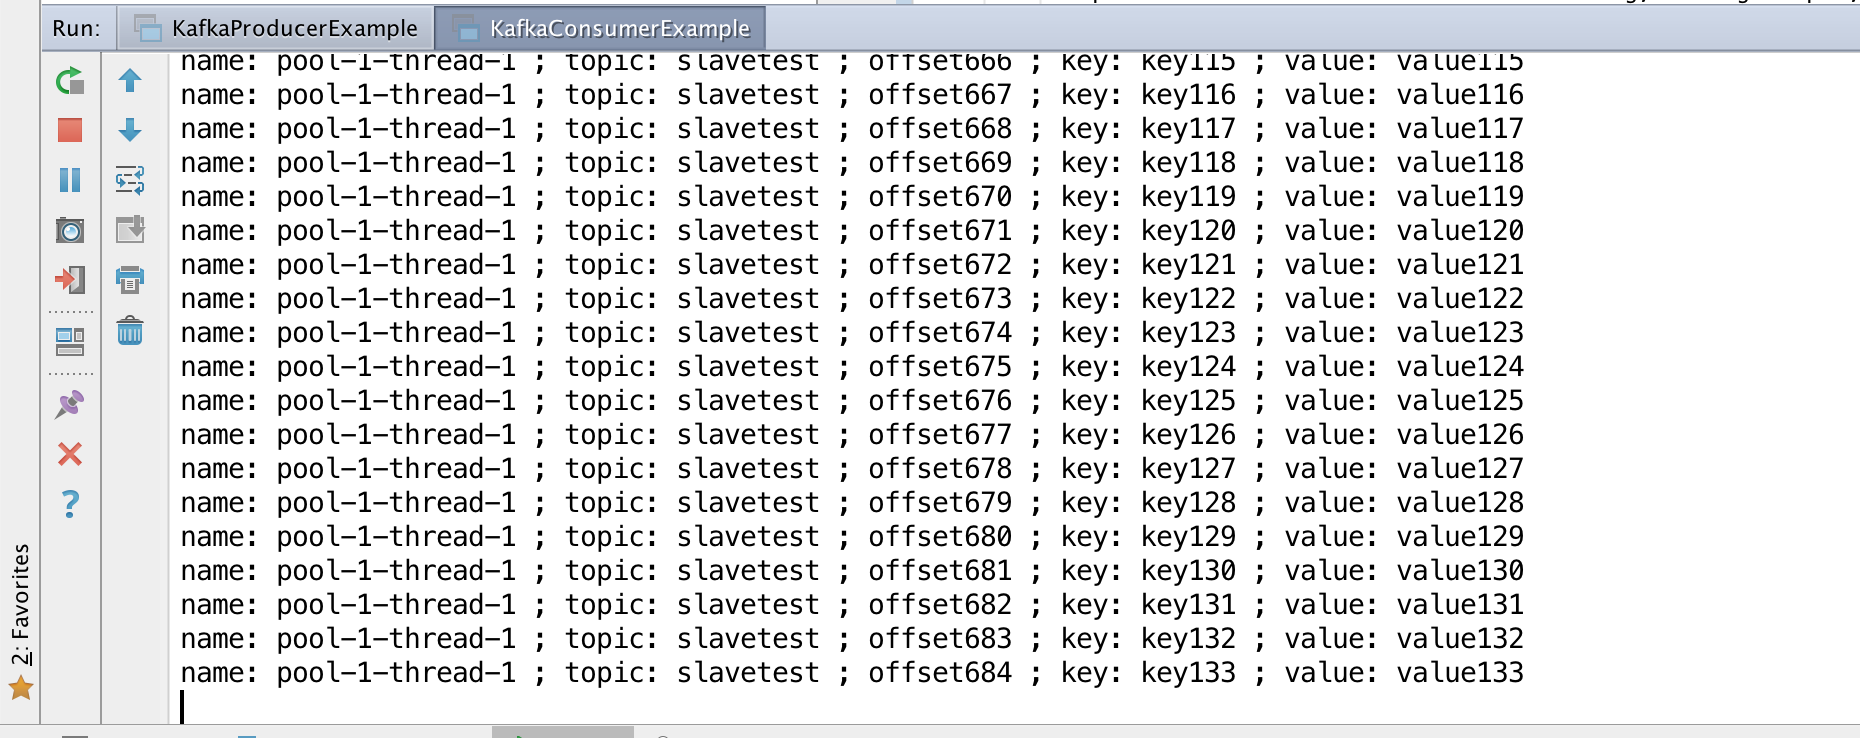
附加:代码不多,但是这样直接运行可能会导致消息消费失败,或是异常 "...Failed to send messages after 3 tries.."。原因是因为远程链接kafka时需要指定broker的地址(严格来说是所监听的网络接口,或者网卡)。
解决方案:
修改config/service.properties文件,默认是注释的。

大数据系列之kafka-java实现的更多相关文章
- 大数据系列之kafka监控kafkaoffsetmonitor安装
1.下载kafkaoffsetmonitor的jar包,可以到github搜索kafkaoffsetmonitor,第一个就是,里面可以下载编译好了的包. KafkaOffsetMonitor-ass ...
- 大数据系列之Kafka安装
先简单说下安装kafka的流程..(可配置多个zookeeper,这篇文只说一个zookeeper场景) 1.环境配置:jdk1.7+ (LZ用的是jdk1.8) 2.资料准备:下载 kafka_2. ...
- 大数据系列之Flume+kafka 整合
相关文章: 大数据系列之Kafka安装 大数据系列之Flume--几种不同的Sources 大数据系列之Flume+HDFS 关于Flume 的 一些核心概念: 组件名称 功能介绍 Agent ...
- 大数据系列(3)——Hadoop集群完全分布式坏境搭建
前言 上一篇我们讲解了Hadoop单节点的安装,并且已经通过VMware安装了一台CentOS 6.8的Linux系统,咱们本篇的目标就是要配置一个真正的完全分布式的Hadoop集群,闲言少叙,进入本 ...
- 大数据系列(2)——Hadoop集群坏境CentOS安装
前言 前面我们主要分析了搭建Hadoop集群所需要准备的内容和一些提前规划好的项,本篇我们主要来分析如何安装CentOS操作系统,以及一些基础的设置,闲言少叙,我们进入本篇的正题. 技术准备 VMwa ...
- 大数据系列之并行计算引擎Spark介绍
相关博文:大数据系列之并行计算引擎Spark部署及应用 Spark: Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎. Spark是UC Berkeley AMP lab ( ...
- 大数据系列之数据仓库Hive安装
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之数据仓库Hive命令使用及JDBC连接
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之分布式计算批处理引擎MapReduce实践-排序
清明刚过,该来学习点新的知识点了. 上次说到关于MapReduce对于文本中词频的统计使用WordCount.如果还有同学不熟悉的可以参考博文大数据系列之分布式计算批处理引擎MapReduce实践. ...
- 大数据系列之数据仓库Hive原理
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
随机推荐
- Android四大组件之Service(续)
本地服务启动和通过广播的方式回调是非常简单的. 下面介绍远程服务和通过远程回调的方式通知activity的方式. 1.service定义: package com.joyfulmath.globals ...
- [二]SpringBoot 之 简单的接口
(1)编写一个实体类Demo package me.shijunjie.entity; public class Demo { private long id; private String name ...
- 【BZOJ2339】卡农(递推,容斥)
[BZOJ2339]卡农(递推,容斥) 题面 BZOJ 题解 先简化一下题意: 在\([1,2^n-1]\)中选择不重复的\(m\)个数,使得他们异或和为\(0\)的方案数. 我们设\(f[i]\)表 ...
- WebLogic XMLDecoder反序列化漏洞(CVE-2017-10271)复现
WebLogic XMLDecoder反序列化漏洞(CVE-2017-10271) -----by ba ...
- Linux内核分析3
周子轩创作品转载请注明出处 <Linux内核分析>MOOC课程http://mooc.study.163.com/course/USTC-1000029000 gdb跟踪start_ke ...
- 【recording】gdoi2018
怎么说..虽然感觉其实..不太想写游记.. 但是回来看着桌面上的课本还是忍不住了(想想班里进度就..qwq)还是写一下吧 Day x(x<0) 之前大家溜到首都开心集训了一波然后被虐的很开心.. ...
- Java Socket TCP编程
package com; import java.io.*; import java.net.ServerSocket; import java.net.Socket; /** * Socket Se ...
- 在xadmin中自定义内容的变量及优化汇总
在网上找了很多有关xadmin的内容,发现都不太全 ,找到一篇总结不错的 http://www.lybbn.cn/data/bbsdatas.php?lybbs=62 1.list_display 指 ...
- [Java多线程]-J.U.C.atomic包下的AtomicInteger,AtomicLong等类的源码解析
Atomic原子类:为基本类型的封装类Boolean,Integer,Long,对象引用等提供原子操作. 一.Atomic包下的所有类如下表: 类摘要 AtomicBoolean 可以用原子方式更新的 ...
- Android 统一配置依赖管理
Android Studio中默认就是使用Gradle来构建管理工程的,当我们在工程构建过程中创建了多个Module时,就可能存在一个问题,那就是每个Module以及Module中一些公用库的依赖存在 ...