
Spark学习进度-Transformation算子
Transformation算子
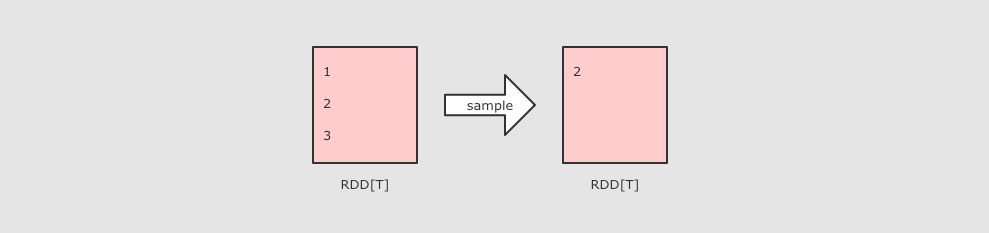
intersection
交集
/*

  交集

   */

  @Test

  def intersection(): Unit ={

    val rdd1=sc.parallelize(Seq(1,2,3,4,5))

    val rdd2=sc.parallelize(Seq(3,4,5,6,7))

    rdd1.intersection(rdd2)

      .collect()

      .foreach(println(_))

  }
union
并集
/*

  并集

   */

  @Test

  def union(): Unit ={

    val rdd1=sc.parallelize(Seq(1,2,3,4,5))

    val rdd2=sc.parallelize(Seq(3,4,5,6,7))

    rdd1.union(rdd2)

      .collect()

      .foreach(println(_))

  }

subtract
差集
@Test

  def subtract(): Unit ={

    val rdd1=sc.parallelize(Seq(1,2,3,4,5))

    val rdd2=sc.parallelize(Seq(3,4,5,6,7))

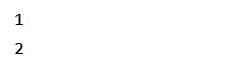
    rdd1.subtract(rdd2)

      .collect()

      .foreach(println(_))

  }
输出:
groupByKey
作用
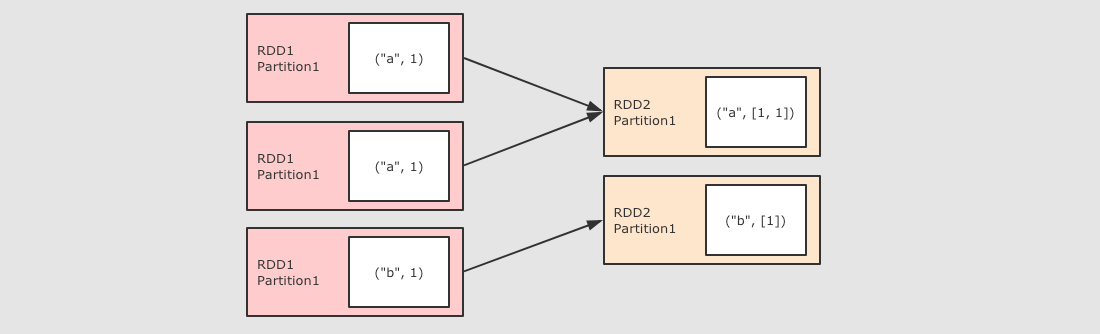
GroupByKey 算子的主要作用是按照 Key 分组, 和 ReduceByKey 有点类似, 但是 GroupByKey 并不求聚合, 只是列举 Key 对应的所有 Value
/*

  groupByKey  运算结果的格式:(K,(value1,value2))

  reduceByKey 能否在Map端做Combiner

   */

  @Test

  def groupByKey(): Unit ={

    sc.parallelize(Seq(("a",1),("a",1),("b",1)))

      .groupByKey()

      .collect()

      .foreach(println(_))

  }
distinct
作用:用于去重
@Test

  def distinct(): Unit ={

    sc.parallelize(Seq(1,1,2,2,3))

      .distinct()

      .collect()

      .foreach(println(_))

  }
输出:1,2,3
combineByKey
作用
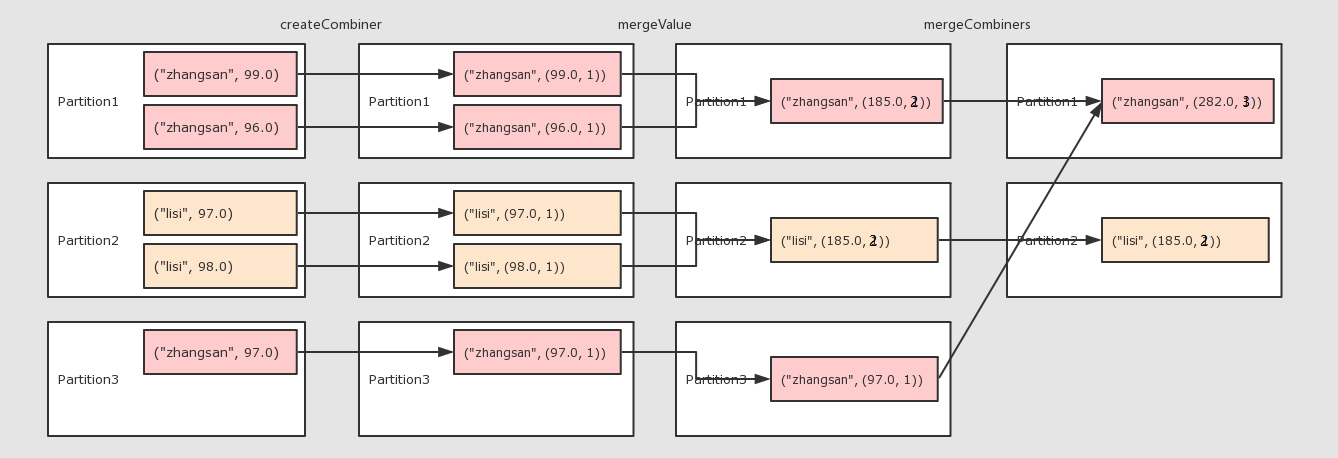
对数据集按照 Key 进行聚合
调用
combineByKey(createCombiner, mergeValue, mergeCombiners, [partitioner], [mapSideCombiner], [serializer])
参数
createCombiner将 Value 进行初步转换mergeValue在每个分区把上一步转换的结果聚合mergeCombiners在所有分区上把每个分区的聚合结果聚合partitioner可选, 分区函数mapSideCombiner可选, 是否在 Map 端 Combineserializer序列化器
例子:算个人得分的平均值
@Test

  def combineByKey(): Unit ={

    var rdd=sc.parallelize(Seq(

      ("zhangsan", 99.0),

      ("zhangsan", 96.0),

      ("lisi", 97.0),

      ("lisi", 98.0),

      ("zhangsan", 97.0)

    ))

    //2.算子运算

    //  2.1 createCombiner 转换数据

    //  2.2 mergeValue 分区上的聚合

    //  2.3 mergeCombiners 把所有分区上的结果再次聚合,生成最终结果

    val combineResult = rdd.combineByKey(

      createCombiner = (curr: Double) => (curr, 1),

      mergeValue = (curr: (Double, Int), nextValue: Double) => (curr._1 + nextValue, curr._2 + 1),

      mergeCombiners = (curr: (Double, Int), agg: (Double, Int)) => (curr._1 + agg._1, curr._2 + agg._2)

    )

    val resultRDD = combineResult.map(item => (item._1, item._2._1 / item._2._2))

    resultRDD.collect().foreach(print(_))

  }
aggregateByKey
作用
聚合所有 Key 相同的 Value, 换句话说, 按照 Key 聚合 Value
调用
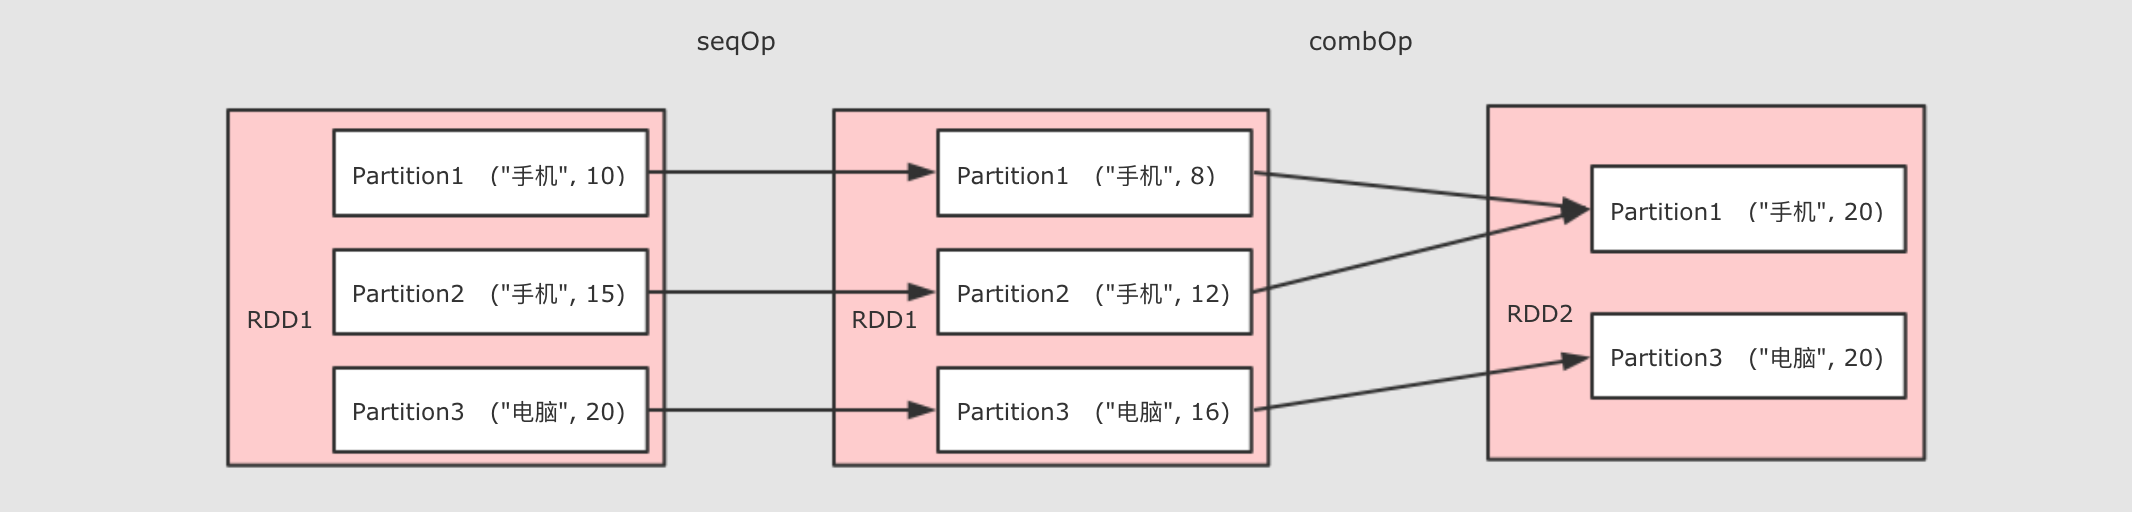
rdd.aggregateByKey(zeroValue)(seqOp, combOp)
参数
zeroValue初始值seqOp转换每一个值的函数comboOp将转换过的值聚合的函数
/*

  rdd.aggregateByKey(zeroValue)(seqOp, combOp)

    zeroValue 初始值

    seqOp 转换每一个值的函数

    comboOp 将转换过的值聚合的函数

   */

  @Test

  def aggregateByKey(): Unit ={

    val rdd=sc.parallelize(Seq(("手机",10.0),("手机",15.0),("电脑",20.0)))

    rdd.aggregateByKey(0.8)(( zeroValue,item) =>item * zeroValue,(curr,agg) => curr+agg)

      .collect()

      .foreach(println(_))

//    (手机,20.0)

//    (电脑,16.0)

  }
foldByKey
作用
和 ReduceByKey 是一样的, 都是按照 Key 做分组去求聚合, 但是 FoldByKey 的不同点在于可以指定初始值
/*

  foldByKey可以指定初始值

   */

  @Test

  def foldByKey(): Unit ={

    sc.parallelize(Seq(("a",1),("a",1),("b",1)))

      .foldByKey(zeroValue = 10)( (curr,agg) => curr + agg )

      .collect()

      .foreach(println(_))

  }

join
作用
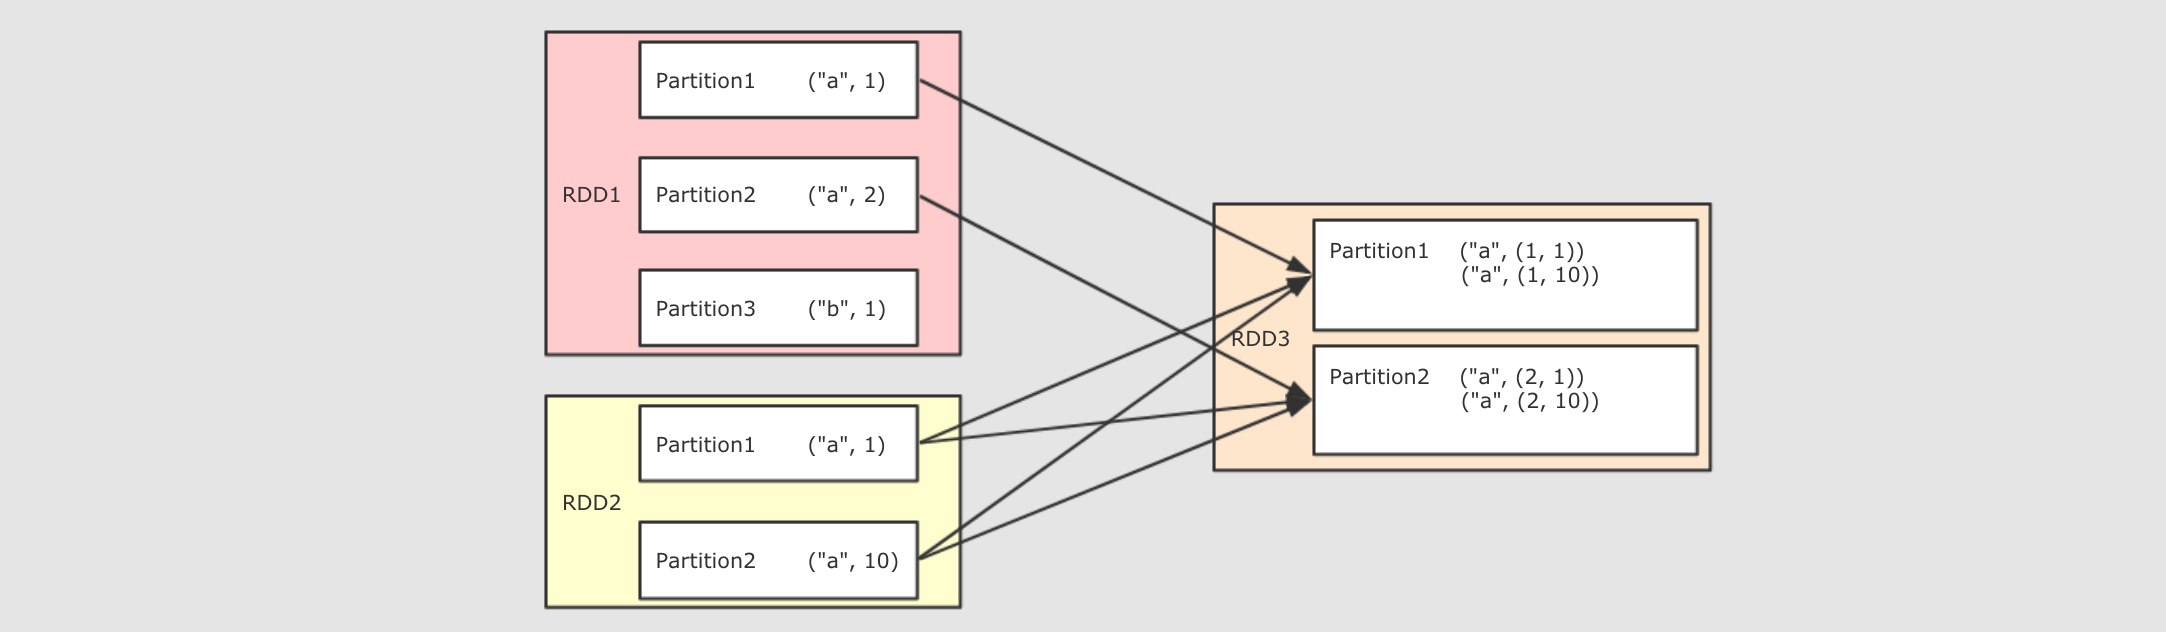
将两个 RDD 按照相同的 Key 进行连接
@Test

  def join(): Unit ={

    val rdd1 = sc.parallelize(Seq(("a", 1), ("a", 2), ("b", 1)))

    val rdd2 = sc.parallelize(Seq(("a", 10), ("a", 11), ("a", 12)))

    rdd1.join(rdd2).collect().foreach(println(_))

//    (a,(1,10))

//    (a,(1,11))

//    (a,(1,12))

//    (a,(2,10))

//    (a,(2,11))

//    (a,(2,12))

  }
sortBy
sortBy`可以指定按照哪个字段来排序, `sortByKey`直接按照 Key 来排序
@Test

  def sortBy(): Unit ={

    val rdd=sc.parallelize(Seq(8,4,5,6,2,1,1,9))

    val rdd2=sc.parallelize(Seq(("a",1),("b",3),("c",2)))

    //rdd.sortBy(item =>item).collect().foreach(println(_))

    rdd2.sortBy(item => item._2).collect().foreach(println(_))

    rdd2.sortByKey().collect().foreach(println(_))

  }
repartition
重新进行分区
@Test

  def partitioning(): Unit ={

    val rdd=sc.parallelize(Seq(1,2,3,4,5),2)

    //println((rdd.repartition(5)).partitions.size)

    println(rdd.coalesce(5,true).partitions.size)

  }
Spark学习进度-Transformation算子的更多相关文章
- Spark学习笔记--Transformation 和 action
转自:http://my.oschina.net/hanzhankang/blog/200275 附:各种操作的逻辑执行图 https://github.com/JerryLead/SparkInte ...
- Spark学习进度10-DS&DF基础操作
有类型操作 flatMap 通过 flatMap 可以将一条数据转为一个数组, 后再展开这个数组放入 Dataset val ds1=Seq("hello spark"," ...
- Spark学习进度11-Spark Streaming&Structured Streaming
Spark Streaming Spark Streaming 介绍 批量计算 流计算 Spark Streaming 入门 Netcat 的使用 项目实例 目标:使用 Spark Streaming ...
- Spark学习进度-Spark环境搭建&Spark shell
Spark环境搭建 下载包 所需Spark包:我选择的是2.2.0的对应Hadoop2.7版本的,下载地址:https://archive.apache.org/dist/spark/spark-2. ...
- Spark学习进度-RDD
RDD RDD 是什么 定义 RDD, 全称为 Resilient Distributed Datasets, 是一个容错的, 并行的数据结构, 可以让用户显式地将数据存储到磁盘和内存中, 并能控制数 ...
- Spark学习进度-实战测试
spark-shell 交互式编程 题目:该数据集包含了某大学计算机系的成绩,数据格式如下所示: Tom,DataBase,80 Tom,Algorithm,50 Tom,DataStructure ...
- Spark学习之常用算子介绍
1. reduceByKey reduceByKey的作用对像是(key, value)形式的rdd,而reduce有减少.压缩之意,reduceByKey的作用就是对相同key的数据进行处理,最终每 ...
- Spark学习进度7-综合案例
综合案例 文件排序 解法: 1.读取数据 2.数据清洗,变换数据格式 3.从新分区成一个分区 4.按照key排序,返还带有位次的元组 5.输出 @Test def filesort(): Unit = ...
- Spark学习之路(四)—— RDD常用算子详解
一.Transformation spark常用的Transformation算子如下表: Transformation算子 Meaning(含义) map(func) 对原RDD中每个元素运用 fu ...
随机推荐
- PyQt(Python+Qt)学习随笔:Qt Designer中主窗口对象documentMode属性
documentMode属性表示当前主窗口是否启用文档模式,如果是则主窗口的选项卡部件会以适合操作文档的模式呈现,这类似于macOS上的文档模式. 设置此属性时,界面上不会呈现选项卡部件框架.此模式当 ...
- espcms代码审计(二次urldecode注入分析)
这里提到的漏洞是二次urldecode注入 这里用到的还是espcms,不过版本应该跟之前的有所不同,在网上找到的espcms源代码都是已经修补了这个漏洞的,我们对比分析吧 先放上漏洞位置代码,也就是 ...
- git 常用命令 command
git config --list //查看配置信息 git config user.name //查看用户名 git config user.email //查看用户邮箱 从远程克隆到本地仓库 ...
- BJWC2011 禁忌
题目链接 题解 多模式匹配首先建 AC 自动机,看到 \(len \le 10^9\) 想到矩阵乘法优化. 朴素 DP 关于分割的最大值,可以贪心,只要走到一个能匹配串的点立刻返回根继续匹配就行,一定 ...
- redis学习之——五大基本数据类型
redis 键 (key) 基本数据类型:string 字符串 list (列表) set(集合) hash(类似java 中的Map) zset(有序集合) 官方命令doc redis 键 ...
- Bug java 安全证书
在一个改修项目里,安全性方面总是出一个bug,错误信息如下: xception in thread "main" javax.crypto.BadPaddingException: ...
- windows 10 1909 无法启用 .NET Framework 解决
安装某应用,运行提示: 应用程序无法正常启动(0xc0000135) 应该是缺少 .net framework. 控制面板-程序-"启用或关闭windows功能" 勾选.NET F ...
- [游记]FCS&FJOI2018滚粗记
省冬连着省选,嗯这篇博客是省冬前就开的 省选是在情人节前一天- day0 中午早早的来了这边(找了个酒店到房间发现非常粉w 下午一个人去附中报到,然而-没有人带队签安全责任书好像不行-签到失败QAQ ...
- k8s第二回之k8s集群的安装
1. k8s集群的安装 目录 1. k8s集群的安装 1.架构: 2.环境准备 3.master节点安装etcd 4. master节点安装kubernetes 5.node节点安装kubernete ...
- js 点击按钮下载图片,另存为
js: 1 $(document).on('click',"#xiazai",function(){ 2 imgurl = $(".img-box").find ...