
Spark学习进度-实战测试
spark-shell 交互式编程
题目:该数据集包含了某大学计算机系的成绩,数据格式如下所示:
Tom,DataBase,80
Tom,Algorithm,50
Tom,DataStructure,60
Jim,DataBase,90
Jim,Algorithm,60
Jim,DataStructure,80
……
请根据给定的实验数据,在 spark-shell 中通过编程来计算以下内容:
(1)该系总共有多少学生;

(2)该系共开设来多少门课程;
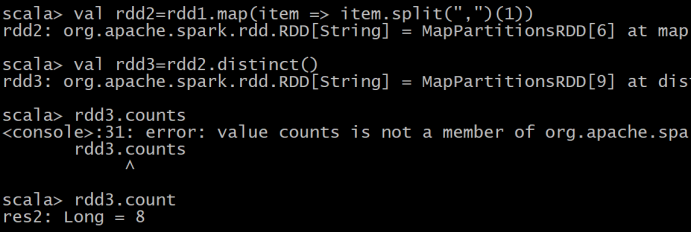
(3)Tom 同学的总成绩平均分是多少;
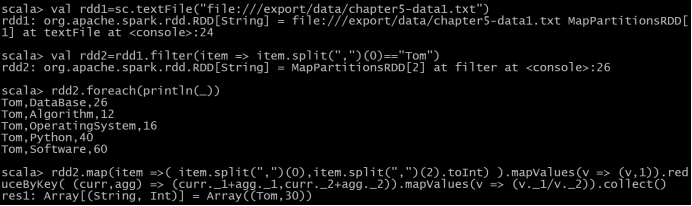
(4)求每名同学的选修的课程门数;

共265行
(5)该系 DataBase 课程共有多少人选修;

(6)各门课程的平均分是多少;

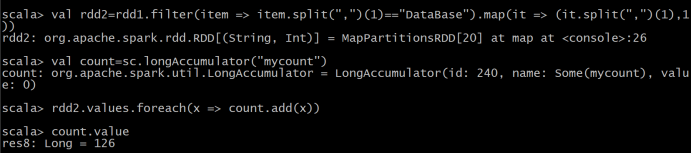
(7)使用累加器计算共有多少人选了 DataBase 这门课。
独立应用
实现数据去重,连接,排序
对于两个输入文件 A 和 B,编写 Spark 独立应用程序,对两个文件进行合并,并剔除其
中重复的内容,得到一个新文件 C。下面是输入文件和输出文件的一个样例,供参考。
输入文件 A 的样例如下:
20170101 x
20170102 y
20170103 x
20170104 y
20170105 z
20170106 z
输入文件 B 的样例如下:
20170101 y
20170102 y
20170103 x
20170104 z
20170105 y
根据输入的文件 A 和 B 合并得到的输出文件 C 的样例如下:
20170101 x
20170101 y
20170102 y
20170103 x
20170104 y
20170104 z
20170105 y
20170105 z
20170106 z
代码:
@Test

  def test(): Unit ={

    val conf=new SparkConf().setMaster("local[6]").setAppName("xlf_union")

    val sc=new SparkContext(conf)

    val ra=sc.textFile("dataset/a.txt")

    val rb=sc.textFile("dataset/b.txt")

    val rc=ra.union(rb)

      .distinct()

      .map(item => (item.split(" ")(0),item.split(" ")(1)))

      .sortBy(item =>(item._1,item._2))

      .collect()

    val file = "dataset/c.txt"

    val writer = new BufferedWriter(new OutputStreamWriter(new FileOutputStream(file)))

    for(x<- rc)

    {

      println(x)

      writer.write(x+"\n")

    }

    writer.close()

  }
实现求平均值
每个输入文件表示班级学生某个学科的成绩,每行内容由两个字段组成,第一个是学生
名字,第二个是学生的成绩;编写 Spark 独立应用程序求出所有学生的平均成绩,并输出到
一个新文件中。下面是输入文件和输出文件的一个样例,供参考。
Algorithm 成绩:
小明 92
小红 87
小新 82
小丽 90
Database 成绩:
小明 95
小红 81
小新 89
小丽 85
Python 成绩:
小明 82
小红 83
小新 94
小丽 91
平均成绩如下:
(小红,83.67)
(小新,88.33)
(小明,89.67)
(小丽,88.67)
代码:
@Test

def test2(): Unit ={

  val conf=new SparkConf().setMaster("local[6]").setAppName("xlf_avg")

  val sc=new SparkContext(conf)

  val ra=sc.textFile("dataset/Algorithm.txt")

  val rb=sc.textFile("dataset/Database.txt")

  val rc=sc.textFile("dataset/Python.txt")

  val out=ra.union(rb)

    .union(rc)

    .map(item => (item.split(" ")(0),item.split(" ")(1).toDouble))

    .mapValues(v => (v,1))

    .reduceByKey( (x,y) =>(x._1+y._1,x._2+y._2) )

    .mapValues(v => (v._1/v._2).formatted("%.2f") )

    .collect()

  val file = "dataset/out.txt"

  val writer = new BufferedWriter(new OutputStreamWriter(new FileOutputStream(file)))

  for(x<- out)

  {

    println(x)

    writer.write(x+"\n")

  }

  writer.close()

}
Spark学习进度-实战测试的更多相关文章
- Spark学习进度-Spark环境搭建&Spark shell
Spark环境搭建 下载包 所需Spark包:我选择的是2.2.0的对应Hadoop2.7版本的,下载地址:https://archive.apache.org/dist/spark/spark-2. ...
- Spark学习进度10-DS&DF基础操作
有类型操作 flatMap 通过 flatMap 可以将一条数据转为一个数组, 后再展开这个数组放入 Dataset val ds1=Seq("hello spark"," ...
- Spark学习进度11-Spark Streaming&Structured Streaming
Spark Streaming Spark Streaming 介绍 批量计算 流计算 Spark Streaming 入门 Netcat 的使用 项目实例 目标:使用 Spark Streaming ...
- Spark学习进度-RDD
RDD RDD 是什么 定义 RDD, 全称为 Resilient Distributed Datasets, 是一个容错的, 并行的数据结构, 可以让用户显式地将数据存储到磁盘和内存中, 并能控制数 ...
- Spark学习进度-Transformation算子
Transformation算子 intersection 交集 /* 交集 */ @Test def intersection(): Unit ={ val rdd1=sc.parallelize( ...
- Spark学习进度7-综合案例
综合案例 文件排序 解法: 1.读取数据 2.数据清洗,变换数据格式 3.从新分区成一个分区 4.按照key排序,返还带有位次的元组 5.输出 @Test def filesort(): Unit = ...
- Spark大型项目实战:电商用户行为分析大数据平台
本项目主要讲解了一套应用于互联网电商企业中,使用Java.Spark等技术开发的大数据统计分析平台,对电商网站的各种用户行为(访问行为.页面跳转行为.购物行为.广告点击行为等)进行复杂的分析.用统计分 ...
- Spark学习入门(让人看了想吐的话题)
这是个老生常谈的话题,大家是不是看到这个文章标题就快吐了,本来想着手写一些有技术深度的东西,但是看到太多童鞋卡在入门的门槛上,所以还是打算总结一下入门经验.这种标题真的真的在哪里都可以看得到,度娘一搜 ...
- NGUI 学习笔记实战之二——商城数据绑定(Ndata)
上次笔记实现了游戏商城的UI界面,没有实现动态数据绑定,所以是远远不够的.今天采用NData来做一个商城. 如果你之前没看过,可以参考上一篇博客 NGUI 学习笔记实战——制作商城UI界面 ht ...
随机推荐
- PyQt(Python+Qt)学习随笔:布局控件layout的layoutSizeConstraint属性
在Qt Designer中布局控件有4个,分别是Vertical Layout(垂直布局).Horizontal Layout(水平布局).Grid Layout(网格布局).Form Layout( ...
- Scrum冲刺_Day02
一.团队展示: 1.项目:light_note备忘录 2.队名:删库跑路队 3.团队成员 队员(不分先后) 项目角色 黄敦鸿 后端工程师.测试 黄华 后端工程师.测试 黄骏鹏 后端工程师.测试 黄源钦 ...
- java中==和equals的不同使用方法
System.out.println("input a charact a "); Scanner input2 = new Scanner(System.in); St ...
- kafka命令及启动
默认内网访问,要在外网访问的话,需要在修改config/server.properties中的配置 将listeners和advertised.listeners的值用主机名进行替换,在外用使用jav ...
- 戴尔iDRAC+Ubuntu 18.04系统安装
Ubuntu镜像下载链接:http://mirrors.aliyun.com/ubuntu-releases/18.04/ 1.登录戴尔管理口 2.点击虚拟控制台 3.选择镜像 4.挂载镜像 5.选择 ...
- 如何更简单的使用Polly
Polly 弹性瞬时错误处理库 Polly是一个C#实现的弹性瞬时错误处理库 它可以帮助我们做一些容错模式处理,比如: 超时与重试(Timeout and Retry) 熔断器(Circuit Bre ...
- ab test压力测试
之前做性能调试的时候一直用的JMeter压测,最近发现一款简单易用的压力测试工具. ab(Apache benchmark)是一款常用的压力测试工具,是Apache附带的一个小工具 , 专门用于HTT ...
- 图的遍历DFS
图的遍历DFS 与树的深度优先遍历之间的联系 树的深度优先遍历分为:先根,后根 //树的先根遍历 void PreOrder(TreeNode *R){ if(R!=NULL){ visit(R); ...
- Day3 条件判断和循环
条件判断 if...else if...elif...else 格式: 注意缩进! if x: active elif y: active else : active 注 ...
- ubuntu 18 安装xgboost GPU版本
综合上述两个帖子: https://www.cnblogs.com/huadongw/p/6161145.html https://blog.csdn.net/u011587516/article/d ...