
吴裕雄 数据挖掘与分析案例实战(12)——SVM模型的应用
import pandas as pd
# 导入第三方模块
from sklearn import svm
from sklearn import model_selection
from sklearn import metrics
# 读取外部数据
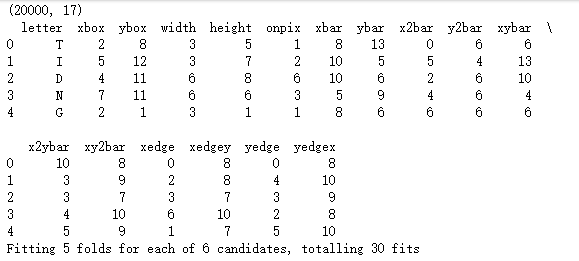
letters = pd.read_csv(r'F:\\python_Data_analysis_and_mining\\13\\letterdata.csv')
print(letters.shape)
# 数据前5行
print(letters.head())
# 将数据拆分为训练集和测试集
predictors = letters.columns[1:]
X_train,X_test,y_train,y_test = model_selection.train_test_split(letters[predictors], letters.letter, test_size = 0.25, random_state = 1234)
# 使用网格搜索法,选择线性可分SVM“类”中的最佳C值
C=[0.05,0.1,0.5,1,2,5]
parameters = {'C':C}
grid_linear_svc = model_selection.GridSearchCV(estimator = svm.LinearSVC(),param_grid =parameters,scoring='accuracy',cv=5,verbose =1)
# 模型在训练数据集上的拟合
grid_linear_svc.fit(X_train,y_train)
# 返回交叉验证后的最佳参数值
print(grid_linear_svc.best_params_, grid_linear_svc.best_score_)
# 模型在测试集上的预测
pred_linear_svc = grid_linear_svc.predict(X_test)
# 模型的预测准确率
metrics.accuracy_score(y_test, pred_linear_svc)
# 使用网格搜索法,选择非线性SVM“类”中的最佳C值
kernel=['rbf','linear','poly','sigmoid']
C=[0.1,0.5,1,2,5]
parameters = {'kernel':kernel,'C':C}
grid_svc = model_selection.GridSearchCV(estimator = svm.SVC(),param_grid =parameters,scoring='accuracy',cv=5,verbose =1)
# 模型在训练数据集上的拟合
grid_svc.fit(X_train,y_train)
# 返回交叉验证后的最佳参数值
print(grid_svc.best_params_, grid_svc.best_score_)
# 模型在测试集上的预测
pred_svc = grid_svc.predict(X_test)
# 模型的预测准确率
metrics.accuracy_score(y_test,pred_svc)
# 读取外部数据
forestfires = pd.read_csv(r'F:\\python_Data_analysis_and_mining\\13\\forestfires.csv')
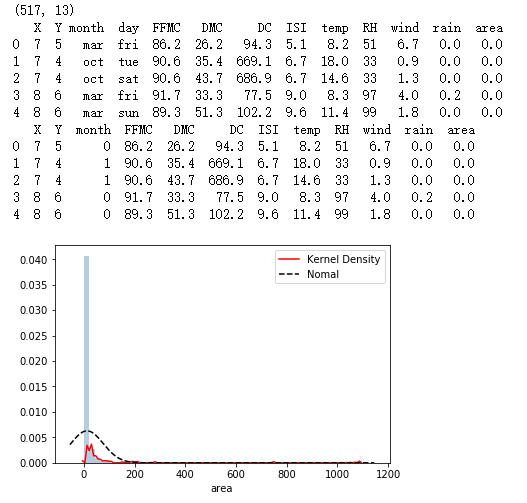
print(forestfires.shape)
# 数据前5行
print(forestfires.head())
# 删除day变量
forestfires.drop('day',axis = 1, inplace = True)
# 将月份作数值化处理
forestfires.month = pd.factorize(forestfires.month)[0]
# 预览数据前5行
print(forestfires.head())
# 导入第三方模块
import seaborn as sns
import matplotlib.pyplot as plt
from scipy.stats import norm
# 绘制森林烧毁面积的直方图
sns.distplot(forestfires.area, bins = 50, kde = True, fit = norm, hist_kws = {'color':'steelblue'},
kde_kws = {'color':'red', 'label':'Kernel Density'},
fit_kws = {'color':'black','label':'Nomal', 'linestyle':'--'})
# 显示图例
plt.legend()
# 显示图形
plt.show()
# 导入第三方模块
from sklearn import preprocessing
import numpy as np
from sklearn import neighbors
# 对area变量作对数变换
y = np.log1p(forestfires.area)
# 将X变量作标准化处理
predictors = forestfires.columns[:-1]
X = preprocessing.scale(forestfires[predictors])
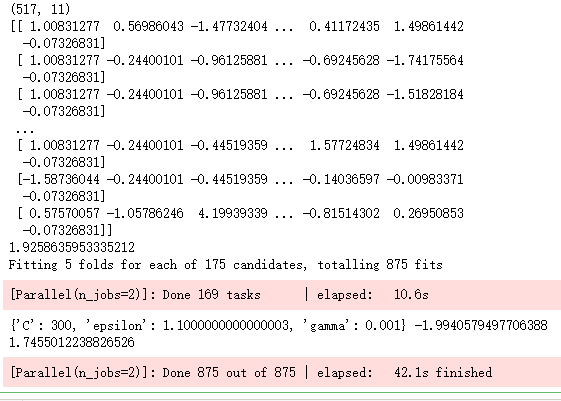
print(X.shape)
print(X)
# 将数据拆分为训练集和测试集
X_train,X_test,y_train,y_test = model_selection.train_test_split(X, y, test_size = 0.25, random_state = 1234)
# 构建默认参数的SVM回归模型
svr = svm.SVR()
# 模型在训练数据集上的拟合
svr.fit(X_train,y_train)
# 模型在测试上的预测
pred_svr = svr.predict(X_test)
# 计算模型的MSE
a = metrics.mean_squared_error(y_test,pred_svr)
print(a)
# 使用网格搜索法,选择SVM回归中的最佳C值、epsilon值和gamma值
epsilon = np.arange(0.1,1.5,0.2)
C= np.arange(100,1000,200)
gamma = np.arange(0.001,0.01,0.002)
parameters = {'epsilon':epsilon,'C':C,'gamma':gamma}
grid_svr = model_selection.GridSearchCV(estimator = svm.SVR(),param_grid =parameters,
scoring='neg_mean_squared_error',cv=5,verbose =1, n_jobs=2)
# 模型在训练数据集上的拟合
grid_svr.fit(X_train,y_train)
# 返回交叉验证后的最佳参数值
print(grid_svr.best_params_, grid_svr.best_score_)
# 模型在测试集上的预测
pred_grid_svr = grid_svr.predict(X_test)
# 计算模型在测试集上的MSE值
print(metrics.mean_squared_error(y_test,pred_grid_svr))
吴裕雄 数据挖掘与分析案例实战(12)——SVM模型的应用的更多相关文章
- 吴裕雄 数据挖掘与分析案例实战(15)——DBSCAN与层次聚类分析
# 导入第三方模块import pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport seaborn as snsfr ...
- 吴裕雄 数据挖掘与分析案例实战(10)——KNN模型的应用
# 导入第三方包import pandas as pd # 导入数据Knowledge = pd.read_excel(r'F:\\python_Data_analysis_and_mining\\1 ...
- 吴裕雄 数据挖掘与分析案例实战(5)——python数据可视化
# 饼图的绘制# 导入第三方模块import matplotlibimport matplotlib.pyplot as plt plt.rcParams['font.sans-serif']=['S ...
- 吴裕雄 数据挖掘与分析案例实战(3)——python数值计算工具:Numpy
# 导入模块,并重命名为npimport numpy as np# 单个列表创建一维数组arr1 = np.array([3,10,8,7,34,11,28,72])print('一维数组:\n',a ...
- 吴裕雄 数据挖掘与分析案例实战(2)——python数据结构及方法、控制流、字符串处理、自定义函数
list1 = ['张三','男',33,'江苏','硕士','已婚',['身高178','体重72']]# 取出第一个元素print(list1[0])# 取出第四个元素print(list1[3] ...
- 吴裕雄 数据挖掘与分析案例实战(14)——Kmeans聚类分析
# 导入第三方包import pandas as pdimport numpy as np import matplotlib.pyplot as pltfrom sklearn.cluster im ...
- 吴裕雄 数据挖掘与分析案例实战(13)——GBDT模型的应用
# 导入第三方包import pandas as pdimport matplotlib.pyplot as plt # 读入数据default = pd.read_excel(r'F:\\pytho ...
- 吴裕雄 数据挖掘与分析案例实战(8)——Logistic回归分类模型
import numpy as npimport pandas as pdimport matplotlib.pyplot as plt # 自定义绘制ks曲线的函数def plot_ks(y_tes ...
- 吴裕雄 数据挖掘与分析案例实战(7)——岭回归与LASSO回归模型
# 导入第三方模块import pandas as pdimport numpy as npimport matplotlib.pyplot as pltfrom sklearn import mod ...
随机推荐
- 【python】正则表达式-group和group的区别
__author__ = 'paul' import re a = "123abc456" print re.search("([0-9]*)([a-z]*)([0-9] ...
- linux中set的用法
功能说明:设置shell.语 法:set [+-abCdefhHklmnpPtuvx]补充说明:用set 命令可以设置各种shell选项或者列 出shell变量.单个选项设置常用的特性.在某些选项之后 ...
- json格式字符串处理
public class InternalClass { public int MID; public string Name; ...
- 论战大数据----胖子哥的PK之旅(一)
胖子哥(1106110976) 9:35:36 http://www.cnblogs.com/hadoopdev/p/3531963.htmlnosqlt数据库-肖(380594863) 9:38:0 ...
- vs 2017/2015/2013 如何定位C++内存泄漏
定位内存泄漏是C++的一个大问题 我们可以通过如下方式进行定位: //在主函数文件中加入如下代码 #include <stdlib.h> #include <crtdbg.h> ...
- bzoj1819 电子词典
Description 人们在英文字典中查找某个单词的时候可能不知道该单词的完整拼法,而只知道该单词的一个错误的近似拼法,这时人们可能陷入困境,为了查找一个单词而浪费大量的时间.带有模糊查询功能的电子 ...
- 使用pip安装Scrapy出错
目录 安装Scrapy出错 安装 使用pip安装(Ubuntu) 错误信息 解决方法 安装Scrapy出错 安装 使用pip安装(Ubuntu) # 安装pip sudo apt install py ...
- java中使HttpDelete可以发送body信息
java中使HttpDelete可以发送body信息RESTful api中用到了DELETE方法,android开发的同事遇到了问题,使用HttpDelete执行DELETE操作的时候,不能携带bo ...
- Linux性能分析 vmstat基本语法
vmstat vmstat 统计虚拟内存信息,可以对操作系统的proc.memory.CPU.IO等信息进行统计以呈现给用户. 根据操作系统的不同,vmstat的输出结果会有不同.大家可 ...
- 【BZOJ】1923 [Sdoi2010]外星千足虫(高斯消元)
题目 传送门:QWQ 分析 高斯消元解异或方程组,和解普通方程组差不多. 范围有点大,要套一个bitset. 代码 #include <bits/stdc++.h> using names ...