
【自然语言处理】--视觉问答(Visual Question Answering,VQA)从初始到应用
一、前述
视觉问答(Visual Question Answering,VQA),是一种涉及计算机视觉和自然语言处理的学习任务。这一任务的定义如下: A VQA system takes as input an image and a free-form, open-ended, natural-language question about the image and produces a natural-language answer as the output[1]。 翻译为中文:一个VQA系统以一张图片和一个关于这张图片形式自由、开放式的自然语言问题作为输入,以生成一条自然语言答案作为输出。简单来说,VQA就是给定的图片进行问答。
VQA系统需要将图片和问题作为输入,结合这两部分信息,产生一条人类语言作为输出。针对一张特定的图片,如果想要机器以自然语言来回答关于该图片的某一个特定问题,我们需要让机器对图片的内容、问题的含义和意图以及相关的常识有一定的理解。VQA涉及到多方面的AI技术(图1):细粒度识别(这位女士是白种人吗?)、 物体识别(图中有几个香蕉?)、行为识别(这位女士在哭吗?)和对问题所包含文本的理解(NLP)。综上所述,VQA是一项涉及了计算机视觉(CV)和自然语言处理(NLP)两大领域的学习任务。它的主要目标就是让计算机根据输入的图片和问题输出一个符合自然语言规则且内容合理的答案。
二、具体步骤
2.1 第一步,生成答案
2.2 第二步,处理输⼊源数据
2.2.1 处理输⼊源数据:图⽚
卷积CNN结合VGG-16模型
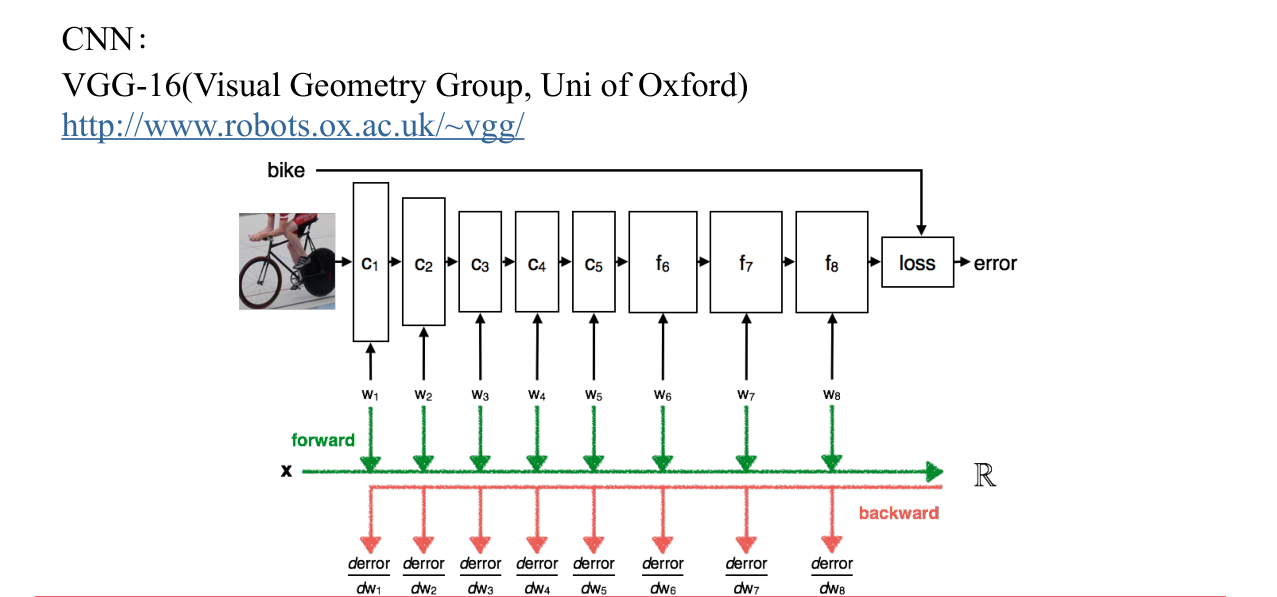
VGG-16的标准构造 (keras)
def VGG_16(weights_path=None):

model = Sequential()

model.add(ZeroPadding2D((1,1),input_shape=(3,224,224)))

model.add(Convolution2D(64, 3, 3, activation='relu'))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(64, 3, 3, activation='relu'))

model.add(MaxPooling2D((2,2), strides=(2,2)))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(128, 3, 3, activation='relu'))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(128, 3, 3, activation='relu'))

model.add(MaxPooling2D((2,2), strides=(2,2)))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(256, 3, 3, activation='relu'))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(256, 3, 3, activation='relu'))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(256, 3, 3, activation='relu'))

model.add(MaxPooling2D((2,2), strides=(2,2)))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(512, 3, 3, activation='relu'))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(512, 3, 3, activation='relu'))

model.add(ZeroPadding2D((1,1)))

model.add(Convolution2D(512, 3, 3, activation='relu'))

model.add(MaxPooling2D((2,2), strides=(2,2)))

model.add(Flatten())

model.add(Dense(4096, activation='relu'))

model.add(Dropout(0.5))

model.add(Dense(4096, activation='relu'))

model.add(Dropout(0.5))

model.add(Dense(1000, activation='softmax'))

if weights_path:

model.load_weights(weights_path)

return model
2.2.2 处理输⼊源数据:⽂字
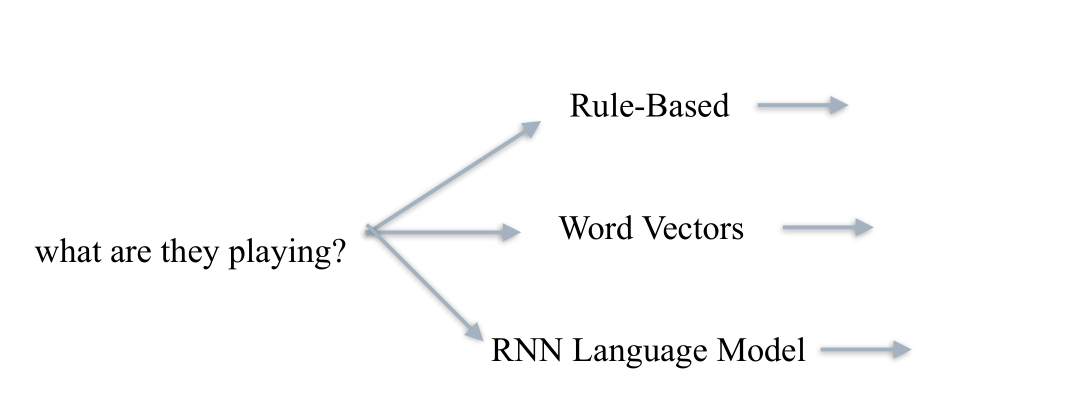
2.3 第三步, 选取VQA模型-MLP
2.3.1 选取VQA模型-MLP
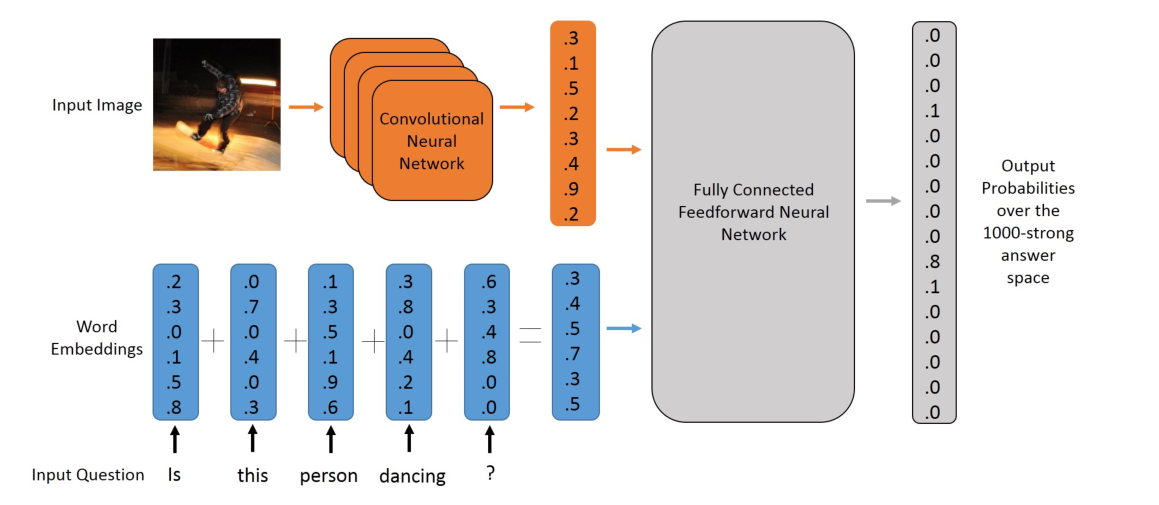
2.3.2 选取VQA模型-LSTM

【自然语言处理】--视觉问答(Visual Question Answering,VQA)从初始到应用的更多相关文章
- Hierarchical Question-Image Co-Attention for Visual Question Answering
Hierarchical Question-Image Co-Attention for Visual Question Answering NIPS 2016 Paper: https://arxi ...
- Visual Question Answering with Memory-Augmented Networks
Visual Question Answering with Memory-Augmented Networks 2018-05-15 20:15:03 Motivation: 虽然 VQA 已经取得 ...
- 第八讲_图像问答Image Question Answering
第八讲_图像问答Image Question Answering 课程结构 图像问答的描述 具备一系列AI能力:细分识别,物体检测,动作识别,常识推理,知识库推理..... 先要根据问题,判断什么任务 ...
- 论文笔记:Visual Question Answering as a Meta Learning Task
Visual Question Answering as a Meta Learning Task ECCV 2018 2018-09-13 19:58:08 Paper: http://openac ...
- 论文阅读:Learning Visual Question Answering by Bootstrapping Hard Attention
Learning Visual Question Answering by Bootstrapping Hard Attention Google DeepMind ECCV-2018 2018 ...
- Learning Conditioned Graph Structures for Interpretable Visual Question Answering
Learning Conditioned Graph Structures for Interpretable Visual Question Answering 2019-05-29 00:29:4 ...
- VQA视觉问答基础知识
本文记录简单了解VQA的过程,目的是以此学习图像和文本的特征预处理.嵌入以及如何设计分类loss等等. 参考资料: https://zhuanlan.zhihu.com/p/40704719 http ...
- 论文:Bottom-Up and Top-Down Attention for Image Captioning and Visual Question Answering-阅读总结
Bottom-Up and Top-Down Attention for Image Captioning and Visual Question Answering-阅读总结 笔记不能简单的抄写文中 ...
- 【论文小综】基于外部知识的VQA(视觉问答)
我们生活在一个多模态的世界中.视觉的捕捉与理解,知识的学习与感知,语言的交流与表达,诸多方面的信息促进着我们对于世界的认知.作为多模态领域的一个典型场景,VQA旨在结合视觉的信息来回答所提出的问题 ...
随机推荐
- canvas学习笔记(一)
canvas是HTML5的新元素之一.使用canvas可以直接在HTML上进行图形操作,所以它具有极大的应用价值.canvas元素本身不具有绘图能力,它需要借助JavaScript来实现绘图功能. c ...
- ResultSet,RowSet,OracleCachedRowSet和RowSetMetaData区别及联系
在java主要涉及到数据开发的过程中,我们会和数据库打交道很多,其中使用了数据集比如ResultSet和RowSet,经常使用两种,还有其它的一些,那么这两种的主要区别是什么呢?我们先来看它们引入的方 ...
- Java单元测试初体验(JUnit4)
什么是单元测试 我们在编写大型程序的时候,需要写成千上万个方法或函数,这些函数的功能可能很强大,但我们在程序中只用到该函数的一小部分功能,并且经过调试可以确定,这一小部分功能是正确的.但是,我们同时应 ...
- plugin.go 源码阅读
, nil) } if c.client != nil { c.client.Close() } ...
- jenkins 解决构建成功后进程消失的问题
最近模块拆分,独立出了几个服务.上线流程并不复杂,只需要在指定目录执行bash deploy.sh master即可上线master分支.但是架不住模块太多,每天在上线流程上也花费了不少时间,所以尝试 ...
- 虚拟机console基础环境配置——安装VMware Tools
1. 虚拟机设置中点击安装2. 虚拟机中挂载VMware Tools镜像3. 解压安装4. 配置共享目录5. 有关VMware Tools 1. 虚拟机设置中点击安装 VMware workstati ...
- const和static readonly的区别
我们都知道,const和static readonly的确很像:通过类名而不是对象名进行访问,在程序中只读等等. 在多数情况下可以混用.二者本质的区别在于,const的值是在编译期间确定的,因此只能在 ...
- 【SAP HANA】新建账户和数据库(2)
开启HANA Studio,进入到User和Role的目录,这两个地方是创建账号和权限的. 新建用户 输入用户名和密码即可. 注意,如果系统里有同名的Catalog(数据库)存在的话,会报错,因为默认 ...
- 多线程学习系列二(使用System.Threading)
一.什么是System.Threading.Thread?如何使用System.Threading.Thread进行异步操作 System.Threading.Thread:操作系统实现线程并提供各种 ...
- Solr 17 - Solr的时间为什么比本地少8小时 (附修改方法)
目录 1 为什么少8小时 2 如何查看Solr的时区 3 修改Solr的时区 3.1 Solr从数据库中同步数据的原理 3.2 为什么要修改时区 3.3 如何修改时区 1 为什么少8小时 (1) 原因 ...