
吴裕雄 python 机器学习——人工神经网络感知机学习算法的应用
import numpy as np

from matplotlib import  pyplot as plt

from sklearn import neighbors, datasets

from matplotlib.colors import ListedColormap

from sklearn.neural_network import MLPClassifier

## 加载数据集

np.random.seed(0)

# 使用 scikit-learn  自带的 iris 数据集

iris=datasets.load_iris()

# 使用前两个特征,方便绘图

X=iris.data[:,0:2]

# 标记值

Y=iris.target

data=np.hstack((X,Y.reshape(Y.size,1)))

# 混洗数据。因为默认的iris 数据集:前50个数据是类别0,中间50个数据是类别1,末尾50个数据是类别2.混洗将打乱这个顺序

np.random.shuffle(data)

X=data[:,:-1]

Y=data[:,-1]

train_x=X[:-30]

train_y=Y[:-30]

# 最后30个样本作为测试集

test_x=X[-30:]

test_y=Y[-30:]

def plot_classifier_predict_meshgrid(ax,clf,x_min,x_max,y_min,y_max):

    '''

     绘制 MLPClassifier 的分类结果

    :param ax:  Axes 实例,用于绘图

    :param clf: MLPClassifier 实例

    :param x_min: 第一维特征的最小值

    :param x_max: 第一维特征的最大值

    :param y_min: 第二维特征的最小值

    :param y_max: 第二维特征的最大值

    :return: None

      '''

    plot_step = 0.02 # 步长

    xx, yy = np.meshgrid(np.arange(x_min, x_max, plot_step),np.arange(y_min, y_max, plot_step))

    Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])

    Z = Z.reshape(xx.shape)

    # 绘图

    ax.contourf(xx, yy, Z, cmap=plt.cm.Paired)

def plot_samples(ax,x,y):

    '''

        绘制二维数据集

        :param ax:  Axes 实例,用于绘图

        :param x: 第一维特征

        :param y: 第二维特征

        :return: None

      '''

    n_classes = 3

    # 颜色数组。每个类别的样本使用一种颜色

    plot_colors = "bry"

    for i, color in zip(range(n_classes), plot_colors):

        idx = np.where(y == i)

        # 绘图

        ax.scatter(x[idx, 0], x[idx, 1], c=color,label=iris.target_names[i], cmap=plt.cm.Paired)

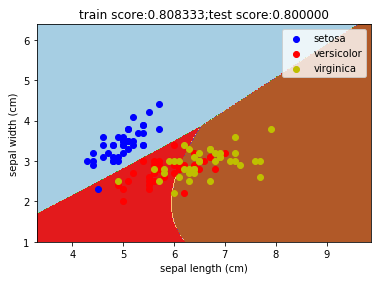
def mlpclassifier_iris():

    '''

    使用 MLPClassifier 预测调整后的 iris 数据集

    '''

    fig=plt.figure()

    ax=fig.add_subplot(1,1,1)

    classifier=MLPClassifier(activation='logistic',max_iter=10000,hidden_layer_sizes=(30,))

    classifier.fit(train_x,train_y)

    train_score=classifier.score(train_x,train_y)

    test_score=classifier.score(test_x,test_y)

    x_min, x_max = train_x[:, 0].min() - 1, train_x[:, 0].max() + 2

    y_min, y_max = train_x[:, 1].min() - 1, train_x[:, 1].max() + 2

    plot_classifier_predict_meshgrid(ax,classifier,x_min,x_max,y_min,y_max)

    plot_samples(ax,train_x,train_y)

    ax.legend(loc='best')

    ax.set_xlabel(iris.feature_names[0])

    ax.set_ylabel(iris.feature_names[1])

    ax.set_title("train score:%f;test score:%f"%(train_score,test_score))

    plt.show()

mlpclassifier_iris()
def mlpclassifier_iris_hidden_layer_sizes():

    '''

    使用 MLPClassifier 预测调整后的 iris 数据集。考察不同的 hidden_layer_sizes 的影响

    :return: None

    '''

    fig=plt.figure()

    # 候选的 hidden_layer_sizes 参数值组成的数组

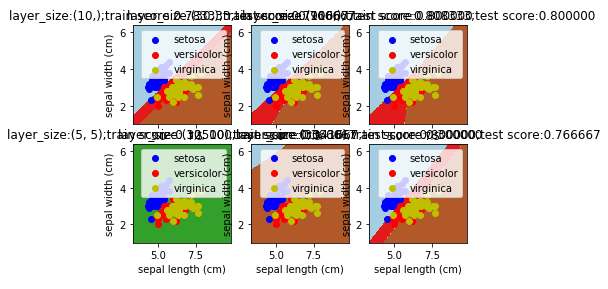
    hidden_layer_sizes=[(10,),(30,),(100,),(5,5),(10,10),(30,30)]

    for itx,size in enumerate(hidden_layer_sizes):

        ax=fig.add_subplot(2,3,itx+1)

        classifier=MLPClassifier(activation='logistic',max_iter=10000,hidden_layer_sizes=size)

        classifier.fit(train_x,train_y)

        train_score=classifier.score(train_x,train_y)

        test_score=classifier.score(test_x,test_y)

        x_min, x_max = train_x[:, 0].min() - 1, train_x[:, 0].max() + 2

        y_min, y_max = train_x[:, 1].min() - 1, train_x[:, 1].max() + 2

        plot_classifier_predict_meshgrid(ax,classifier,x_min,x_max,y_min,y_max)

        plot_samples(ax,train_x,train_y)

        ax.legend(loc='best')

        ax.set_xlabel(iris.feature_names[0])

        ax.set_ylabel(iris.feature_names[1])

        ax.set_title("layer_size:%s;train score:%f;test score:%f"%(size,train_score,test_score))

    plt.show()

mlpclassifier_iris_hidden_layer_sizes()
def mlpclassifier_iris_ativations():

    '''

    使用 MLPClassifier 预测调整后的 iris 数据集。考察不同的 activation 的影响

    '''

    fig=plt.figure()

    # 候选的激活函数字符串组成的列表

    ativations=["logistic","tanh","relu"]

    for itx,act in enumerate(ativations):

        ax=fig.add_subplot(1,3,itx+1)

        classifier=MLPClassifier(activation=act,max_iter=10000,hidden_layer_sizes=(30,))

        classifier.fit(train_x,train_y)

        train_score=classifier.score(train_x,train_y)

        test_score=classifier.score(test_x,test_y)

        x_min, x_max = train_x[:, 0].min() - 1, train_x[:, 0].max() + 2

        y_min, y_max = train_x[:, 1].min() - 1, train_x[:, 1].max() + 2

        plot_classifier_predict_meshgrid(ax,classifier,x_min,x_max,y_min,y_max)

        plot_samples(ax,train_x,train_y)

        ax.legend(loc='best')

        ax.set_xlabel(iris.feature_names[0])

        ax.set_ylabel(iris.feature_names[1])

        ax.set_title("activation:%s;train score:%f;test score:%f"%(act,train_score,test_score))

    plt.show()

mlpclassifier_iris_ativations()

def mlpclassifier_iris_algorithms():

    '''

    使用 MLPClassifier 预测调整后的 iris 数据集。考察不同的 algorithm 的影响

    :return: None

    '''

    fig=plt.figure()

    algorithms=["lbfgs","sgd","adam"] # 候选的算法字符串组成的列表

    for itx,algo in enumerate(algorithms):

        ax=fig.add_subplot(1,3,itx+1)

        classifier=MLPClassifier(activation="tanh",max_iter=10000,hidden_layer_sizes=(30,),solver=algo)

        classifier.fit(train_x,train_y)

        train_score=classifier.score(train_x,train_y)

        test_score=classifier.score(test_x,test_y)

        x_min, x_max = train_x[:, 0].min() - 1, train_x[:, 0].max() + 2

        y_min, y_max = train_x[:, 1].min() - 1, train_x[:, 1].max() + 2

        plot_classifier_predict_meshgrid(ax,classifier,x_min,x_max,y_min,y_max)

        plot_samples(ax,train_x,train_y)

        ax.legend(loc='best')

        ax.set_xlabel(iris.feature_names[0])

        ax.set_ylabel(iris.feature_names[1])

        ax.set_title("algorithm:%s;train score:%f;test score:%f"%(algo,train_score,test_score))

    plt.show()

mlpclassifier_iris_algorithms()

def mlpclassifier_iris_eta():

    '''

    使用 MLPClassifier 预测调整后的 iris 数据集。考察不同的学习率的影响

    '''

    fig=plt.figure()

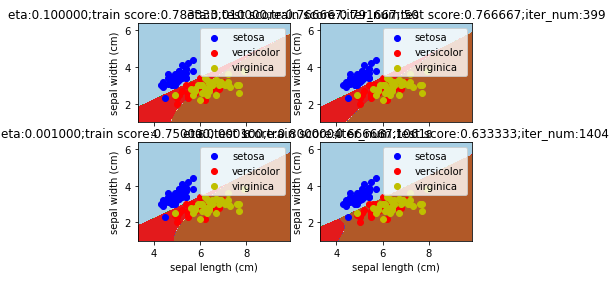
    etas=[0.1,0.01,0.001,0.0001] # 候选的学习率值组成的列表

    for itx,eta in enumerate(etas):

        ax=fig.add_subplot(2,2,itx+1)

        classifier=MLPClassifier(activation="tanh",max_iter=1000000,

        hidden_layer_sizes=(30,),solver='sgd',learning_rate_init=eta)

        classifier.fit(train_x,train_y)

        iter_num=classifier.n_iter_

        train_score=classifier.score(train_x,train_y)

        test_score=classifier.score(test_x,test_y)

        x_min, x_max = train_x[:, 0].min() - 1, train_x[:, 0].max() + 2

        y_min, y_max = train_x[:, 1].min() - 1, train_x[:, 1].max() + 2

        plot_classifier_predict_meshgrid(ax,classifier,x_min,x_max,y_min,y_max)

        plot_samples(ax,train_x,train_y)

        ax.legend(loc='best')

        ax.set_xlabel(iris.feature_names[0])

        ax.set_ylabel(iris.feature_names[1])

        ax.set_title("eta:%f;train score:%f;test score:%f;iter_num:%d"%(eta,train_score,test_score,iter_num))

    plt.show()

mlpclassifier_iris_eta()
吴裕雄 python 机器学习——人工神经网络感知机学习算法的应用的更多相关文章
- 吴裕雄 python 机器学习——人工神经网络与原始感知机模型
import numpy as np from matplotlib import pyplot as plt from mpl_toolkits.mplot3d import Axes3D from ...
- 吴裕雄 python 机器学习——数据预处理字典学习模型
from sklearn.decomposition import DictionaryLearning #数据预处理字典学习DictionaryLearning模型 def test_Diction ...
- 吴裕雄 python 机器学习——集成学习随机森林RandomForestRegressor回归模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 机器学习——集成学习随机森林RandomForestClassifier分类模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 机器学习——集成学习梯度提升决策树GradientBoostingRegressor回归模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 机器学习——集成学习AdaBoost算法回归模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 机器学习——集成学习AdaBoost算法分类模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 人工智能——基于神经网络算法在智能医疗诊断中的应用探索代码简要展示
#K-NN分类 import os import sys import time import operator import cx_Oracle import numpy as np import ...
- 吴裕雄 python 机器学习——分类决策树模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets from sklearn.model_s ...
随机推荐
- 推荐7个GitHub项目
CS-Notes https://github.com/CyC2018/CS-Notes 技术面试必备基础知识.Leetcode.计算机操作系统.计算机网络.系统设计.Java.Python.C++. ...
- eclipse中配置maven环境
一.配置setting.xml文件 1.首先将下载好的maven打开,打开文件夹,首先就需要对maven安装目录下有个config文件夹,在文件夹下有settings.xml文件.settings里面 ...
- 实用技巧之while里面使用getchar或sleep函数
我们经常需要打印一些变量的取值来调试程序,使用while(1)是常用的手段. ) { char letter = getchar(); printf("test_point is %d \t ...
- Laravel通过用户名和密码查询
一.如果要检查要验证的用户数据是否正确,可以使用: if (Auth::validate($credentials)) { // } 二.但是如果您想通过用户和密码从数据库中获取用户,您可以使用: / ...
- Java时间格式字符串与Date的相互转化
目录 将Date转化为格式化字符串 时间格式字符串转化为Date @ 将Date转化为格式化字符串 将Date转化为格式化字符串是利用SimpleDateFormat类继承自 java.text.Da ...
- JS高级---正则表达式练习身份证号码
写正则表达式, 根据字符串来写正则表达式进行匹配 经验: 1.找规律 2.不要追求完美 身份证的正则表达式 15位或者18位 ([1-9][0-9]{14})|([1-9][0-9]{16}[0 ...
- Mac 安装IDEA 2018.3 版本
注:本文转自https://blog.csdn.net/qq_41735004/article/details/86670039 写文文的目的是,怕博主删掉然后找不到所以就写一份 1.下载idea和破 ...
- CF div2 E. Water Balance
给你n个数,你可以这样操作:使区间[l,r]的数变成 他们的平均数,求字典序最小的序列. 做法:从左往右逐个比较,比较完之后会形成一个区间,一开始是区间为1的数进行比较,到后来会 变成区间较大的进行比 ...
- SDRAM中数据掩码的作用
DQM就是掩码控制位.在sdram中,每个DQM控制8bit Data在读操作的时候没什么大的影响,比如你读32位的sdram module, 但你只要其中低8bit的数据,没有关系,只要读出32bi ...
- Centos7搭建Apache2.4
我不多说废话了,相信在座的都应该明白怎么安装Apache2.4,我这才用yum源安装的,我个人认为这样安装的话,可以节省一些时间,有的网络不是很好,要等一段时间. 配置与Apache2.2的版本有点变 ...