
JAVA使用Gecco爬虫 抓取网页内容(附Demo)
JAVA 爬虫工具有挺多的,但是Gecco是一个挺轻量方便的工具。
先上项目结构图。
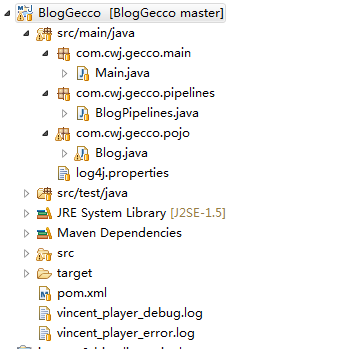
这是一个 JAVASE的 MAVEN 项目,要添加包依赖,其他就四个文件。log4j.properties 加上三个java类。
1、先配置log4j.properties
log4j.rootLogger=INFO,Console,File

log4j.appender.Console=org.apache.log4j.ConsoleAppender

log4j.appender.Console.Target=System.out

log4j.appender.Console.layout = org.apache.log4j.PatternLayout

log4j.appender.Console.layout.ConversionPattern=[%c] - %m%n

log4j.appender.File = org.apache.log4j.RollingFileAppender

log4j.appender.File.File = logs/ssm.log

log4j.appender.File.MaxFileSize = 10MB

log4j.appender.File.Threshold = ALL

log4j.appender.File.layout = org.apache.log4j.PatternLayout

log4j.appender.File.layout.ConversionPattern =[%p] [%d{yyyy-MM-dd HH\:mm\:ss}][%c]%m%n
2、接下来着手写Blog.java,里面都有注释 不解释
package com.cwj.gecco.pojo;

import com.geccocrawler.gecco.annotation.Gecco;

import com.geccocrawler.gecco.annotation.HtmlField;

import com.geccocrawler.gecco.annotation.Request;

import com.geccocrawler.gecco.request.HttpRequest;

import com.geccocrawler.gecco.spider.SpiderBean;

/**

 * @author cwj

 * 2017年8月6日

 * Blog实体类,运行主函数从这里开始解析

 * matchUrl:要抓包的目标地址

 * pipelines:跳转到下个pipelines

 */

@Gecco(matchUrl="http://www.cnblogs.com/boychen/p/7226831.html",pipelines="blogPipelines")

public class Blog implements SpiderBean{

    /**

     * 向指定URL发送GET方法的请求

     */

    @Request

    private HttpRequest request;

    /**

     * 抓去这个路径下所有的内容

     */

    @HtmlField(cssPath = "body div#cnblogs_post_body")

    private String content;

    public HttpRequest getRequest() {

        return request;

    }

    public void setRequest(HttpRequest request) {

        this.request = request;

    }

    public String getContent() {

        return content;

    }

    public void setContent(String content) {

        this.content = content;

    }

}
3、BlogPipelines.java
package com.cwj.gecco.pipelines;

import com.cwj.gecco.pojo.Blog;

import com.geccocrawler.gecco.annotation.PipelineName;

import com.geccocrawler.gecco.pipeline.Pipeline;

/**

 * @author cwj

 * 2017年8月6日

 * 运行完Blog.java 根据@PipelineName 来这里

 */

@PipelineName(value="blogPipelines")

public class BlogPipelines implements Pipeline<Blog>{

    /**

     * 将抓取到的内容进行处理  这里是打印在控制台

     */

    public void process(Blog blog) {

        System.out.println(blog.getContent());

    }

}
4、最后便是在main中调用
package com.cwj.gecco.main;

import com.geccocrawler.gecco.GeccoEngine;

public class Main {

    public static void main(String[] args) {

         GeccoEngine.create()

            //工程的包路径

            .classpath("com.cwj.gecco")

            //开始抓取的页面地址

            .start("http://www.cnblogs.com/boychen/p/7226831.html")

            //开启几个爬虫线程

            .thread(10)

            //单个爬虫每次抓取完一个请求后的间隔时间

            .interval(5)

            //使用pc端userAgent

            .mobile(false)

            //开始运行

            .run();

    }

}
5、抓取到内容,日志文件被我删除 有警告
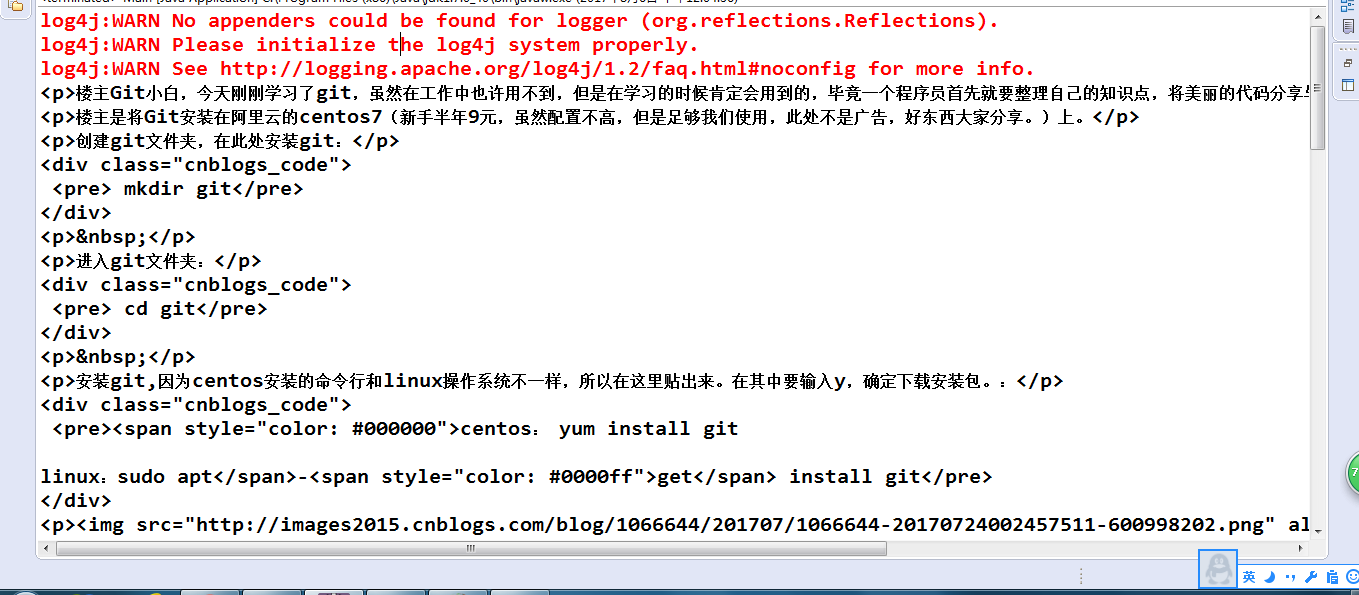
附上源码地址 https://github.com/BeautifulMeet/Gecco
JAVA使用Gecco爬虫 抓取网页内容(附Demo)的更多相关文章
- Java豆瓣电影爬虫——抓取电影详情和电影短评数据
一直想做个这样的爬虫:定制自己的种子,爬取想要的数据,做点力所能及的小分析.正好,这段时间宝宝出生,一边陪宝宝和宝妈,一边把自己做的这个豆瓣电影爬虫的数据采集部分跑起来.现在做一个概要的介绍和演示. ...
- PHP爬虫抓取网页内容 (simple_html_dom.php)
使用simple_html_dom.php,下载|文档 因为抓取的只是一个网页,所以比较简单,整个网站的下次再研究,可能用Python来做爬虫会好些. <meta http-equiv=&quo ...
- paip.抓取网页内容--java php python
paip.抓取网页内容--java php python.txt 作者Attilax 艾龙, EMAIL:1466519819@qq.com 来源:attilax的专栏 地址:http://blog ...
- Java 实现 HttpClients+jsoup,Jsoup,htmlunit,Headless Chrome 爬虫抓取数据
最近整理一下手头上搞过的一些爬虫,有HttpClients+jsoup,Jsoup,htmlunit,HeadlessChrome 一,HttpClients+jsoup,这是第一代比较low,很快就 ...
- 爬虫学习一系列:urllib2抓取网页内容
爬虫学习一系列:urllib2抓取网页内容 所谓网页抓取,就是把URL地址中指定的网络资源从网络中读取出来,保存到本地.我们平时在浏览器中通过网址浏览网页,只不过我们看到的是解析过的页面效果,而通过程 ...
- 爬虫技术 -- 进阶学习(七)简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码...算是一份测试版的代码.大牛大神别喷... 通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配. List<string&g ...
- 爬虫技术(四)-- 简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码...算是一份测试版的代码.大牛大神别喷... 通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配. List<string&g ...
- 使用Jsoup函数包抓取网页内容
之前写过一篇用Java抓取网页内容的文章,当时是用url.openStream()函数创建一个流,然后用BufferedReader把这个inputstream读取进来.抓取的结果是一整个字符串.如果 ...
- c#抓取网页内容乱码的解决方案
写过爬虫的同学都知道,这是个很常见的问题了,一般处理思路是: 使用HttpWebRequest发送请求,HttpWebResponse来接收,判断HttpWebResponse中”Content-Ty ...
随机推荐
- 反爬虫破解系列-汽车之家利用css样式替换文字破解方法
网站: 汽车之家:http://club.autohome.com.cn/ 以论坛为例 反爬虫措施: 在论坛发布的贴子正文中随机抽取某几个字使用span标签代替,标签内容位空,但css样式显示为所代替 ...
- How Many Tables HDOJ
How Many Tables Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)T ...
- WebApi使用JWT认证(一)
这是第一部:先实现NetFramework上的WebApi使用JWT认证 1.VS新建一个WebApi项目 2.项目右键----管理Nuget程序包----找到JWT,然后安装 3.Model文件夹下 ...
- DevOps Workshop 研发运维一体化(北京第二场) 2016.04.27
北京不亏为首都,人才济济,对微软DevOps解决方案感兴趣的人太多.我们与微软公司临时决定再家一场培训. 我之前在博客中(DevOps Workshop 研发运维一体化第一场(微软亚太研发集团总部)h ...
- 数组序列化serialize
1,数据在网络中是以字符串形式传输,这样如果传输的是数组,首先将数组内容拼接成字符串进行发送,接收方拿到字符串,没法将其还原为数组.因此在网络传输的时候,为了保证数据类型的不丢失,先序列化,再发送. ...
- mybatis中单个参数的引用
单个参数时在test条件中不能用参数名来引用,可以使用_parameter
- libevent源码剖析
libevent是一个使用C语言编写的,轻量级的开源高性能网络库,使用者很多,研究者也很多.由于代码简洁,设计思想简明巧妙,因此很适合用来学习,提升自己C语言的能力. libevent有这样显著地几个 ...
- jvm高级特性(6)(线程的种类,调度,状态,安全程度,实现安全的方法,同步种类,锁优化,锁种类)
JVM高级特性与实践(十三):线程实现 与 Java线程调度 JVM高级特性与实践(十四):线程安全 与 锁优化 一. 线程的实现 线程其实是比进程更轻量级的调度执行单位. 线程的引入,可以把一个检查 ...
- java对象的结构
[Java对象解析]不得不了解的对象头 一个Java对象到底占用多大内存? JVM源码分析之java对象头实现 java对象在内存中的结构(转帖) 一个Java对象到底占多大内存? 在Hotspot ...
- JMeter基础:请求参数Parameters 、Body Data的区别
使用Jmeter测试时,很多人不知道请求参数Parameters .Body Data的区别和用途,这里简单介绍下 先了解一个接口的基本概念 在客户机和服务器之间进行请求-响应时,HTTP协议中包括G ...