
【爬虫】一次爬取某瓣top电影前250的学习记录
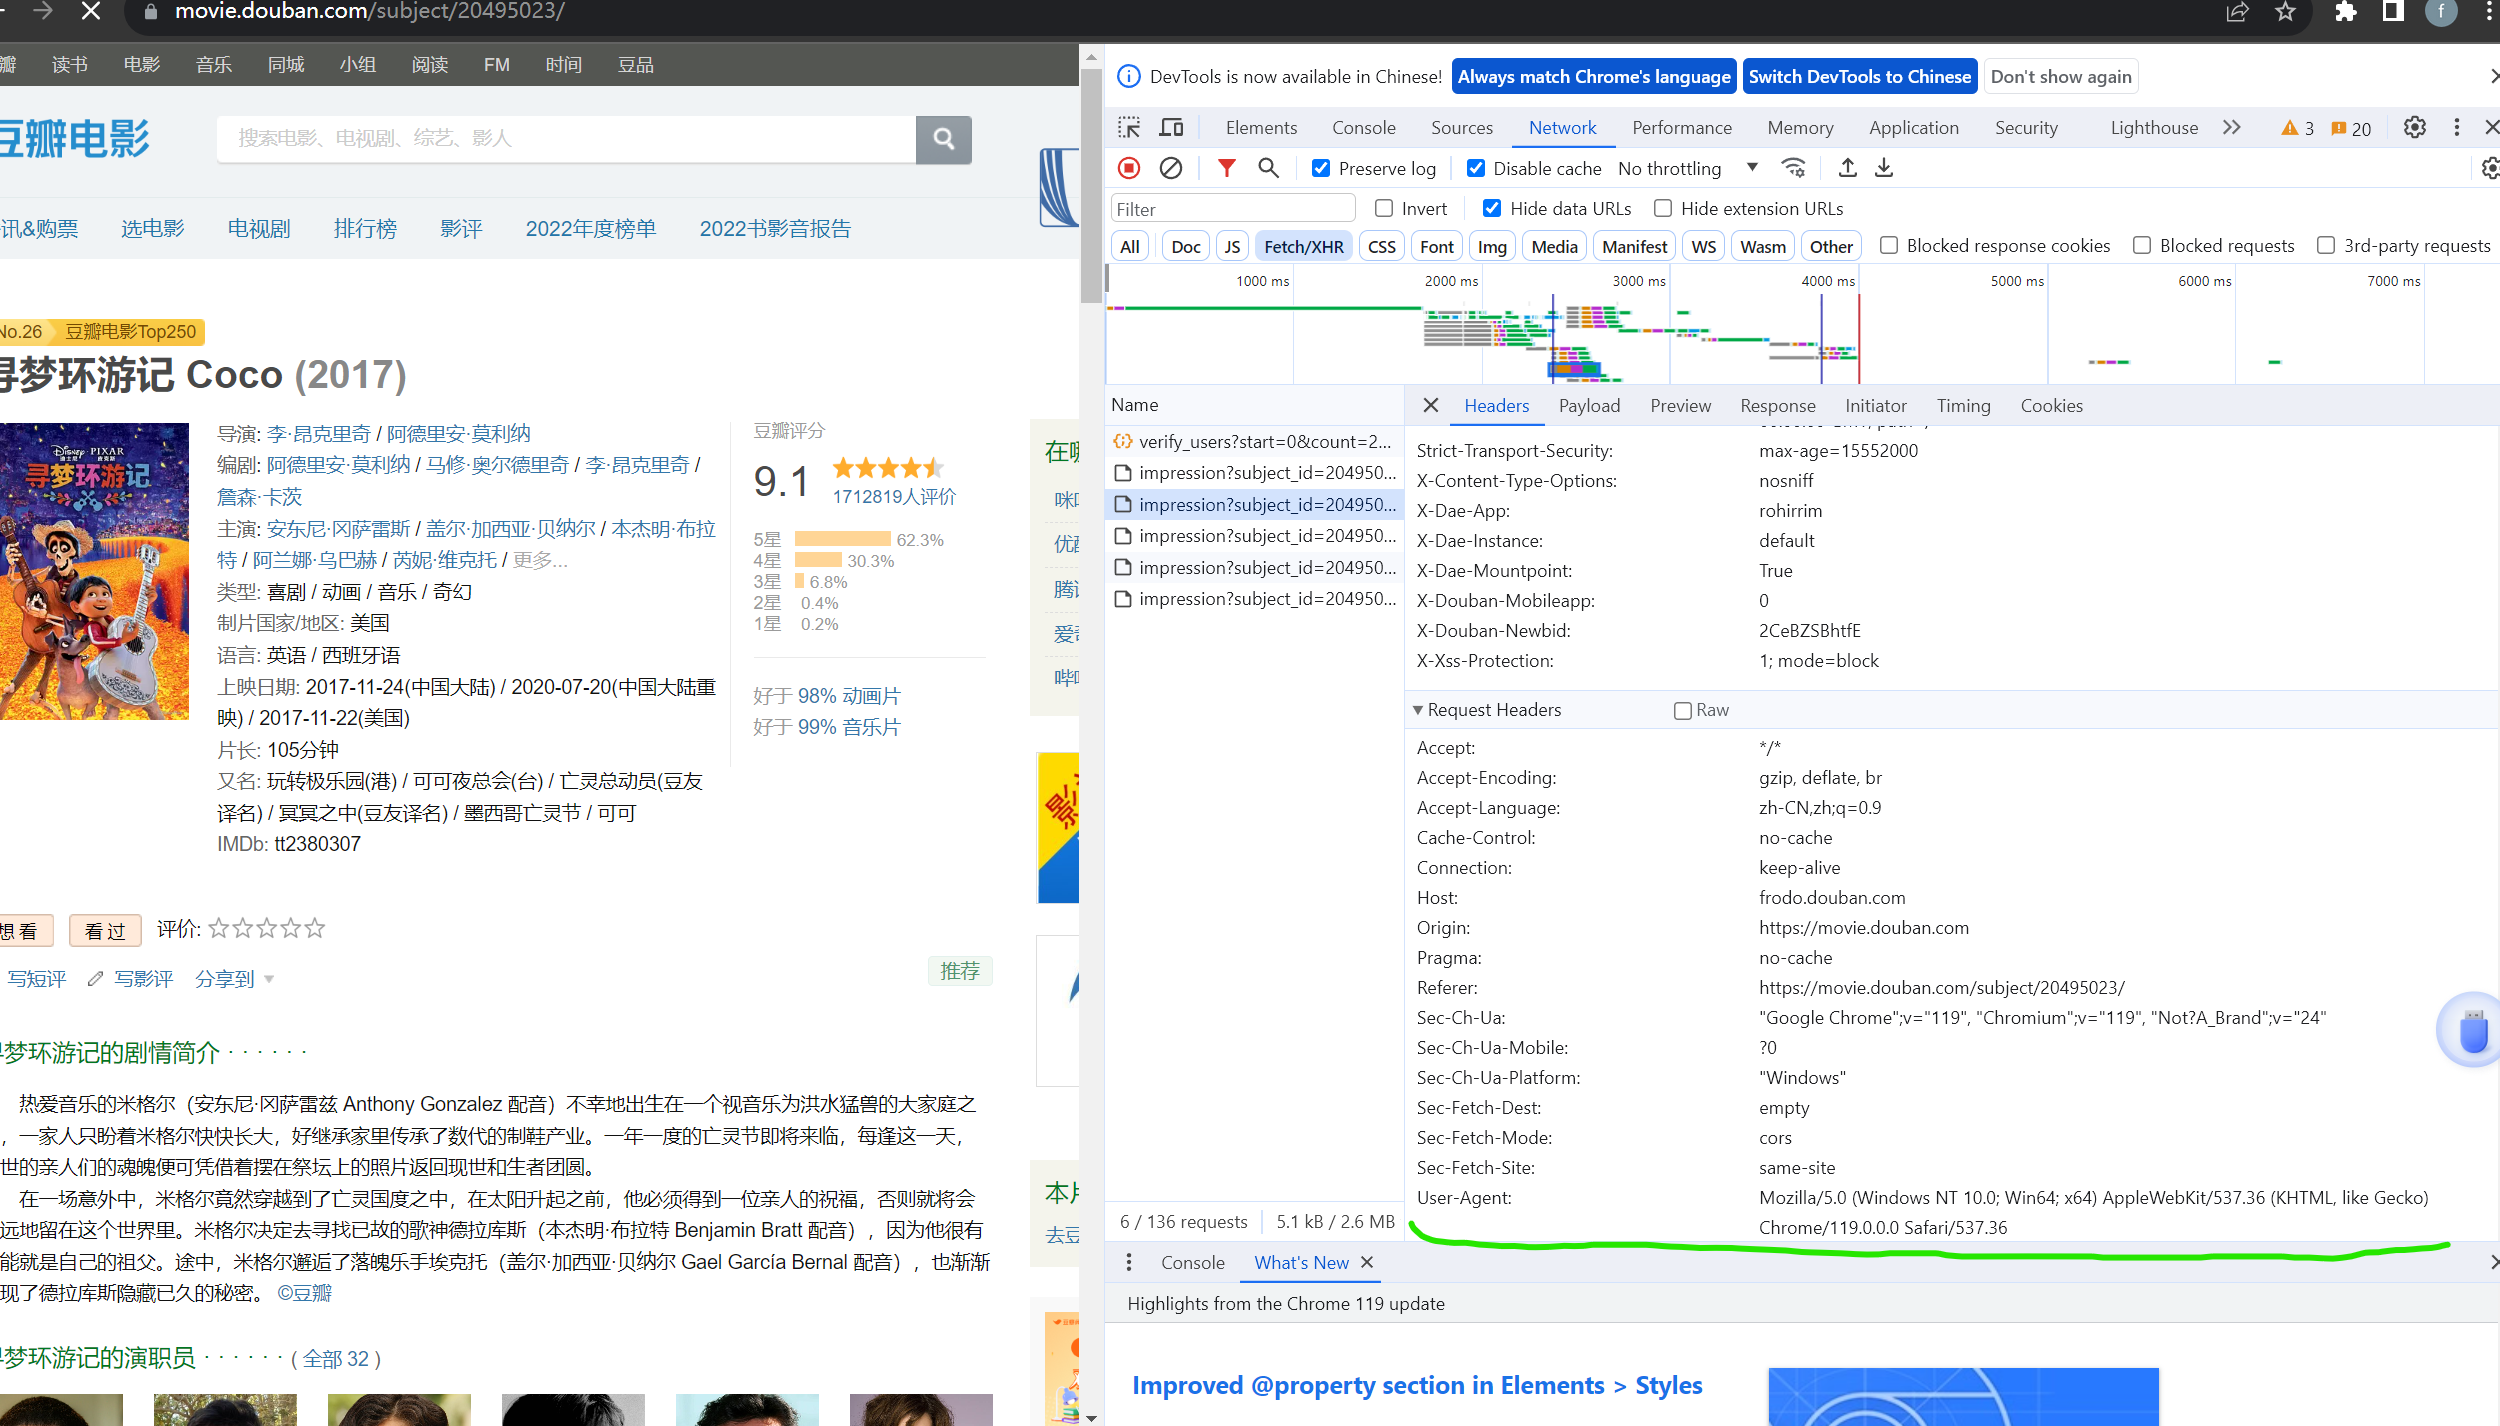
该请求头随意修改就行,合理就行
【爬虫】一次爬取某瓣top电影前250的学习记录的更多相关文章
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- python爬虫08 | 你的第二个爬虫,要过年了,爬取豆瓣最受欢迎的250部电影慢慢看
马上就要过年啦 过年在家干啥咧 准备好被七大姑八大姨轮番「轰炸」了没? 你的内心 os 是这样的 但实际上你是这样的 应付完之后 闲暇时刻不妨看看电影 接下来咱们就来爬取豆瓣上评分最高的 250部电影 ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- python定时器爬取豆瓣音乐Top榜歌名
python定时器爬取豆瓣音乐Top榜歌名 作者:vpoet mail:vpoet_sir@163.com 注:这些小demo都是前段时间为了学python写的,现在贴出来纯粹是为了和大家分享一下 # ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- 爬虫实战——Scrapy爬取伯乐在线所有文章
Scrapy简单介绍及爬取伯乐在线所有文章 一.简说安装相关环境及依赖包 1.安装Python(2或3都行,我这里用的是3) 2.虚拟环境搭建: 依赖包:virtualenv,virtualenvwr ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
随机推荐
- C语言指针--一级指针
文章目录 前言 一.什么是指针 二.一级指针的使用 1.一级指针的创建 2.指针的赋值 3.&是什么 4.一维指针的使用 4.1 `变量` 和 `*变量` 4.2 输出指针变量内容 4.3 改 ...
- 【技术积累】HTML+CSS+JavaScript中的基础知识【一】
HTML基础标签 <html> 定义HTML文档的根元素. <!DOCTYPE html> <html> <head> <title>My ...
- ROS的通信机制
通信机制 节点--执行单元 执行具体任务的进程.独立运行的可执行文件: 不同节点可以使用不同的编程语言,可分布式运行在不同的主机上. 节点在系统中的名称是必须是唯一的. 节点管理器(ROS Maste ...
- windows内核情景分析-毛德操(第一章)
微内核操作系统的特点内核尽量缩小 windows内核包括了两大部分 操作系统内核(ntoskrnl.exe),另一部分则是迁移到了内核中即系统空间中的视窗服务(win32k.sys) 用户空间和系统空 ...
- MyBatis(log4j)
log4j介绍 Log4j是Apache的一个开源项目,通过使用Log4j,我们可以控制日志信息输送的目的地是控制台.文件.GUI组件,甚至是套接口服务器.NT的事件记录器.UNIX Syslog守护 ...
- 学习 YAML 语法
符号 意义 备注 - 表示数组 数组也叫序列 # 表示注释 只支持单行注释 空格缩进 表示层级关系 相同层级左侧必须对齐 --- 表示一份内容的开始 ... 表示一份内容的结束 可省略 : 表示键值对 ...
- 【算法】单调栈 & 单调队列学习笔记
1. 单调栈简介 1.1 前言 今天是 2023/1/15,一中寒假集训阶段性的结束了.集训的学习笔记可以在本人 blogs 的[算法]标签栏中找. 马上就要过年了,提前祝大家新年快乐! 1.2 什么 ...
- pentaho(keetle)数据同步实践
pentaho(keetle)数据同步实践 1 pentaho简介 pentaho可读作"彭塔湖",在keetle被pentaho公司收购后改名而来. pentaho是一款开源ET ...
- Unity UGUI的Slider(滑动条)件组的介绍及使用
Unity UGUI的Slider(滑动条)件组的介绍及使用 1. 什么是Slider组件? Slider(滑动条)是Unity UGUI中的一种常用UI组件用,于在用户界面中实现滑动选择的功能.通过 ...
- 【Bash】rm -r 与 rmdir 区别
目录 背景 二者区别 rmdir rm -r rm -rf 测试过程 配置环境 rmdir rm -r rm -rf 参考资料 背景 今天学弟在使用 NVMe-over-TCP 时发现无法卸载 nvm ...