
四十二 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想要操作多条数据就会产生多次请求,所以就有了mget和bulk批量操作,mget和bulk批量操作是一次请求可以操作多条数据
1、mget批量操作(查询)
批量操作(同一个索引同一个表里的批量查询)
说明:

#mget批量操作(同一个表里的批量查询)

GET _mget

{

  "docs":[

    {

      "_index":"索引名称",

      "_type":"表名称",

      "_id":id号

    },

    {

      "_index":"索引名称",

      "_type":"表名称",

      "_id":id号

    }

    ]

}
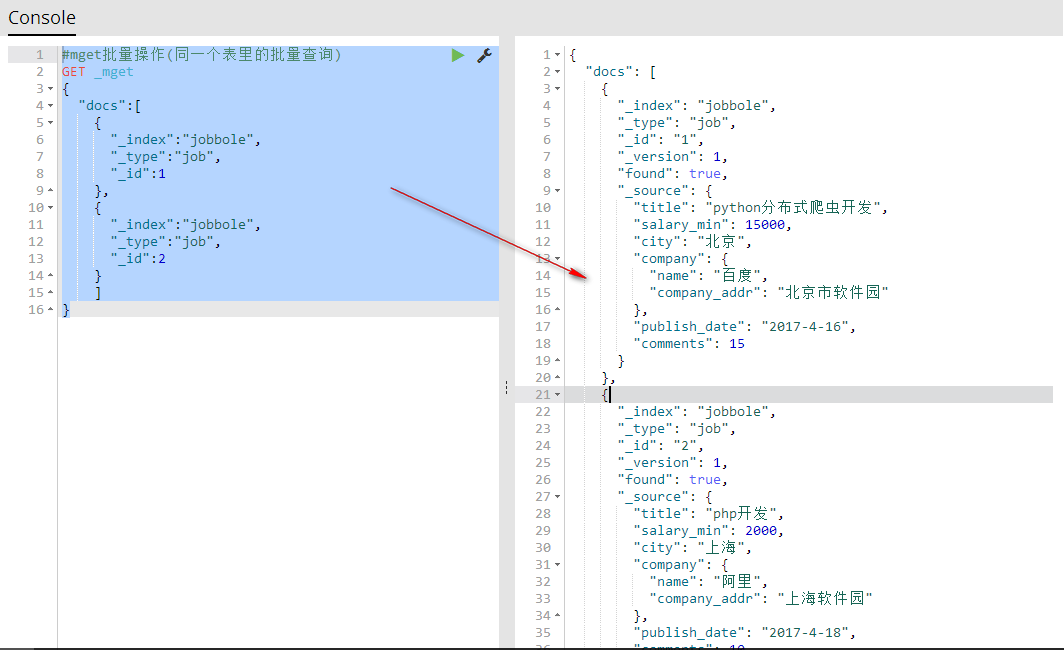
代码:
#mget批量操作(同一个表里的批量查询)

GET _mget

{

  "docs":[

    {

      "_index":"jobbole",

      "_type":"job",

      "_id":1

    },

    {

      "_index":"jobbole",

      "_type":"job",

      "_id":2

    }

    ]

}
批量操作(同一个索引同一个表里的不同id批量查询)
#批量操作(同一个索引同一个表里的不同id批量查询)

GET jobbole/job/_mget

{

  "ids":[1,2]

}
批量操作(同一个索引不同表里的批量查询)
#mget批量操作(同一个索引不同表里的批量查询)

GET jobbole/_mget

{

  "docs":[

    {

      "_type":"job",

      "_id":1

    },

    {

      "_type":"job2",

      "_id":1

    }

    ]

}
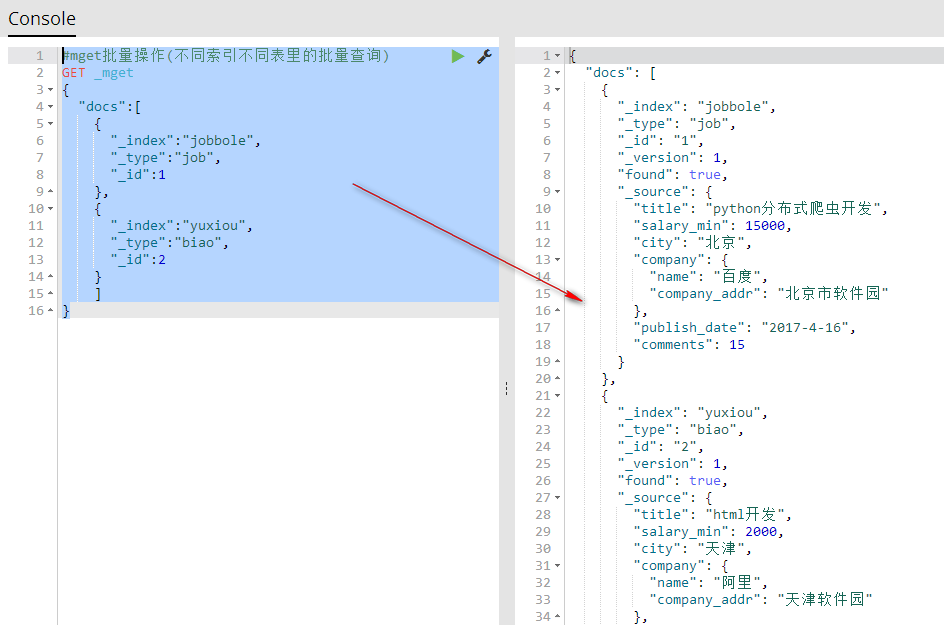
批量操作(不同索引不同表里的批量查询,相当于数据库的组合查询)
#mget批量操作(不同索引不同表里的批量查询)

GET _mget

{

  "docs":[

    {

      "_index":"jobbole",

      "_type":"job",

      "_id":1

    },

    {

      "_index":"yuxiou",

      "_type":"biao",

      "_id":2

    }

    ]

}
2、bulk批量操作(增删改)
批量导入可以合并多个操作,比如index,delete,update,create等等。也可以帮助从一个索引导入到另一个索引

bulk批量操作批量添加数据
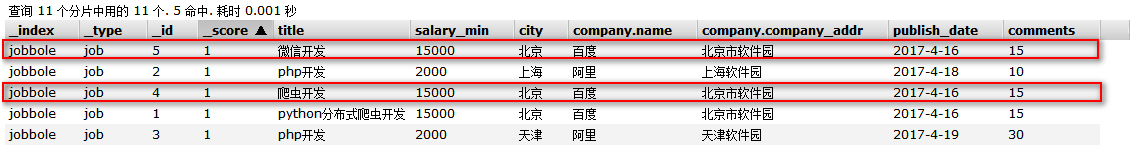
说明:添加一条数据由两行代码实现,第一行设置添加数据的索引名称、表、id,第二行设置添加数据的字段和值
#_bulk批量添加数据

POST _bulk

#设置添加数据的索引名称、表、id

{"index":{"_index":"jobbole","_type":"job","_id":"4"}}

#设置添加数据的字段和值

{"title": "爬虫开发","salary_min": 15000,"city": "北京","company": {"name": "百度","company_addr": "北京市软件园"},"publish_date": "2017-4-16","comments": 15}

#设置添加数据的索引名称、表、id

{"index":{"_index":"jobbole","_type":"job","_id":"5"}}

#设置添加数据的字段和值

{"title": "微信开发","salary_min": 15000,"city": "北京","company": {"name": "百度","company_addr": "北京市软件园"},"publish_date": "2017-4-16","comments": 15}
代码:
POST _bulk

{"index":{"_index":"jobbole","_type":"job","_id":"4"}}

{"title": "爬虫开发","salary_min": 15000,"city": "北京","company": {"name": "百度","company_addr": "北京市软件园"},"publish_date": "2017-4-16","comments": 15}

{"index":{"_index":"jobbole","_type":"job","_id":"5"}}

{"title": "微信开发","salary_min": 15000,"city": "北京","company": {"name": "百度","company_addr": "北京市软件园"},"publish_date": "2017-4-16","comments": 15}
bulk批量操作批量创建数据(添加)
POST _bulk

{"create":{"_index":"jobbole","_type":"job","_id":"6"}}

{"title": "开发","salary_min": 100,"city": "北京","company": {"name": "百度","company_addr": "北京市软件园"},"publish_date": "2017-4-16","comments": 15}
bulk批量操作批量删除数据
POST _bulk

{"delete":{"_index":"jobbole","_type":"job","_id":"5"}}

{"delete":{"_index":"jobbole","_type":"job","_id":"6"}}
bulk批量操作批量修改数据
POST _bulk

{"update":{"_index":"jobbole","_type":"job","_id":"1"}}

{"doc":{"title": "开发","salary_min": 100,"city": "北京","company": {"name": "百度","company_addr": "北京市软件园"},"publish_date": "2017-4-16","comments": 15}}
四十二 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作的更多相关文章
- 第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理
第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理 1.映射(mapping)介绍 映射:创建索引的时候,可以预先定义字 ...
- 第三百七十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索结果分页
第三百七十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索结果分页 逻辑处理函数 计算搜索耗时 在开始搜索前:start_time ...
- 第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能
第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能 Django实现搜索功能 1.在Django配置搜索结果页的路由映 ...
- 第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询
第三百六十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的bool组合查询 bool查询说明 filter:[],字段的过滤,不参与打分must:[] ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作
第三百六十三节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mget和bulk批量操作 注意:前面讲到的各种操作都是一次http请求操作一条数据,如果想 ...
- 第三百六十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本概念
第三百六十节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本概念 elasticsearch的基本概念 1.集群:一个或者多个节点组织在一起 2.节点 ...
- 第三百五十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)介绍以及安装
第三百五十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)介绍以及安装 elasticsearch(搜索引擎)介绍 ElasticSearch是一个基于 ...
- 五十 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门搜索
第三百七十一节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现我的搜索以及热门 我的搜素简单实现原理我们可以用js来实现,首先用js获取到 ...
随机推荐
- 2015-03-10——简析javascript对象
对于构造函数,它是Function对象的一个实例,可以定义自己的静态成员先实例化出对象,后执行function中内部代码 静态成员: var abc = function () {}; //既是一 ...
- 洛谷 P2233 [HNOI]公交车线路
洛谷 不知道大家做没做过传球游戏,这一题和传球游戏的转移方程几乎一样. 令\(A\)为\(1\)点,\(E\)为\(5\)点,那么\(f[i][j]\)代表第i步走到j的方案数. \[f[i][j]= ...
- STL中使用reverse_iterator时,如何正确使用erase函数
假设有一个list容器,顺序存储了0-9一个10个整数.现在要使用reverse_iterator迭代器来查找值为8和5的元素,并且将这两个数删除.先来看以下的解决方法: #include <i ...
- 前端基础-css(1)
一.css的引入方式 现在的互联网前端分三层: HTML:超文本标记语言.从语义的角度描述页面结构. CSS:层叠样式表.从审美的角度负责页面样式. JS:JavaScript .从交互的角度描述页面 ...
- 解释一下python中的赋值运算符
我们将所有的算术运算符和赋值运算符号放在一起展示 a=7 a+=1 print(a) a-=1 print(a) a*=2 print(a) a/=2 print(a) a**=2 print(a) ...
- CWinApp类CMultiDocTemplate类CDocument类CView类的关系
转自:http://blog.csdn.net/bboot/article/details/26884011 不得不转,瞬间搞清了很多问题,短小精悍 1.CWinApp类 它包含并管理着应用程序的 ...
- svn如何给新文件加锁
第一步: 右键subversion(版本控制) 第二部:找到 subversion properties 第二部: add进行添加
- php操作redis cluster集群成功实例
java操作redis cluster集群可使用jredis php要操作redis cluster集群有两种方式: 1.使用phpredis扩展,这是个c扩展,性能更高,但是phpredis2.x扩 ...
- Oracle数据类型(4)
字符类型: CHAR(size):固定长度字符串,最大长度2000 bytes VARCHAR2(size):可变长度的字符串,最大长度4000 bytes,可做索引的最大长度749 NCHAR(si ...
- API接口幂等性框架设计
表单重复提价问题 rpc远程调用时候 发生网络延迟 可能有重试机制 MQ消费者幂等(保证唯一)一样 解决方案: token 令牌 保证唯一的并且是临时的 过一段时间失效 分布式: redis+to ...