
Python 爬取美团酒店信息
事由:近期和朋友聊天,聊到黄山酒店事情,需要了解一下黄山的酒店情况,然后就想着用python 爬一些数据出来,做个参考
主要思路:通过查找,基本思路清晰,目标明确,仅仅爬取美团莫一地区的酒店信息,不过于复杂,先完成一个小目标
环境:
python 3.6
主要问题:
1. 在爬取美团黄山酒店第一页后,顺利拿到想要的信息,但在点击第二页后,chrome中检查信息能够看见想要的信息,但是查看源代码却没有,思考后,应该是Ajax动态获取的,然后查找办法,最终通过selenium模拟浏览器,然后进行爬取
2. 标签查找,通过chrome进行分析整体网站标签信息后,对某一个标签的class未清楚认识,导致错误认识,消耗比较长的调试时间
代码如下:
import requests

from bs4 import BeautifulSoup

from selenium import webdriver

from selenium.webdriver.common.desired_capabilities import DesiredCapabilities

import xlwt

url = 'http://hotel.meituan.com/huangshan/'

#获取酒店分页信息,返回最大页码

def get_page_num(url):

    html = requests.get(url).text

    soup = BeautifulSoup(html,'lxml')

    page_info = soup.find_all('li',class_='page-link')      #获取酒店首页的页面导航条信息

    page_num = page_info[-1].find('a').get_text()           #获取酒店页面的总页数

    return int(page_num)                                        #返回酒店页面的总页数

#获取所有酒店详细信息,包含酒店名称,链接,地址,评分,消费人数,价格,上次预定时间

def get_hotel_info(url):

    dcap = dict(DesiredCapabilities.PHANTOMJS)

    dcap['phantomjs.page.settings.userAgent'] = ('Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36')    #设置userAgent,可以从浏览器中找到,用于反爬虫禁止IP

    browser = webdriver.PhantomJS("/Users/chenglv/phantomjs-2.1.1-macosx/bin/phantomjs", desired_capabilities=dcap)         #指定phantomjs程序路径

    browser.get(url)

    hotel_info = {}

    hotel_id = ['酒店名','网址','酒店地址','评价','消费人数','价格','上次预约时间']

    col_num = 1

    page_num = 1

    book = xlwt.Workbook(encoding='utf-8',style_compression=0)          #创建excel文件

    sheet = book.add_sheet('hotel_info',cell_overwrite_ok=True)         #创建excel sheet表单

    for i in range(len(hotel_id)):      #写入表单第一行,即列名称

        sheet.write(0,i,hotel_id[i])    #excel中写入第一行列名

    while(page_num < get_page_num(url)+1):

        #获取一个页面的所有酒店信息

        for item in browser.find_elements_by_class_name('info-wrapper'):

            hotel_info['name'] = item.find_element_by_class_name('poi-title').text

            hotel_info['link'] = item.find_element_by_class_name('poi-title').get_attribute('href')

            hotel_info['address'] = item.find_element_by_class_name('poi-address').text.split(' ')[1]

            hotel_info['star'] = item.find_element_by_class_name('poi-grade').text

            hotel_info['consumers'] = item.find_element_by_class_name('poi-buy-num').text

            hotel_info['price'] = item.find_element_by_class_name('poi-price').text

            hotel_info['last_order_time'] = item.find_element_by_class_name('last-order-time').text

            #将当前页面中的酒店信息获取到后,写入excel的行中

            for i in range(len(hotel_info.values())):

                sheet.write(col_num,i,list(hotel_info.values())[i])

            col_num+=1

        browser.find_element_by_class_name('paginator').find_element_by_class_name('next').find_element_by_tag_name('a').click()        #一个页面写完后,通过点击"下一页"图标至下一页,继续获取

        page_num += 1

    book.save('hotel_info_huangshan.csv')

def main():

    get_hotel_info(url)

if '__main__' == __name__:

    main()
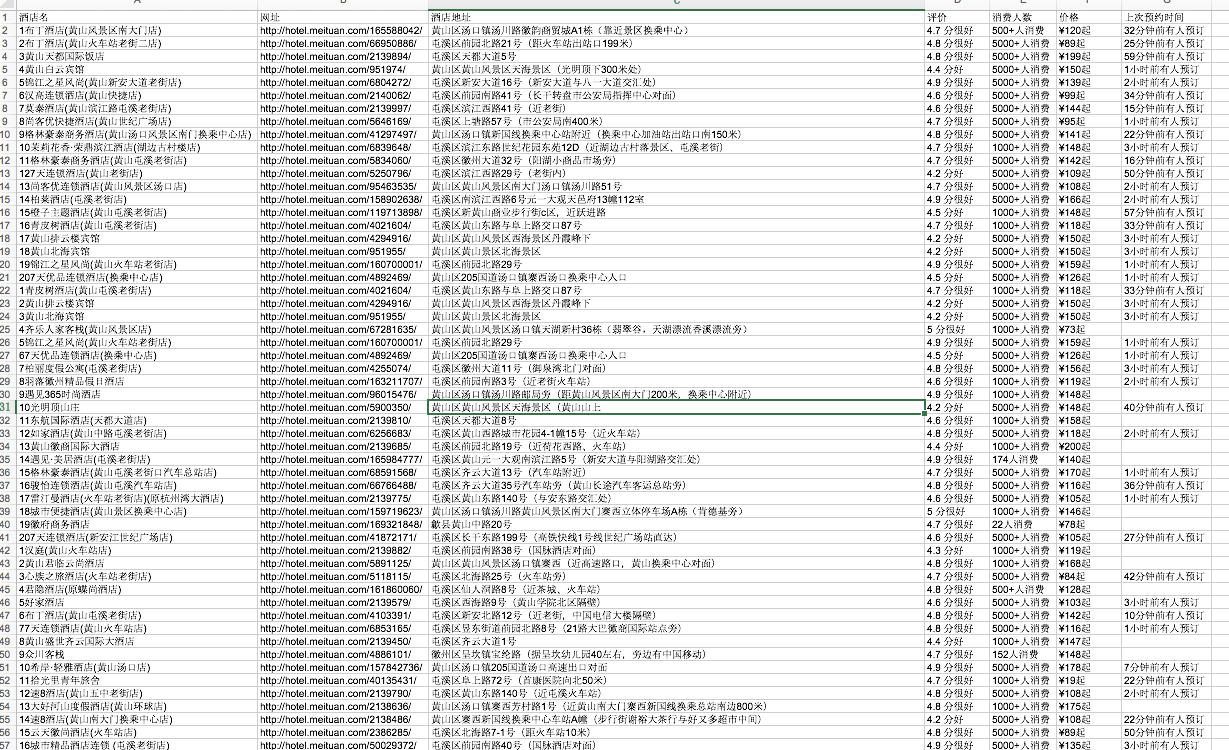
运行后结果如下图:
此部分仅因兴趣编写,还有很多未考虑,后期可以进行多层爬取,以及爬取更多的内容。
Python 爬取美团酒店信息的更多相关文章
- python爬取“美团美食”汕头地区的所有店铺信息
一.目的 获取美团美食每个店铺所有的评论信息,并保存到数据库和本地 二.实现步骤 获取所有店铺的poiId 首先观察详情页的url,后面是跟着一串数字的,而这一串数字代表着每个店铺特有的id号,我们称 ...
- Python爬取拉勾网招聘信息并写入Excel
这个是我想爬取的链接:http://www.lagou.com/zhaopin/Python/?labelWords=label 页面显示如下: 在Chrome浏览器中审查元素,找到对应的链接: 然后 ...
- python爬取豆瓣视频信息代码
目录 一:代码 二:结果如下(部分例子) 这里是爬取豆瓣视频信息,用pyquery库(jquery的python库). 一:代码 from urllib.request import quote ...
- 使用python抓取美团商家信息
抓取美团商家信息 import requests from bs4 import BeautifulSoup import json url = 'http://bj.meituan.com/' ur ...
- python 爬取豆瓣书籍信息
继爬取 猫眼电影TOP100榜单 之后,再来爬一下豆瓣的书籍信息(主要是书的信息,评分及占比,评论并未爬取).原创,转载请联系我. 需求:爬取豆瓣某类型标签下的所有书籍的详细信息及评分 语言:pyth ...
- python爬取梦幻西游召唤兽资质信息(不包含变异)
一.分析 1.爬取网站:https://xyq.163.com/chongwu/ 2.获取网页源码: request.get("https://xyq.163.com/chongwu/&qu ...
- python 爬取bilibili 视频信息
抓包时发现子菜单请求数据时一般需要rid,但的确存在一些如游戏->游戏赛事不使用rid,对于这种未进行处理,此外rid一般在主菜单的响应中,但有的如番剧这种,rid在子菜单的url中,此外返回的 ...
- python爬取网业信息案例
需求:爬取网站上的公司信息 代码如下: import json import os import shutil import requests import re import time reques ...
- python爬取电影网站信息
一.爬取前提1)本地安装了mysql数据库 5.6版本2)安装了Python 2.7 二.爬取内容 电影名称.电影简介.电影图片.电影下载链接 三.爬取逻辑1)进入电影网列表页, 针对列表的html内 ...
随机推荐
- Android初级教程理论知识(第二章布局&读写文件)
常见布局 相对布局 RelativeLayout 组件默认左对齐.顶部对齐 设置组件在指定组件的右边 android:layout_toRightOf="@id/tv1" 设置在指 ...
- Unity UGUI基础之Slider、Scrollbar
Slider(滑动条):是一个主要用于形象的拖动以改变目标值的控件,他的最恰当应用是用来改变一个数值,最大值和最小值自定义,拖动滑块可在此之间改变,例如改变声音大小. Scrollbar(滚动条):是 ...
- ROS_Kinetic_19 群机器人框架示例(micros swarm framework)
ROS_Kinetic_19 群机器人框架示例(micros swarm framework) 官方网址:http://wiki.ros.org/micros_swarm_framework 这个包是 ...
- UNIX环境高级编程——信号(API)
一.信号在内核中的表示 实际执行信号的处理动作称为信号递达(Delivery),信号从产生到递达之间的状态,称为信号未决(Pending).进程可以选择阻塞(Block)某个信号.被阻塞的信号 ...
- Socket层实现系列 — 信号驱动的异步等待
主要内容:Socket的异步通知机制. 内核版本:3.15.2 我的博客:http://blog.csdn.net/zhangskd 概述 socket上定义了几个IO事件:状态改变事件.有数据可读事 ...
- (NO.00002)iOS游戏精灵战争雏形(七)
接上一篇博文,我们继续完成射击的功能. 还是在MainScene.m中,添加initBullets方法: -(void)initBullets{ CCSprite *bullet; for (int ...
- Leetcode_8_String to Integer
本文是在学习中的总结,欢迎转载但请注明出处:http://blog.csdn.net/pistolove/article/details/41521063 Implement atoi to conv ...
- 小强的HTML5移动开发之路(1)——HTML介绍
来自:http://blog.csdn.net/dawanganban/article/details/17591373 HTML是HyperText Markup Language(超文本标记语言) ...
- (七)大图展示Demo引出的UIScrollView的使用
UIScrollView是一个能够滚动的视图控件,可以通过滚动查看所有内容. 用途: 1.一张大图屏幕放不下,可以用各个方向的手势来看大图的各个部分. 2.手机的设置页面有很多的选项,需要上下滚动来查 ...
- (视频) 《快速创建网站》 3.2 WordPress多站点及Azure在线编辑器 - 扔掉你的ftp工具吧,修改代码全部云端搞定
本文是<快速创建网站>系列的第6篇,如果你还没有看过之前的内容,建议你点击以下目录中的章节先阅读其他内容再回到本文. 1. 网站管理平台WordPress和云计算平台Azure简介 (6分 ...