
Python 爬虫练手项目—酒店信息爬取
from bs4 import BeautifulSoup

import requests

import time

import re

url = 'http://search.qyer.com/hotel/89580_4.html'

urls = ['http://search.qyer.com/hotel/89580_{}.html'.format(str(i)) for i in range(1,10)] # 最多157页

infos = []

# print(urls)

# 批量爬取数据

def getAUrl(urls):

    data_number = 0

    for url in urls:

        getAttractions(url)

        print('--------------{}-----------------'.format(len(infos)),sep='\n')

# 爬取当页面数据

def getAttractions(url,data = None):

    web_data = requests.get(url)

    time.sleep(2)

    soup = BeautifulSoup(web_data.text,'lxml')

    # print(soup)

    hotel_names = soup.select('ul.shHotelList.clearfix > li > h2 > a')

    hotel_images = soup.select('span[class="pic"] > a > img')

    hotel_points = soup.select('span[class="points"]')

    hotel_introduces = soup.select('p[class="comment"]')

    hotel_prices = soup.select('p[class="seemore"] > span > em')

    if data == None:

        for name,image,point,introduce,price in \

                zip(hotel_names,hotel_images,hotel_points,hotel_introduces,hotel_prices):

            data = {

                'name':name.get_text().replace('\r\n','').strip(),

                'image':image.get('src'),

                'point':re.findall(r'-?\d+\.?\d*e?-?\d*?', point.get_text())[0],

                'introduce':introduce.get_text().replace('\r\n','').strip(),

                'price':int(price.get_text())

            }

            # print(data)

            infos.append(data)

# 根据价格从高到低进行排序

def getInfosByPrice(infos = infos):

    infos = sorted(infos, key=lambda info: info['price'], reverse=True)

    for info in infos:

        print(info['price'], info['name'])

# getAttractions(url)
爬取的网站链接
遇到的问题及解决办法
1.【转载】Python: 去掉字符串开头、结尾或者中间不想要的字符
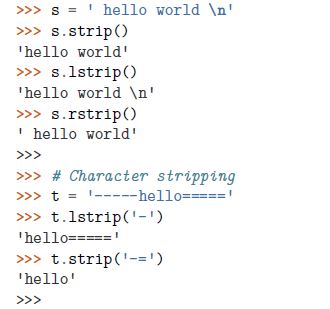
①Strip()方法用于删除开始或结尾的字符。lstrip()|rstirp()分别从左右执行删除操作。默认情况下会删除空白或者换行符,也可以指定其他字符。
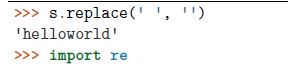
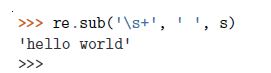
②如果想处理中间的空格,需要求助其他技术 ,比如replace(),或者正则表达式
③strip()和其他迭代结合,从文件中读取多行数据,使用生成器表达式

④更高阶的strip
可能需要使用translate()方法
2. 【转载】Python:object of type 'Response' has no len(),如何解决?
需要下载代码的可以到我的GitHub上下载 https://github.com/FightingBob/-Web-Crawler-training 如果觉得可以,请给我颗star鼓励一下,谢谢!
Python 爬虫练手项目—酒店信息爬取的更多相关文章
- python爬虫练手项目快递单号查询
import requests def main(): try: num = input('请输入快递单号:') url = 'http://www.kuaidi100.com/autonumber/ ...
- [Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息
[Python爬虫] 使用 Beautiful Soup 4 快速爬取所需的网页信息 2018-07-21 23:53:02 larger5 阅读数 4123更多 分类专栏: 网络爬虫 版权声明: ...
- Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(人人网)(下)
Python爬虫教程-13-爬虫使用cookie爬取登录后的页面(下) 自动使用cookie的方法,告别手动拷贝cookie http模块包含一些关于cookie的模块,通过他们我们可以自动的使用co ...
- python网络爬虫(12)去哪网酒店信息爬取
目的意义 爬取某地的酒店价格信息,示例使用selenium在Firefox中的使用. 来源 少部分来源于书.python爬虫开发与项目实战 构造 本次使用简易的方案,模拟浏览器访问,然后输入字段,查找 ...
- Python新手练手项目
1.新手练手项目集中推荐 https://zhuanlan.zhihu.com/p/22164270 2.Python学习网站 https://www.shiyanlou.com 3.数据结构可视化学 ...
- python爬虫学习之使用BeautifulSoup库爬取开奖网站信息-模块化
实例需求:运用python语言爬取http://kaijiang.zhcw.com/zhcw/html/ssq/list_1.html这个开奖网站所有的信息,并且保存为txt文件和excel文件. 实 ...
- PYTHON 爬虫笔记八:利用Requests+正则表达式爬取猫眼电影top100(实战项目一)
利用Requests+正则表达式爬取猫眼电影top100 目标站点分析 流程框架 爬虫实战 使用requests库获取top100首页: import requests def get_one_pag ...
- python爬虫(三) 用request爬取拉勾网职位信息
request.Request类 如果想要在请求的时候添加一个请求头(增加请求头的原因是,如果不加请求头,那么在我们爬取得时候,可能会被限制),那么就必须使用request.Request类来实现,比 ...
- Python爬虫实战(2):爬取京东商品列表
1,引言 在上一篇<Python爬虫实战:爬取Drupal论坛帖子列表>,爬取了一个用Drupal做的论坛,是静态页面,抓取比较容易,即使直接解析html源文件都可以抓取到需要的内容.相反 ...
随机推荐
- hibernate的AnnotationHelloWorld
来龙去脉: 最开始sun这个土鳖设计了EJB2.0.EJB2.1那个时代.后来有人发现设计的很烂,不好用,就设计了hibernate,,人们发现用hibernate反而比EJB2.0.2.1好,hib ...
- php能力自测
最近整理些PHP方面的问题,PHPer可自测自身的功底如何! 查看更多问题 php运行模式 php有几种主要的运行模式?分别使用在那些场景下? gi与fastcgi有什么不同?他们的优缺点有哪些? 如 ...
- SAML 2.0 Profiles--wiki
http://en.wikipedia.org/wiki/SAML_2.0#Web_Browser_SSO_Profile In SAML 2.0, as in SAML 1.1, the prima ...
- C#中的分部类和分部方法:partial
这篇文章主要介绍了C#中的分部类和分部方法,讲解了类的拆分和方法的定义的拆分,需要的朋友可以参考下可以将类或结构.接口或方法的定义拆分到两个或多个源文件中.每个源文件包含类型或方法定义的一部分,编译应 ...
- Spring 学习(五)--- 事务(未完成)
问题 : Spring 事务传播机制是怎么样的,在什么应用场景使用 事务是什么 我们使用的框架可能是Hibernate/JPA或者是Mybatis,都知道的底层是需要一个session/connect ...
- 解决-word里无论怎么改变字体颜色,字体总是红色的
1.你遇到的问题是Word当前处于审阅状态,修改的内容显示为红色字体.2.解决办法是退出Word审阅状态,或者接受全部修订.3.不同Word版本的审阅模式不同,可在菜单栏里退出审阅,或者按鼠标右键弹出 ...
- hashmap的一些基础原理
本文来源于翁舒航的博客,点击即可跳转原文观看!!!(被转载或者拷贝走的内容可能缺失图片.视频等原文的内容) 若网站将链接屏蔽,可直接拷贝原文链接到地址栏跳转观看,原文链接:https://www.cn ...
- SecureCRT远程连接Linux下的sqlplus中退格键不能使用之解决方法
^H不是H键的意思,是backspace 主要是当你的终端backspace有问题的时候才需要设置 在linux环境下使用sqlplus,在回删(backspace)时往往会出现 一串的乱码.出现 ...
- 搭建 Visual Studio 2012 + DXperience-13.2.6 + MySql 开发平台
一. 开发环境 1. 此开发平台主要用来开发基于.NET 4.0及以上版本的应用 2. 点击此下载 Visual Studio 2012 Ultimate 中文版开发工具 3. 点击此下载 DXper ...
- 最短路问题(floyd算法)(优化待续)
问题描述: 最短路问题(short-path problem):若网络中的每条边都有一个数值(长度.成本.时间等),则找出两节点(通常是源节点和阱节点)之间总权和最小的路径就是最短路问题.最短路问题是 ...